
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
ACE-Step: Ein neues Open-Source-Foundation-Modell für Musikgenerierung
小编 ·

ACE-Step: Ein neues Open-Source-Foundation-Modell für Musikgenerierung
Was ist ACE-Step?
ACE-Step ist ein neuartiges Open-Source-Basismodell zur Musikgenerierung, das gemeinsam von ACE Studio und StepFun entwickelt wurde. Es integriert diffusionsbasierte Generierungstechnologie, den Deep-Compression-Autoencoder von Sana sowie einen leichtgewichtigen linearen Transformer und überwindet damit die Einschränkungen bestehender Musikgenerierungsmethoden in Bezug auf Generierungsgeschwindigkeit, musikalische Kohärenz und Kontrollierbarkeit. Das Modell kann auf einer A100-GPU innerhalb von 20 Sekunden bis zu 4 Minuten lange Musik synthetisieren – 15-mal schneller als LLM-basierte Baselines – und erzielt eine bessere musikalische Kohärenz sowie Lyrics-Alignment bei Melodie-, Harmonie- und Rhythmusmetriken. Darüber hinaus unterstützt es fortschrittliche Steuerungsmechanismen wie Sprachklonung und Lyric-Bearbeitung, weist jedoch auch Einschränkungen auf, wie z. B. inkonsistente Ausgaben und eine schwächere Leistung bei bestimmten Stilen.
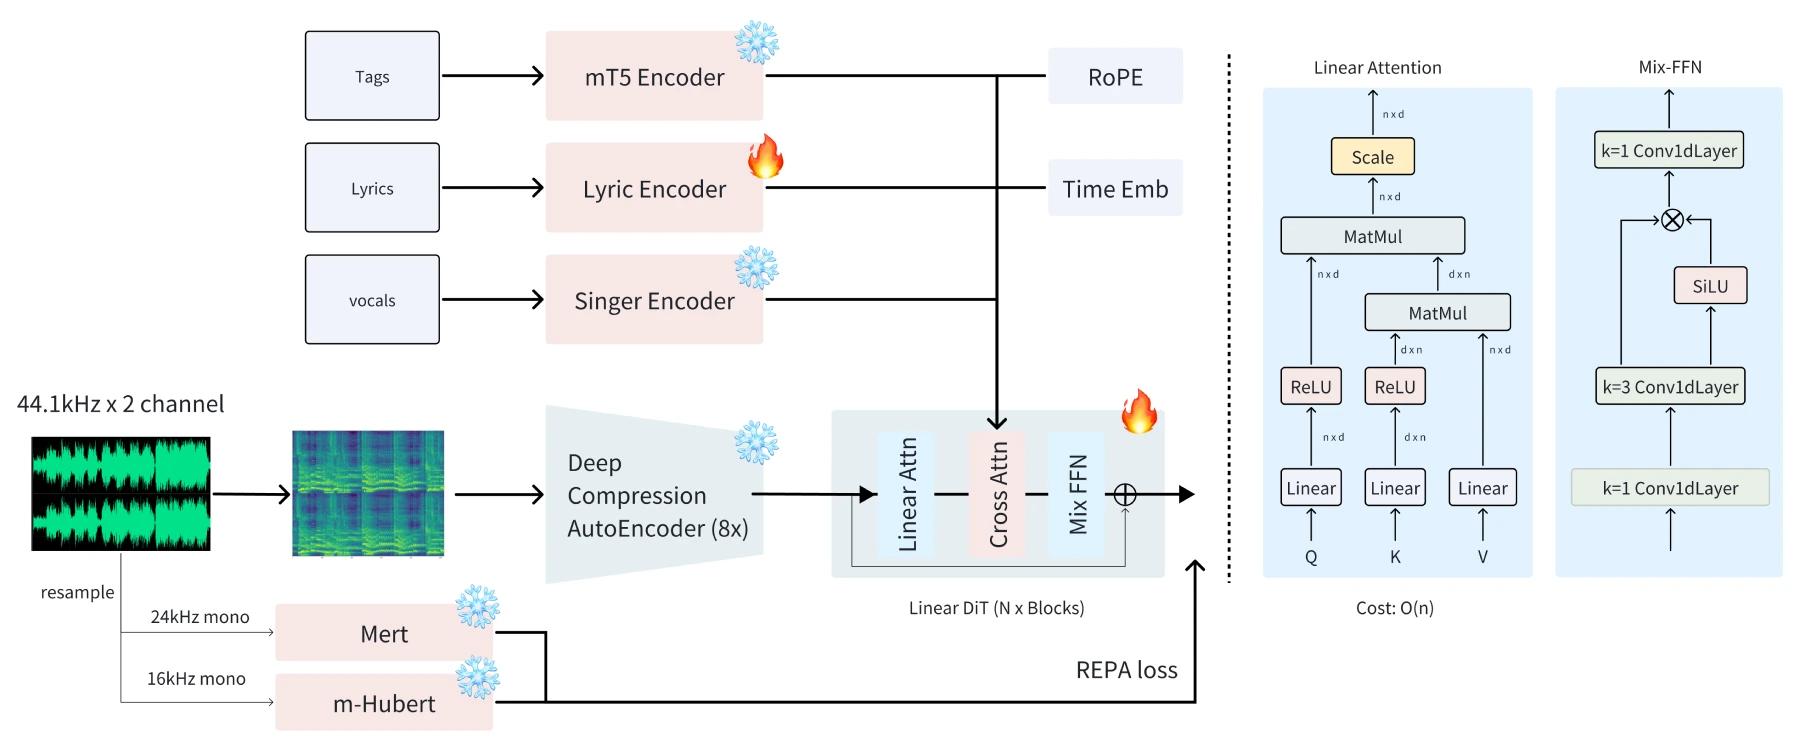
Kernarchitektur von ACE-Step
ACE-Step integriert Diffusionsmodelle, einen Deep-Compression-Autoencoder und leichtgewichtige lineare Transformer und nutzt MERT sowie m-hubert, um semantische Repräsentationen während des Trainings (REPA) abzugleichen, wodurch eine schnelle Konvergenz erreicht wird. Diese Architektur schafft ein Gleichgewicht zwischen Generierungsgeschwindigkeit, musikalischer Kohärenz und Kontrollierbarkeit.
Vorteile von ACE-Step
Generierungsgeschwindigkeit: ACE-Step erzeugt auf einer NVIDIA A100-GPU in nur 20 Sekunden bis zu 4 Minuten lange Musik – 15-mal schneller als Baselines, die auf großen Sprachmodellen (LLMs) basieren.
Musikalische Kohärenz: Das Modell zeigt eine überlegene musikalische Kohärenz und Lyrics-Alignment-Fähigkeit in Bezug auf Melodie-, Harmonie- und Rhythmusmetriken.
Detailerhaltung: ACE-Step bewahrt feinkörnige akustische Details und unterstützt fortschrittliche Steuerungsmechanismen wie Stimmklonung, Lyric-Bearbeitung, Remixing und Track-Generierung.
Funktionsmerkmale von ACE-Step
Vielfältige Stile: Unterstützt gängige Musikstile und verarbeitet verschiedene Beschreibungsformate wie kurze Tags, beschreibende Texte oder Anwendungsszenario-Beschreibungen. Es schneidet auch bei experimentellen Eingabetests gut ab und kann instrumentale Stücke mit verschiedenen Instrumenten erzeugen.
Mehrsprachige Unterstützung: Unterstützt 19 Sprachen, allerdings schneiden einige Sprachen aufgrund unausgeglichener Daten schlechter ab. Die 10 am besten abschneidenden Sprachen sind unter anderem Englisch, Chinesisch und Russisch.
Hohe Kontrollierbarkeit:
Variations Generation: Nutzt trainingsfreie Inferenzzeit-Optimierungstechniken, um durch Anpassung des Mischverhältnisses von Anfangsrauschen und neu hinzugefügtem Gauß-Rauschen Varianten mit unterschiedlicher Ähnlichkeit zum Originalstück zu erzeugen.
Repaint: Durch Hinzufügen von Rauschen zu einer Zielaudio-Eingabe und Anwendung von Maskierungsbedingungen im ODE-Prozess können bestimmte Abschnitte modifiziert werden. In Kombination mit der Variations-Generation-Technik lassen sich lokale Stil-, Lyric- oder Gesangsänderungen realisieren.
Edit: Verwendet die flow-edit-Technik, um Lyrics zu ändern, ohne Melodie, Gesangsfarbe und Hintergrundmusik zu verändern. Es können jedoch jeweils nur kurze Lyric-Abschnitte bearbeitet werden.
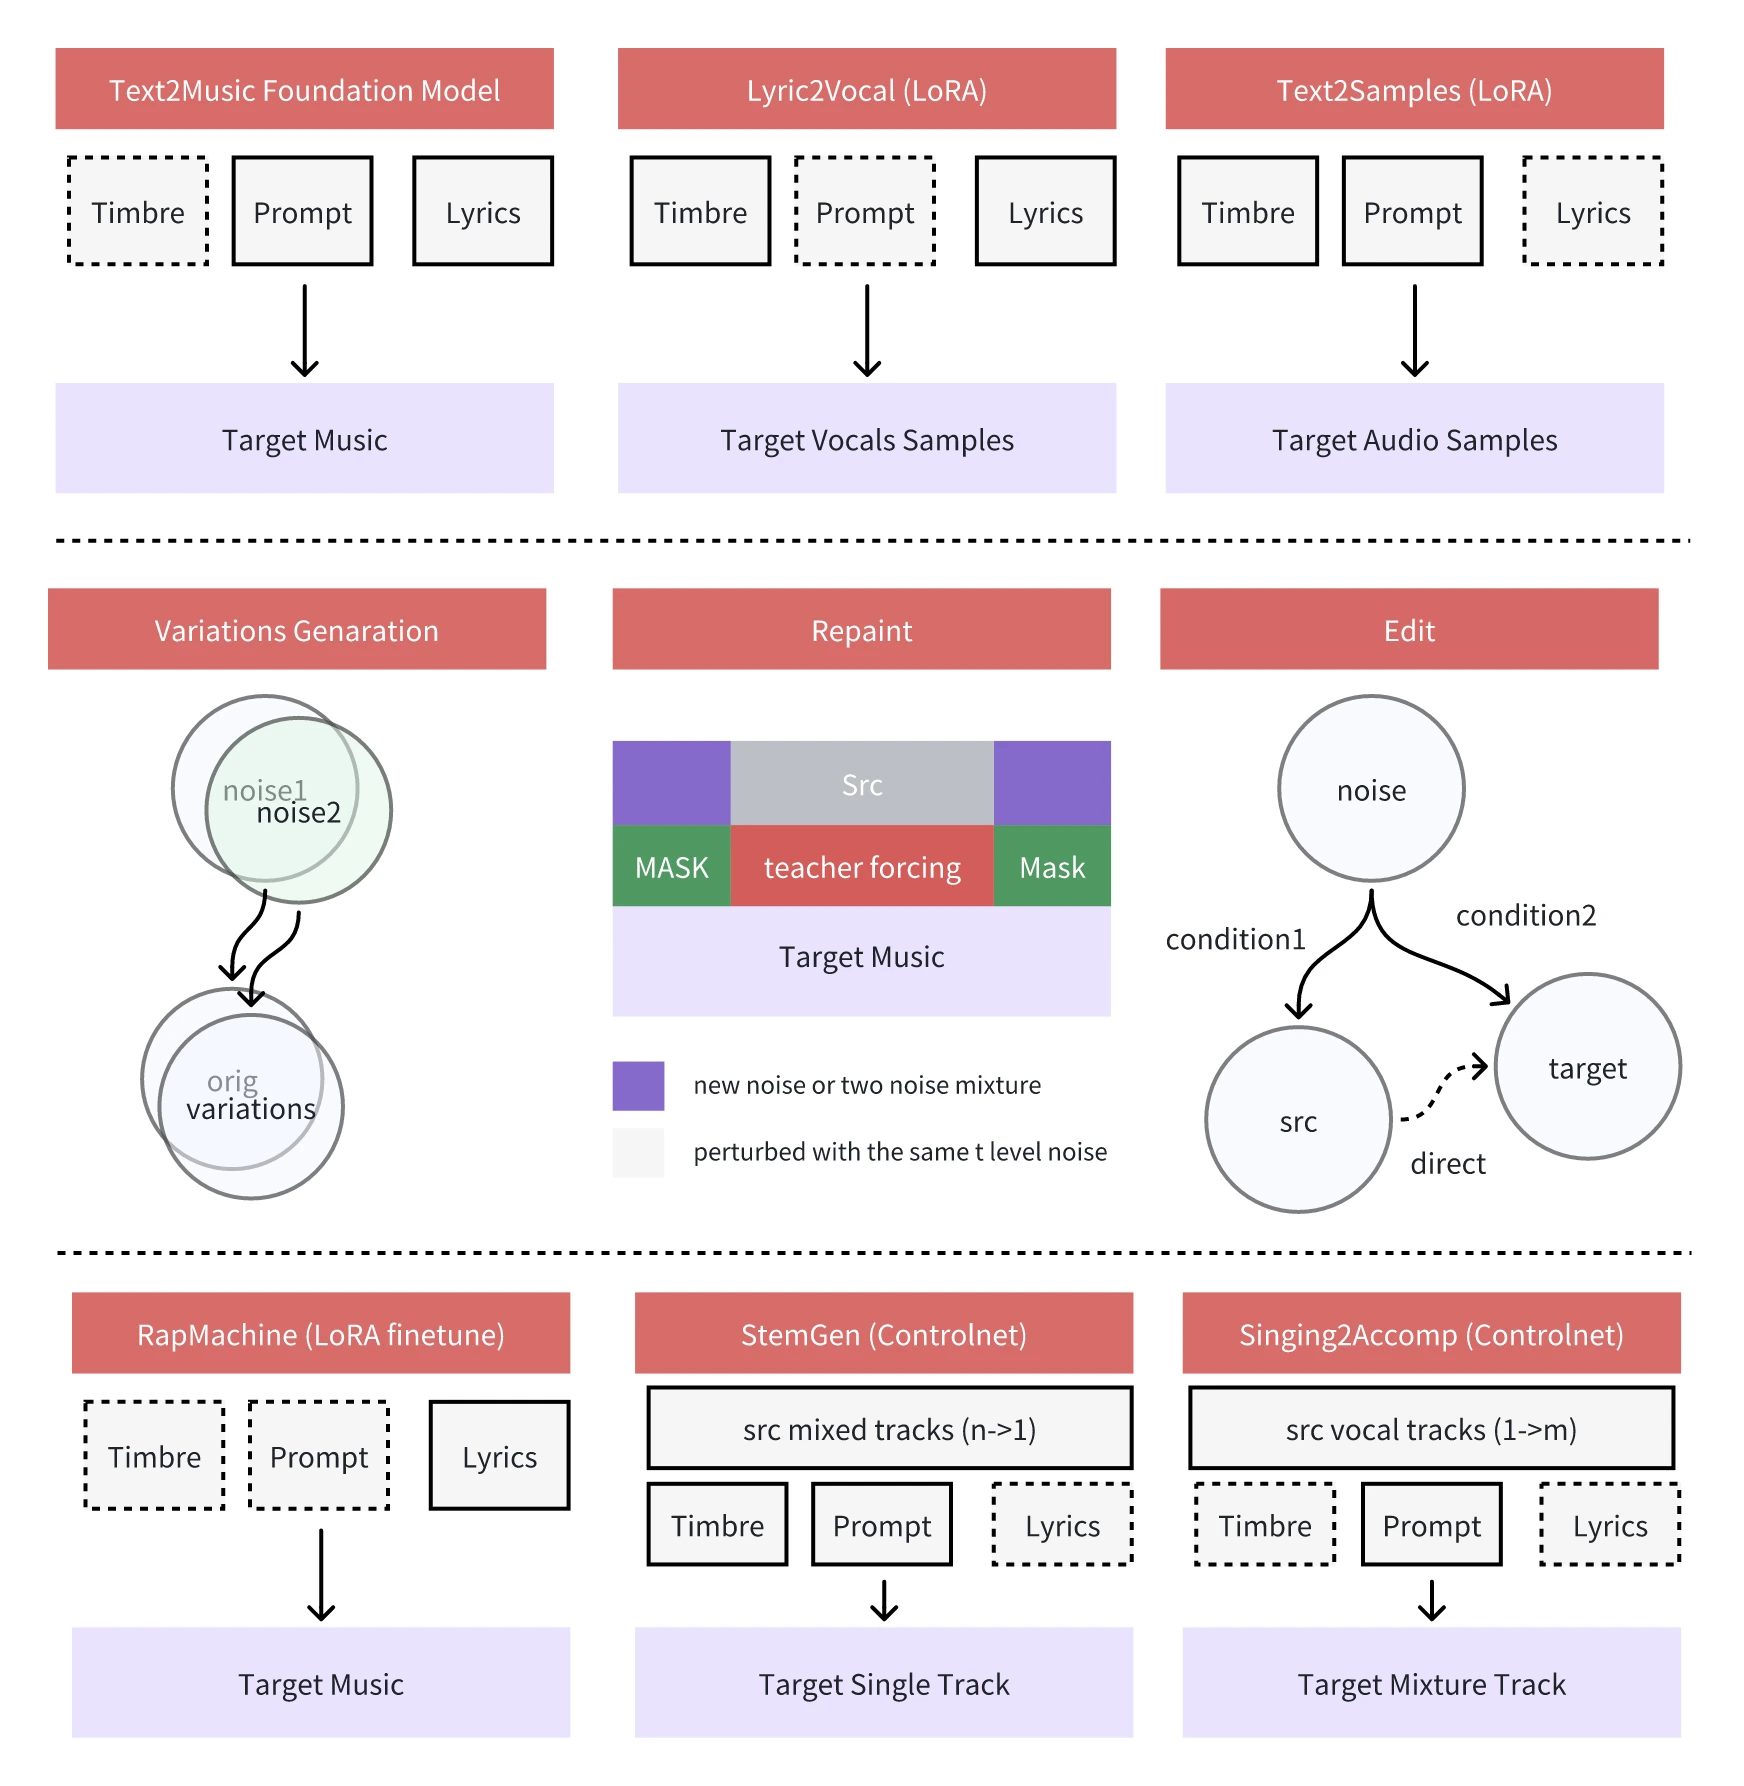
Anwendungsszenarien von ACE-Step
Lyric2Vocal (LoRA): LoRA-Feinabstimmung basierend auf reinen Gesangsdaten, die direkt aus Lyrics Gesangs-Samples erzeugt – für Gesangs-Demos, Songwriting-Hilfen und mehr.
Text2Samples (LoRA): LoRA-Feinabstimmung basierend auf reinen Instrumental- und Sample-Daten, die anhand von Textbeschreibungen konzeptionelle Musikproduktions-Samples erzeugt – zum Erstellen von Instrumental-Loops, Soundeffekten und mehr.
Einschränkungen von ACE-Step
Inkonsistente Ausgaben: Empfindlich gegenüber zufälligen Seeds und Eingabelängen, Ergebnisse sind instabil.
Ungleichmäßige Stilperformance: Schwächere Leistung bei bestimmten Stilen (z. B. chinesischer Rap).
Kontinuitätsprobleme: Unnatürliche Übergänge bei Repaint- oder Erweiterungsoperationen.
Gesangsqualität verbesserungswürdig: Synthetisierter Gesang klingt rau und es fehlen Details.
Unzureichende Steuerungsgranularität: Es wird eine feinere Kontrolle der Musikparameter benötigt.
Optimierung mehrsprachiger Lyrics: Die Unterstützung mehrsprachiger Lyrics muss verbessert werden, um Genauigkeit und Natürlichkeit zu erhöhen.
Häufig gestellte Fragen zu ACE-Step
Was ist der größte Vorteil von ACE-Step im Vergleich zu anderen Musikgenerierungsmodellen?
Antwort: Der größte Vorteil von ACE-Step liegt darin, dass es den Kompromiss zwischen Generierungsgeschwindigkeit, musikalischer Kohärenz und Kontrollierbarkeit bestehender Modelle auflöst. Es kann auf einer A100-GPU innerhalb von 20 Sekunden bis zu 4 Minuten lange Musik synthetisieren – 15-mal schneller als LLM-basierte Baselines – und erzielt gleichzeitig eine bessere musikalische Kohärenz sowie ein besseres Lyrics-Alignment bei Melodie-, Harmonie- und Rhythmusmetriken. Darüber hinaus bietet es leistungsstarke Kontrollfunktionen wie Sprachklonung und Lyric-Bearbeitung, die andere Modelle nur schwer gleichzeitig bieten können.
Welche Probleme gibt es bei der mehrsprachigen Unterstützung von ACE-Step?
Antwort: ACE-Step unterstützt zwar 19 Sprachen, schneidet jedoch bei weniger verbreiteten Sprachen aufgrund unausgeglichener Daten schlechter ab. Bei der Verarbeitung mehrsprachiger Lyrics müssen Genauigkeit und Natürlichkeit weiter verbessert werden. Die Unterstützung für mehrsprachige Lyrics erfordert weitere Optimierung, um die Gesamtleistung des Modells in verschiedenen Sprachen zu steigern.
Für welche kreativen Phasen eignen sich Lyric2Vocal und Text2Samples in den Anwendungsszenarien von ACE-Step?
Antwort: Lyric2Vocal basiert auf einer LoRA-Feinabstimmung mit reinen Gesangsdaten und eignet sich für die Gesangs-Demo-Phase im Songwriting-Prozess. Es hilft Kreativen, die Wirkung gesungener Lyrics schnell zu testen, und kann auch zur Erstellung von Leit-Tracks, als Songwriting-Unterstützung sowie für Gesangs-Arrangement-Experimente eingesetzt werden. Text2Samples basiert auf einer LoRA-Feinabstimmung mit reinen Instrumental- und Sample-Daten und eignet sich für die frühe Phase der Musikproduktion, um schnell Instrumental-Loops, Soundeffekte und verschiedene Musikelemente zu erstellen. Es liefert konzeptionelle Samples für die Musikproduktion und steigert so die kreative Effizienz.
Verwandte Links
https://ace-step.github.io/









