
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
LLMWhisperer: Dokumenten-Parsing-Tool zur Umwandlung komplexer Dokumente in strukturierten Text
小编 ·

LLMWhisperer: Dokumenten-Parsing-Tool zur Umwandlung komplexer Dokumente in strukturierten Text
Was ist LLMWhisperer?
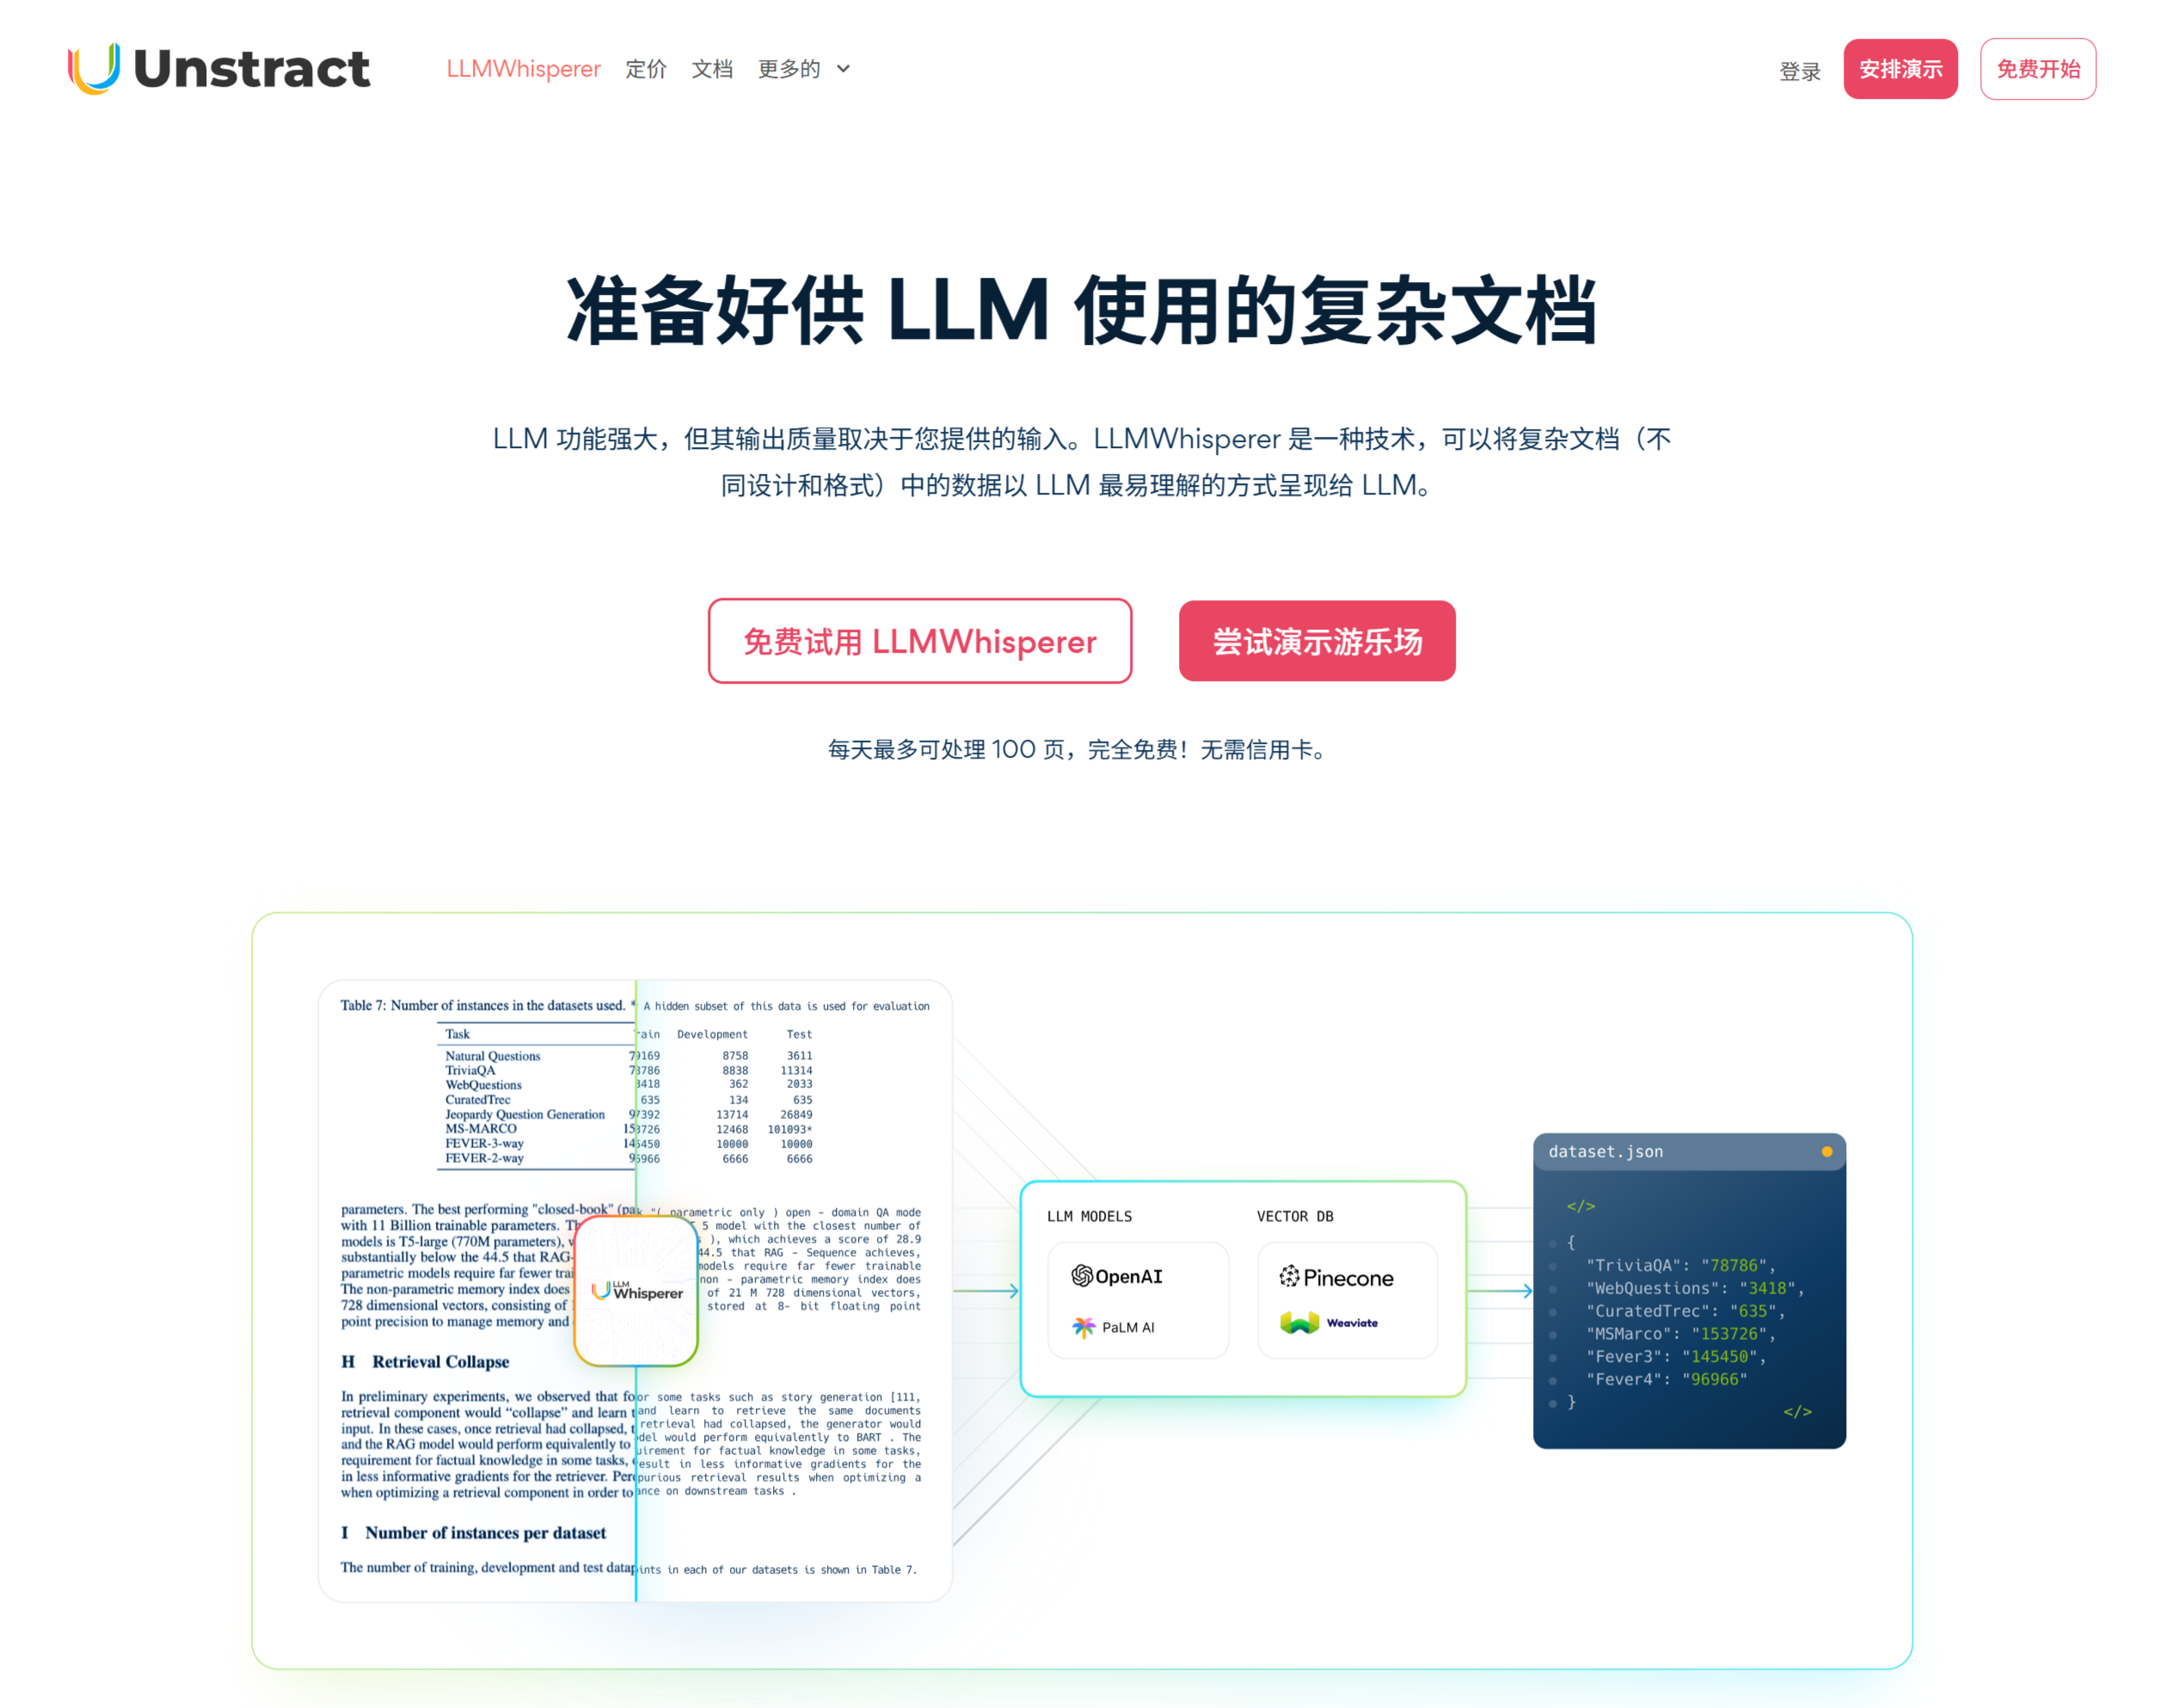
LLMWhisperer ist ein Tool, das komplexe Dokumente in ein LLM-Format parsen kann. Es extrahiert effizient tiefergehende Informationen wie Text, URLs und Metadaten aus Dokumenten und gibt sie in einem klaren, strukturierten Format aus. Es unterstützt verschiedene Formate wie PDF und Bilder und kann wichtige Informationen wie Namen und Adressen automatisch extrahieren. Pro Tag können kostenlos 100 Dokumentseiten verarbeitet werden.
Es bietet außerdem eine Online-Testumgebung, stellt eine API sowie SDKs für JS/Python bereit und lässt sich problemlos mit gängigen Technologien wie Next.js, Node.js und Datenbanken verbinden. Damit lassen sich erhebliche Kosten für die Verarbeitung von Bildeingaben einsparen, und es eignet sich besonders für Szenarien wie Rechnungen, Ausweise und Spesenabrechnungen.
Funktionsmerkmale von LLMWhisperer
Beibehaltung des Dokumentlayouts: Der Layout-Erhaltungsmodus von LLMWhisperer bewahrt die ursprüngliche Struktur des Dokuments, einschließlich Tabellen, Absätzen und mehrspaltigen Layouts, und stellt sicher, dass die extrahierten Daten mit dem Originaldokument übereinstimmen.
Automatischer Moduswechsel: Das Tool kann den Dokumenttyp automatisch erkennen und zwischen dem Textmodus und dem OCR-Modus wechseln. Handelt es sich um gescannte Bilder oder handschriftliche Inhalte, wechselt es automatisch in den OCR-Modus.
Erkennung von Formularelementen: LLMWhisperer kann Kontrollkästchen und Optionsfelder in PDF-Formularen erkennen und deren Werte als Klartext darstellen, sodass sie für LLMs leicht verständlich sind.
Automatische Komprimierung: Bei der Verarbeitung von Dokumenten kann LLMWhisperer unnötige Tokens automatisch komprimieren, wodurch Verarbeitungszeit und -kosten reduziert werden, während die wichtigsten Informationen erhalten bleiben.
Mehrsprachige Unterstützung: LLMWhisperer unterstützt über 300 Sprachen und kann mehrsprachige Dokumente verarbeiten, einschließlich nicht-lateinischer Schriften (wie Arabisch, Chinesisch, Japanisch usw.).
Unterstützung mehrerer Dokumentformate: Unterstützt PDF, Bilder (JPEG, PNG usw.), MS Office-Dateien (Word, Excel, PowerPoint), OpenDocument-Formate (ODT, ODP, ODS) sowie reine Textdateien (TXT).
Verwendung von LLMWhisperer
API-Integration: LLMWhisperer bietet eine API-Schnittstelle, die in bestehende Systeme integriert werden kann, um eine automatisierte Dokumentenvorverarbeitung zu ermöglichen.
Client-Bibliotheken: Benutzer können die Client-Bibliotheken von LLMWhisperer installieren (z. B. llmwhisperer-client für Python), um dessen Funktionen aufzurufen.
Online-Test: LLMWhisperer stellt eine Online-Playground-Umgebung bereit, in der Benutzer Dokumente in Echtzeit hochladen und testen können, ohne sich zu registrieren oder Software zu installieren.
Optimierungsfähigkeiten
Automatischer Moduswechsel: Wenn die Ausgabe im Textmodus bei der Dokumentverarbeitung unzureichend ist, wird automatisch in den OCR-Modus gewechselt.
Automatische Komprimierung: Komprimierung von Markups, die keinen Mehrwert für die Ausgabe bieten, unter Beibehaltung des Layouts, wodurch Verarbeitungszeit und -kosten für LLMs reduziert werden.
Steuerung der Vorverarbeitung: Die Vorverarbeitung gescannter Bilder kann gesteuert werden, wobei Parameter wie Medianfilter und Gaußscher Weichzeichner über die API angepasst werden können.
Offizielle Website:https://unstract.com/llmwhisperer/









