
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Muyan-TTS: ein Open-Source-trainierbares TTS-Modell von Muyan für Podcasts
小编 ·

Muyan-TTS: ein Open-Source-trainierbares TTS-Modell von Muyan für Podcasts
Was ist Muyan-TTS?
Muyan-TTS ist ein Open-Source, trainierbares TTS-Modell, das von Beijing Muyan Zhiyu veröffentlicht wurde und speziell für Podcasts entwickelt wurde, mit einem Budget von unter 50.000 US-Dollar. Muyan-TTS wurde mit mehr als 100.000 Stunden Podcast-Audiodaten vortrainiert, unterstützt Zero-Shot-TTS-Synthese, kann hochwertige Sprache erzeugen und ermöglicht zudem eine Sprecheranpassung durch wenige Dutzend Minuten an Zielsprachaufnahmen.
Modellmerkmale von Muyan-TTS
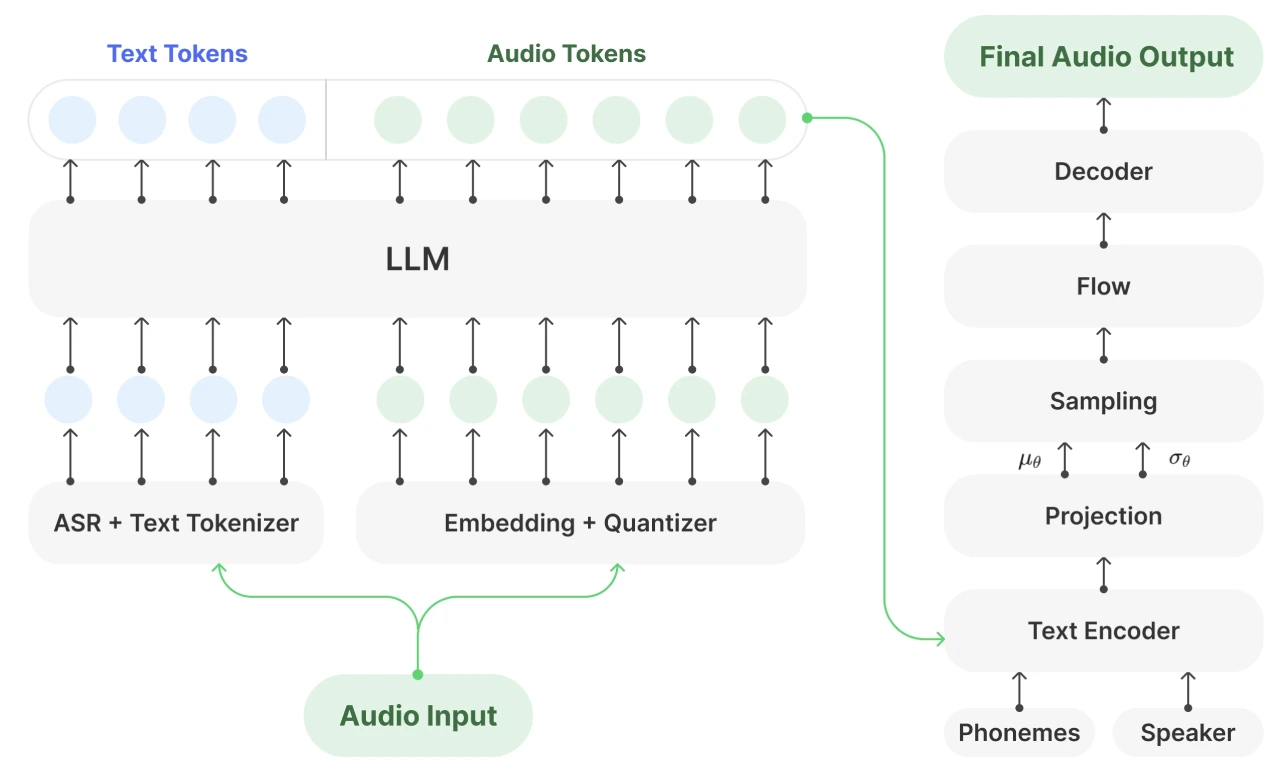
Großskaliges Pre-Training: Muyan-TTS basiert auf dem Llama-3.2-3B-Modell und wurde mit über 100.000 Stunden Podcast-Audiodaten vortrainiert. Es ermöglicht Zero-Shot-Text-zu-Sprache-KI-Synthese und erzeugt hochwertige Sprache.
Unterstützung der Sprecheranpassung: Mit einigen Dutzend Minuten Sprachdaten des Zielsprechers kann sich Muyan-TTS weiter an die Stimmcharakteristika eines bestimmten Sprechers anpassen und so eine hochgradig individualisierte Sprachsynthese realisieren.
Architekturdesign: Muyan-TTS verwendet die zweistufige Struktur von GPT-SoVITS. Der Sprachmodellteil wird mit Llama-3.2-3B als Backbone weiter vortrainiert, während der Decodierer die SoVITS-Architektur nutzt. Dadurch werden die semantischen Modellierungsfähigkeiten des LLM mit den Graphem-zu-Phonem-Eigenschaften (G2P) des VITS-Modells kombiniert, wodurch Halluzinationsphänomene wirksam reduziert werden.
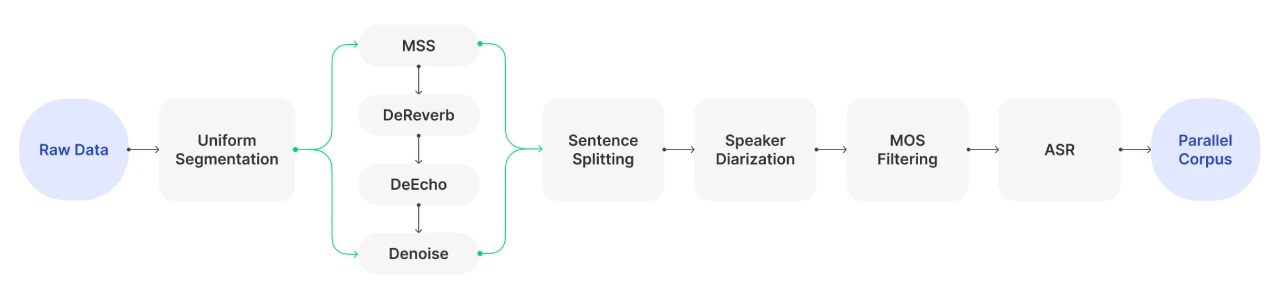
Datenverarbeitung: Es wurde ein paralleler Korpus aufgebaut, der über 100.000 Stunden hochwertiger Sprachaufnahmen mit den zugehörigen Transkriptionen enthält und sich für das TTS-Training in langen Audioszenarien wie Podcasts eignet.
Open Source und Training
Open-Source-Informationen: Muyan-TTS ist vollständig Open Source und bietet einen kompletten Datenerfassungs- und Verarbeitungsprozess, detaillierte Trainingsmethoden sowie ein optimiertes Inferenz-Framework. Der zugehörige Code und die Modelle sind auf GitHub verfügbar.
Trainingskosten: Hinsichtlich der Trainingskosten – unter der Annahme, dass die Mietpreise für A10- und A100-GPUs 0,5 USD bzw. 1 USD pro Stunde betragen – belaufen sich die gesamten Trainingskosten von Muyan-TTS auf etwa 50.540 US-Dollar.
Leistung
Zero-Shot-Synthese: Auf dem LibriSpeech-Datensatz zeigt Muyan-TTS eine hervorragende Zero-Shot-Syntheseleistung. Seine Wortfehlerrate liegt nur knapp hinter CosyVoice2, und der durchschnittliche Meinungswert (MOS) ist höher als der von Spark-TTS und GPT-SoVITS v3.
Überwacht feinabgestimmtes Modell: Das überwacht feinabgestimmte Muyan-TTS-SFT übertrifft das Basismodell in Sprachqualität und Sprecherähnlichkeit, weist jedoch bei der WER einen leichten Rückgang auf.
Inferenzgeschwindigkeit: Muyan-TTS weist unter allen getesteten Modellen die schnellste Inferenzgeschwindigkeit auf und benötigt nur 0,33 Sekunden, um 1 Sekunde Sprache zu synthetisieren – ideal für Echtzeit-Sprachgenerierungsszenarien.
Anwendungsszenarien von Muyan-TTS
Muyan-TTS eignet sich für verschiedene Audioinhaltsformate, wie Moderatorenkommentare, Interview-Reproduktionen oder Sprachzusammenfassungen. Es vereint Synthesequalität, Personalisierungsfähigkeit und Ausführungseffizienz und ist ideal für lange Audioszenarien wie Podcasts.
Einschränkungen
Abhängigkeit vom G2P-Modul im Decodierer: Es wird eine vollständige Phonemsequenz für die Synthese benötigt, sodass keine Streaming-Inferenz möglich ist.
Die Trainingsdaten bestehen hauptsächlich aus Englisch, wodurch die mehrsprachige Sprachsynthesefähigkeit begrenzt ist.
Aufgrund fehlender Annotationen auf Instruktionsebene im Trainingskorpus unterstützt Muyan-TTS derzeit keine instruktionsgeführten TTS-Aufgaben.
Installation und Nutzung von Muyan-TTS
Installationsschritte
1. Repository klonen und virtuelle Umgebung erstellen:
git clone https://github.com/MYZY-AI/Muyan-TTS.git
cd Muyan-TTS
conda create -n muyan-tts python=3.10 -y
conda activate muyan-tts
make build
2. FFmpeg installieren (Ubuntu-System):
sudo apt update
sudo apt install ffmpeg
3. Modelle herunterladen:
Die Modelle Muyan-TTS und Muyan-TTS-SFT können von Hugging Face oder ModelScope heruntergeladen werden.
Zusätzlich müssen die Gewichte von chinese-hubert-base heruntergeladen werden.
Alle heruntergeladenen Modelle sind im Verzeichnis pretrained_models abzulegen.
Nutzungsanleitung
Führen Sie den folgenden Befehl zur Sprachsynthese aus:
python tts.py
Der zentrale Inferenzcode lautet wie folgt:
async def main(model_type, model_path):
tts = Inference(model_type, model_path, enable_vllm_acc=False)
wavs = await tts.generate(
ref_wav_path="assets/Claire.wav",
prompt_text="Although the campaign was not a complete success, it did provide Napoleon with valuable experience and prestige.",
text="Welcome to the captivating world of podcasts, let's embark on this exciting journey together."
)
output_path = "logs/tts.wav"
with open(output_path, "wb") as f:
f.write(next(wavs))
print(f"Speech generated in {output_path}")GitHub-Repository:https://github.com/MYZY-AI/Muyan-TTS









