
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Xiaomi MiMo: Xiaomis erstes Open-Source-LLM für logische Schlussfolgerungen
小编 ·

Xiaomi MiMo: Xiaomis erstes Open-Source-LLM für logische Schlussfolgerungen
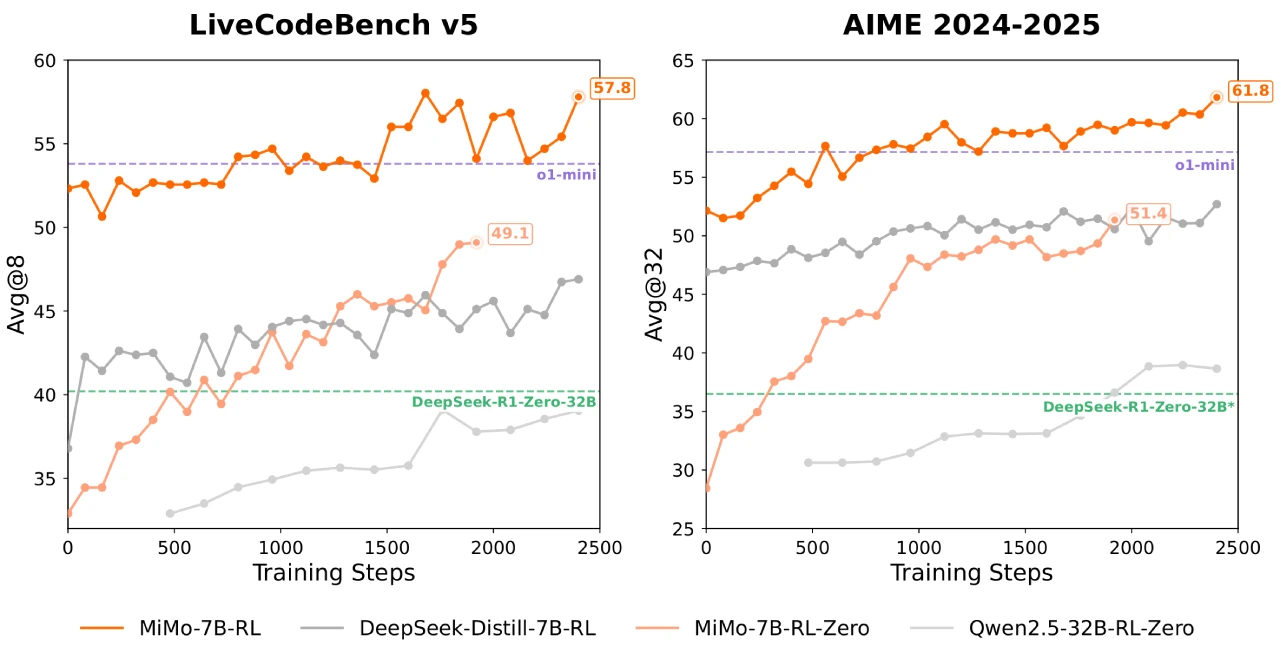
Xiaomi MiMo ist das erste große Modell, das speziell für Schlussfolgerungen entwickelt wurde und am 30. April 2025 von Xiaomi als Open Source veröffentlicht wurdeai. Die Modellreihe MiMo - 7B erschließt das Schlussfolgerungspotenzial von Sprachmodellen vollständig und konzentriert sich nicht nur auf das Nachtraining, sondern auch auf vortrainierte Strategien, die auf Schlussfolgerungen ausgerichtet sind. Mit einer relativ kleinen Größe von 7B zeigt diese Modellreihe Schlussfolgerungsfähigkeiten, die viele 32B-Modelle übertreffen, wobei MiMo - 7B - RL bei Mathematik- und Code-Schlussfolgerungsaufgaben mit OpenAI o1 - mini vergleichbare Leistungen erbringt.
MiMo Kernmerkmale
Vortraining
Optimierung der Datenvorverarbeitung: Verbesserung des Text-Extraktions-Werkzeugkastens, Einsatz mehrdimensionaler Datenfilterung und Erhöhung der Dichte von Schlussfolgerungsmustern in den Vortrainingsdaten.
Erzeugung synthetischer Daten: Verwendung verschiedener Strategien zur Erzeugung großer Mengen vielfältiger synthetischer Schlussfolgerungsdaten.
Dreistufige Datenmischung
Dreistufige Datenmischungsstrategie im Vortraining: MiMo - 7B - Base wird auf etwa 25 Billionen Tokens vortrainiert.
Mehrfach-Token-Vorhersage: Einführung der Mehrfach-Token-Vorhersage als zusätzliches Trainingsziel, um die Modellleistung zu verbessern und die Inferenz zu beschleunigen.
Nachtraining
Hochwertige Trainingsdaten: Sorgfältige Auswahl von 130K Mathematik- und Code-Problemen als RL-Trainingsdaten, wobei jedes Problem sorgfältig bereinigt und hinsichtlich seiner Schwierigkeit bewertet wird, und regelbasierte Verifizierer zur Sicherstellung der Datenqualität eingesetzt werden.
Code-Belohnungsmechanismus: Für anspruchsvolle Code-Probleme wird eine testschwierigkeitsgesteuerte Code-Belohnung eingeführt, die durch die Zuweisung feinkörniger Punktzahlen für Testfälle unterschiedlicher Schwierigkeit die Strategie optimiert.
Daten-Resampling: Implementierung einer Daten-Resampling-Strategie für einfache Probleme zur Verbesserung der Effizienz des rollierenden Samplings und zur Stabilisierung der Strategieaktualisierungen.
RL-Infrastruktur
Nahtlose Rollout-Engine: Entwicklung einer nahtlosen Rollout-Engine, die kontinuierliches Rollout, asynchrone Belohnungsberechnung und vorzeitige Beendigung integriert, um GPU-Leerlaufzeiten zu reduzieren, die Trainingsgeschwindigkeit um das 2,29-fache und die Validierungsgeschwindigkeit um das 1,96-fache zu erhöhen.
MTP-Unterstützung: Unterstützung von MTP in vLLM und Verbesserung der Robustheit der Inferenz-Engine im RL-System.
MiMo Modellversionen
MiMo - 7B - Base: Basismodell mit außergewöhnlichem Schlussfolgerungspotenzial
MiMo - 7B - RL - Zero: RL-Modell, das aus dem Basismodell trainiert wurde
MiMo - 7B - SFT: SFT-Modell, das aus dem Basismodell trainiert wurde
MiMo - 7B - RL: RL-Modell, das aus dem SFT-Modell trainiert wurde, mit einer Leistung, die mit OpenAI o1 - mini vergleichbar ist.
Technische Details und Innovationen
Optimierung der Vortrainingsdaten: Durch mehrdimensionale Datenfilterung und Erzeugung synthetischer Schlussfolgerungsdaten wurden die Qualität der Vortrainingsdaten und die Dichte der Schlussfolgerungsmuster verbessert.
MTP-Modul: Die Einführung des MTP-Moduls im Vortraining verbessert signifikant die Leistung bei Schlussfolgerungsaufgaben sowie die Inferenzgeschwindigkeit.
RL-Infrastruktur: Entwicklung einer Seamless Rollout Engine, die das RL-Training und den Validierungsprozess beschleunigt und Geschwindigkeitssteigerungen um das 2,29-fache bzw. 1,96-fache erzielt.
Testschwierigkeitsgesteuerter Belohnungsmechanismus: Um das Problem der spärlichen Belohnungen bei Code-Problemen zu lösen, wurde ein belohnungsmechanismus basierend auf der Testschwierigkeit vorgeschlagen, der die Lerneffizienz des Modells bei schwierigen Problemen verbessert.
Experimente und Ergebnisse
Leistung des vortrainierten Modells
MiMo-7B-Base: Übertrifft in mehreren Benchmarks andere Open-Source-Modelle mit 7B-Parametern, wie BBH, SuperGPQA usw.
Bewertung des Schlussfolgerungspotenzials: Bewertung des Schlussfolgerungspotenzials des Modells mit der pass@k-Metrik, wobei MiMo-7B-Base in allen Benchmarks höhere pass@k-Werte zeigt.
Leistung des nachtrainierten Modells
MiMo-7B-RL-Zero: Wird direkt aus MiMo-7B-Base mit RL trainiert und zeigt starke Schlussfolgerungsfähigkeiten.
MiMo-7B-RL: Wird aus dem SFT-Modell mit RL trainiert und übertrifft letztendlich OpenAIs o1-mini-Modell bei Mathematik- und Code-Aufgaben.
Spezifische Leistung:
In AIME 2025 erzielt MiMo-7B-RL 55,4 Punkte und übertrifft o1-mini um 4,7 Punkte.
In LiveCodeBench v5 und v6 übertrifft MiMo-7B-RL o1-mini deutlich.
Verwandte Links
Hugging Face Plattform:https://huggingface.co/XiaomiMiMo
GitHub Repository:https://github.com/XiaomiMiMo/MiMo
Technischer Bericht:https://github.com/XiaomiMiMo/MiMo/blob/main/MiMo-7B-Technical-Report.pdf









