
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Alibaba veröffentlicht Qwen3: Dual-Thinking-Modi und Mehrsprachigkeit
小编 ·

Alibaba veröffentlicht Qwen3: Dual-Thinking-Modi und Mehrsprachigkeit
Alibaba hat am 29. April 2025 offiziell die Qwen3-Modellreihe veröffentlicht. Dies ist das neueste Mitglied der Qwen-Serie großer Sprachmodelle. Das Flaggschiff-Modell Qwen3-235B-A22B und das kleinere MoE-Modell Qwen3-30B-A3B sowie mehrere weitere Modelle erzielen hervorragende Ergebnisse in Benchmark-Tests für Code, Mathematik und allgemeine Fähigkeiten. Qwen3 hat mehrere Modellgewichte als Open Source veröffentlicht und ist auf mehreren Plattformen verfügbar.
Qwen3 unterstützt zwei Denkmodi, verfügt über mehrsprachige Fähigkeiten und optimierte Agent- sowie Code-Fähigkeiten. Die Menge der Vortrainingsdaten beträgt etwa 36 Billionen Token, das Vortraining erfolgt in drei Phasen, und das Nachtraining verwendet einen vierstufigen Trainingsprozess.
Modell-Highlights
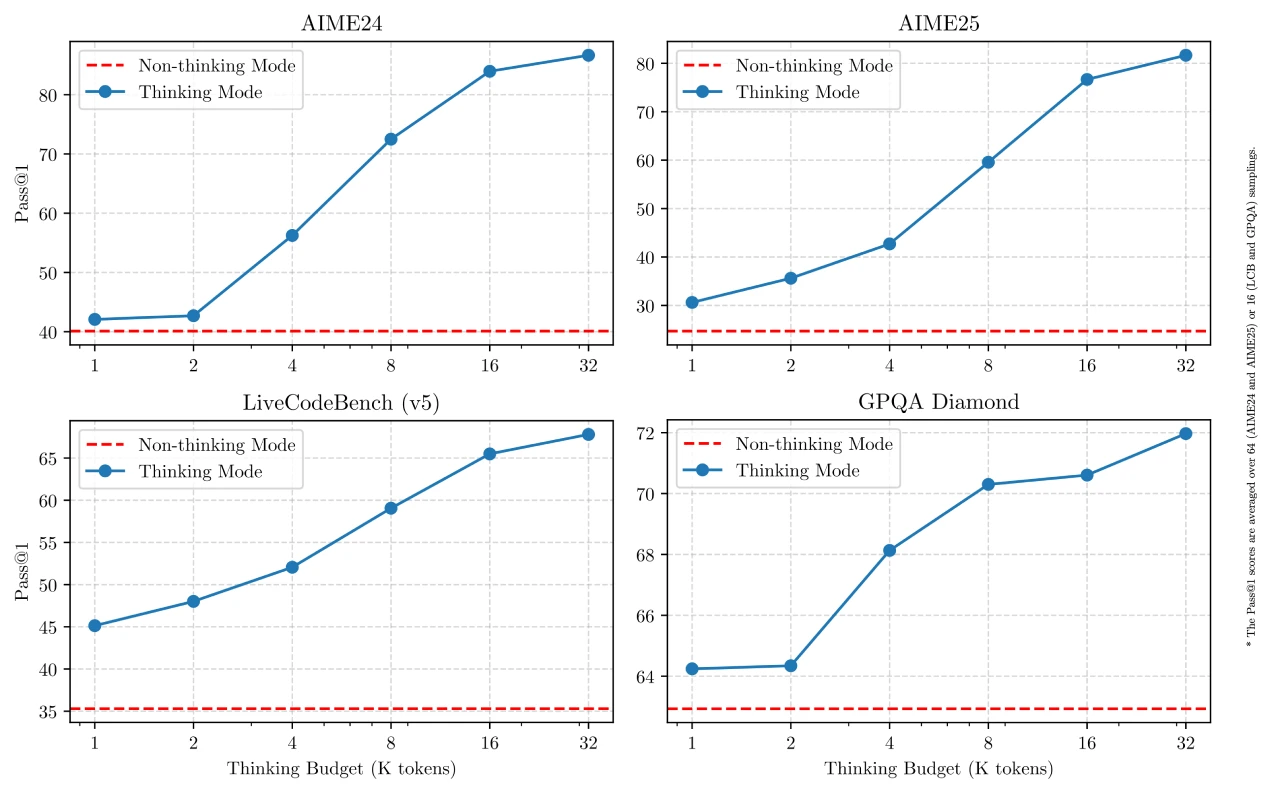
Mehrere Denkmodi: Unterstützt sowohl Denk- als auch Nicht-Denk-Modi. Der Denkmodus eignet sich für komplexe Probleme, bei denen das Modell schrittweise schlussfolgert; der Nicht-Denk-Modus ist für einfache Probleme geeignet und ermöglicht schnelle Antworten. Die Kombination beider Modi erweitert die Steuerungsfähigkeit des „Denkbudgets", das vom Nutzer nach Bedarf konfiguriert werden kann.
Mehrsprachige Fähigkeiten: Unterstützt 119 Sprachen und Dialekte, darunter indogermanische, sino-tibetische und weitere Sprachfamilien, und eröffnet damit Möglichkeiten für internationale Anwendungen.
Verbesserte Agent-Fähigkeiten: Optimierte Agent- und Code-Fähigkeiten mit verstärkter Unterstützung für MCP. Durch Qwen-Agent kann die Code-Komplexität beim Aufruf von Tools reduziert werden.
Leistung von Qwen3
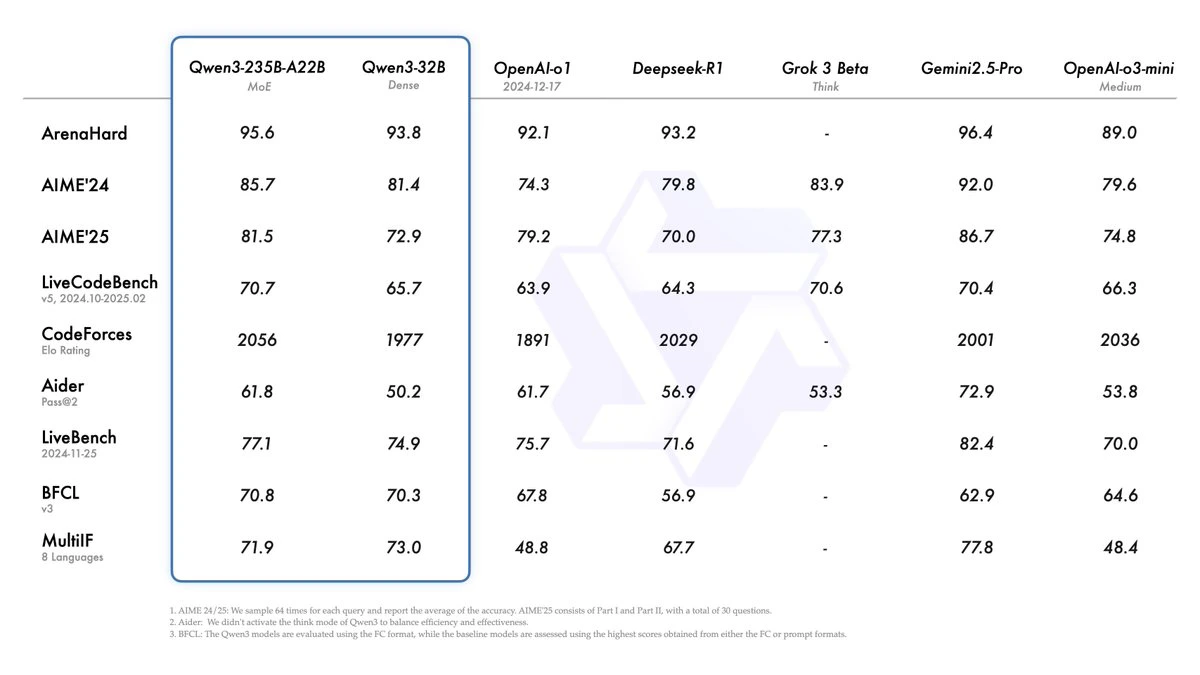
Flaggschiff-Modell: Qwen3-235B-A22B ist das Flaggschiff-Modell der Reihe mit insgesamt über 235 Milliarden Parametern und über 22 Milliarden aktiven Parametern. In Benchmark-Tests für Code, Mathematik und allgemeine Fähigkeiten erzielt dieses Modell äußerst wettbewerbsfähige Ergebnisse im Vergleich zu Top-Modellen wie DeepSeek-R1, den Modellen o1 und o3-mini von Openai, Grok-3 von Musk und Gemini-2.5-Pro von Google.
Kleines Modell: Das kleine MoE-Modell Qwen3-30B-A3B verfügt über 10 % der aktiven Parameter von QwQ-32B, schneidet jedoch besser ab. Darüber hinaus kann ein kleines Modell wie Qwen3-4B mit der Leistung von Qwen2.5-72B-Instruct mithalten.
Technische Eigenschaften von Qwen3
Hybrides Schlussfolgerungsmodell: Qwen3 ist das erste „hybride Schlussfolgerungsmodell" Chinas, das „schnelles Denken" und „langsames Denken" in ein einziges Modell integriert. Dieses Design ermöglicht es dem Modell, bei komplexen Problemen tiefgründig zu schlussfolgern, während es bei einfachen Anfragen schnell reagiert.
Mehrsprachige Unterstützung: Qwen3 unterstützt 119 Sprachen und wurde mit fast 36 Billionen Token trainiert – die doppelte Datenmenge im Vergleich zu Qwen2.5.
Kontextlänge: Qwen3 unterstützt eine Kontextlänge von bis zu 256K, wodurch es in der Lage ist, komplexe Aufgaben wie die Analyse langer Dokumente, Codegenerierung und mehrstufige Dialoge zu bewältigen.
Leistung und Kosten der Qwen3-Modelle
Flaggschiff Qwen3-235B-A22B: Die Gesamtparameteranzahl beträgt 235 Milliarden, die aktiven Parameter 22 Milliarden. Im Vergleich zu DeepSeek-R1 beträgt die Gesamtparameteranzahl nur ein Drittel, und die Bereitstellungskosten können voraussichtlich um mehr als die Hälfte gesenkt werden. Darüber hinaus unterstützt dieses Modell die bedarfsgesteuerte Aktivierung des „Tiefen-Denk"-Modus und kann bereits mit nur 4 H20-GPUs lokal bereitgestellt werden.
Qwen3-30B-A3B: Die Gesamtparameteranzahl beträgt 30 Milliarden, die aktiven Parameter 3 Milliarden, und die Gesamtleistung ist vergleichbar mit Qwen2.5-32B.
Funktionsmerkmale von Qwen3
Native Unterstützung des MCP-Protokolls: Die Qwen3-Serie verfügt über Werkzeugaufruf-Fähigkeiten und kombiniert diese mit dem eigenen Qwen-Agent-Framework, was die Programmierkomplexität erheblich reduziert. Sie unterstützt Agent-Operationen und weitere Aufgaben auf Smartphones und Computern und treibt die KI vom Dialog zur Ausführung voran.
Mehrsprachige Unterstützung: Unterstützt 119 Sprachen, darunter Chinesisch, Englisch, Französisch, Spanisch, Russisch, Arabisch und weitere.
Open-Source-Modelle: Insgesamt 8 Modelle der Qwen3-Serie wurden als Open Source veröffentlicht, darunter:
6 Dense-Modelle: 0.6B, 1.7B, 4B, 8B, 14B, 32B
2 MoE-Modelle: Qwen3-30B-A3B und das Flaggschiff Qwen3-235B-A22B
Kleinstes Modell Qwen3-0.6B: Sehr leichtgewichtig, ideal für die Bereitstellung auf Endgeräten wie Smartphones, während es gleichzeitig gute Verstehens- und Generierungsfähigkeiten beibehält – perfekt für Edge-AI-Anwendungen.
Trainingsprozess
Vortraining: Der Datensatz wurde im Vergleich zu Qwen2.5 deutlich erweitert und umfasst etwa 36 Billionen Token – das Doppelte von Qwen2.5. Die Datenquellen umfassen das Web, PDF-Dokumente und mehr. Mithilfe von Expertenmodellen wurden zusätzlich Mathematik- und Code-Daten synthetisiert. Das Vortraining erfolgt in drei Phasen: vom Training grundlegender Sprachfähigkeiten über die Einbeziehung wissensintensiver Daten bis hin zur Erweiterung der Kontextlänge auf 32K Token.
Nachtraining: Verwendet einen vierstufigen Trainingsprozess, bestehend aus Cold-Start mit langen Chain-of-Thought, Reinforcement Learning mit langen Chain-of-Thought, Denkmodus-Fusion und allgemeinem Reinforcement Learning, um ein hybrides Modell zu entwickeln, das sowohl Denkfähigkeiten als auch schnelle Reaktionsfähigkeit vereint.
Verwendung
Grundlegende Nutzung: Auf Hugging Face stehen Standard-Beispielcodes für die Verwendung von Qwen3-30B-A3B in transformers zur Verfügung. Durch Änderung des Parameters enable_thinking kann der Denkmodus umgeschaltet werden.
Bereitstellung: Mit sglang>=0.4.6.post1 oder vllm>=0.8.4 lässt sich ein mit der OpenAI-API kompatibler API-Endpunkt erstellen. Durch Entfernen bestimmter Parameter kann der Denkmodus deaktiviert werden.
Lokale Entwicklung: Für die lokale Entwicklung können Tools wie ollama, LMStudio, llama.cpp und ktransformers verwendet werden.
Erweiterte Nutzung: Es steht ein Soft-Switch-Mechanismus zur Verfügung, mit dem durch Hinzufügen von /think und /no_think in Benutzer- oder Systemnachrichten der Denkmodus von Runde zu Runde umgeschaltet werden kann.
Zugehörige Links
Blog:https://qwenlm.github.io/zh/blog/qwen3/
HF:https://huggingface.co/collections/Qwen/qwen3-67dd247413f0e2e4f653967f
github:https://github.com/QwenLM/Qwen3
Demo:https://huggingface.co/spaces/Qwen/Qwen3-Demo
Qwen Chat:https://chat.qwenlm.ai









