
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
No-OCR: ein Dokumentenverarbeitungs-Tool ohne OCR-Textextraktion
小编 ·

No-OCR: ein Dokumentenverarbeitungs-Tool ohne OCR-Textextraktion
Was ist No-OCR?
No-OCR ist ein Tool zur Dokumentenverarbeitung, das keine komplexe OCR-Textextraktion benötigt. Durch das Hochladen von PDF-Dateien können Inhalte in mehreren Dokumentsammlungen schnell durchsucht oder abgefragt werden, ohne auf herkömmliche OCR-Technik angewiesen zu sein, was die Effizienz der Dokumentenanalyse steigert. Es unterstützt das Erstellen und Verwalten von PDF-/Dokumentsammlungen, organisiert diese nach „Cases" und erstellt automatisch Datensätze im Hugging-Face-Stil. Darüber hinaus bietet No-OCR eine vektorbasierte Suche in PDF-Seiten und zugehörigen Bildern (mit LanceDB) sowie visuelle Fragebeantwortung für Bilder und Diagramme durch Qwen2-VL. Es unterstützt hybride Suche aus textuellen und visuellen Abfragen, lässt sich schnell per Docker bereitstellen, ist einfach zu konfigurieren und stellt ausführliche Anweisungen für Entwicklung und Installation bereit.
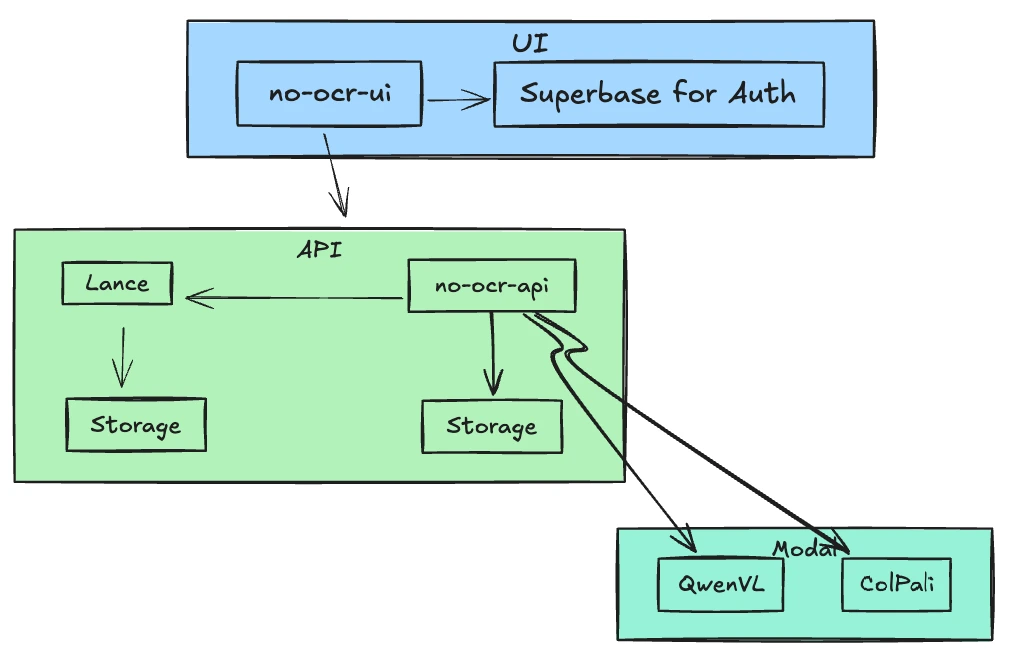
Funktionen von No-OCR
Keine OCR erforderlich: Vollständig unabhängig von OCR-Technik, geeignet für PDF-Dateien mit umfangreichen visuellen Inhalten.
Einfache Bedienung: Nach dem Hochladen von PDF-Dateien kann sofort gesucht werden, einschließlich komplexer visueller Inhalte (wie Tabellen, Diagramme, Layouts usw.).
Open-Source-Modelle: Basiert auf Open-Source-LLMs (Large Language Models) für Inhaltsabruf und -interpretation.
Bereitstellbarkeit: Unterstützt Docker-Deployment und ist für jede Unternehmensumgebung geeignet.
Anwendungsszenarien für No-OCR
Geeignete Szenarien: Wenn Dokumente umfangreiche visuelle Inhalte enthalten (wie Tabellen, Diagramme, Layouts usw.), ist No-OCR eine sehr gute Wahl.
Ungeeignete Szenarien: Wenn Dokumente hauptsächlich reinen Text enthalten, ist die herkömmliche BM25-Suche möglicherweise besser geeignet.
Gemischte Inhalte: Wenn Dokumente eine Mischung aus Text und visuellen Inhalten enthalten, muss die Lösung möglicherweise an die Anforderungen angepasst werden.
Architekturdesign von No-OCR
Einfache Architektur: Keine Abhängigkeit von Datenbanken oder Message Queues, alle Persistenzoperationen basieren auf dem Dateisystem.
Hauptdienste:
Modal: Für das Deployment von LLMs.
Qdrant: Für die Multi-Vektor-Suche.
Supabase: Für Benutzerauthentifizierung und -autorisierung.
Cases erstellen: Benutzer laden PDF-Dateien hoch und geben einen Case-Namen an. Das System konvertiert die PDFs in einen Datensatz und lädt diesen in Qdrant hoch.
Suchablauf: Der Benutzer gibt eine Suchanfrage ein, das System identifiziert relevante Seiten über das LLM und interpretiert die Inhalte.
LLM-Modelle von No-OCR
ColPali-Familie: Für die Bildsuche, wandelt Bilder in ein durchsuchbares Format um.
Qwen2-VL-Familie: Für das Schlussfolgern über visuelle Inhalte, insbesondere das Modell Qwen2-VL-7B-Instruct, eines der derzeit fortschrittlichsten Open-Source-Vision-Modelle.
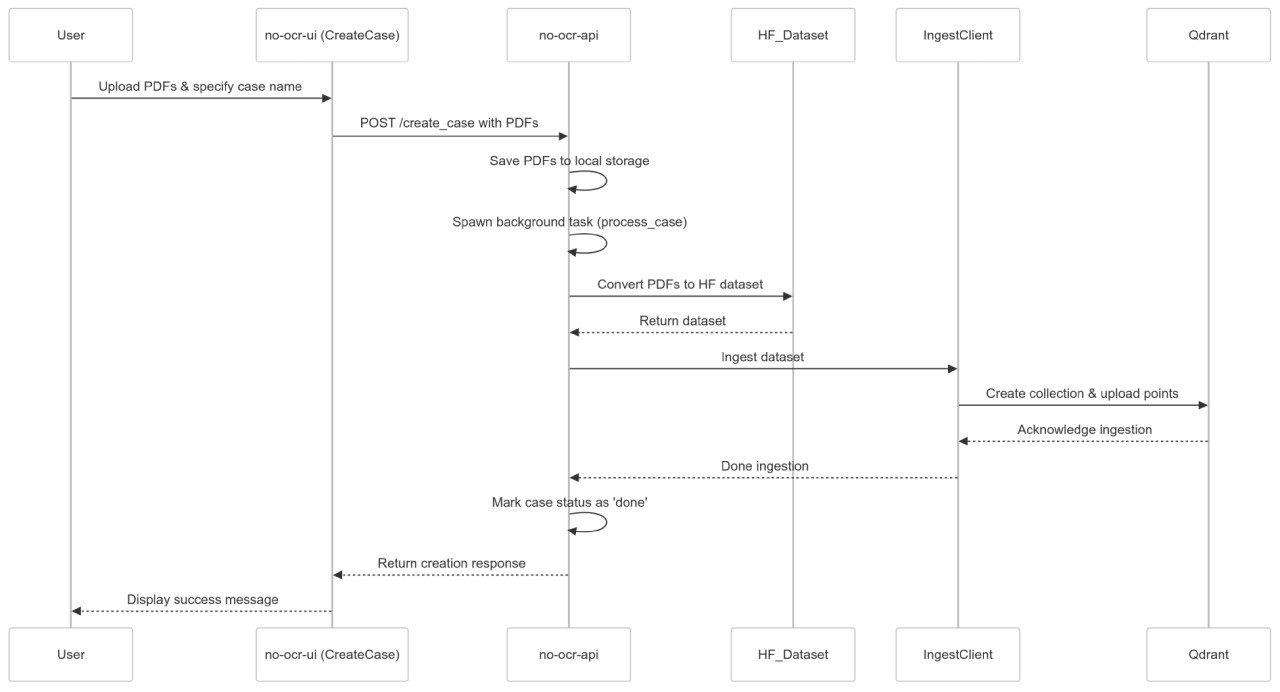
Case-Erstellungsablauf
Arbeitsweise
Die No-OCR-Plattform verwendet einen vereinfachten RAG-Ansatz. Benutzer müssen lediglich PDF-Dateien hochladen, um einen Case zu erstellen. Das System verarbeitet diese Dateien und macht sie durchsuchbar. Benutzer können beliebige Fragen stellen, auch zu visuellen Elementen, und die Plattform nutzt Top-Open-Source-Reasoning-Modelle, um Antworten zu liefern.
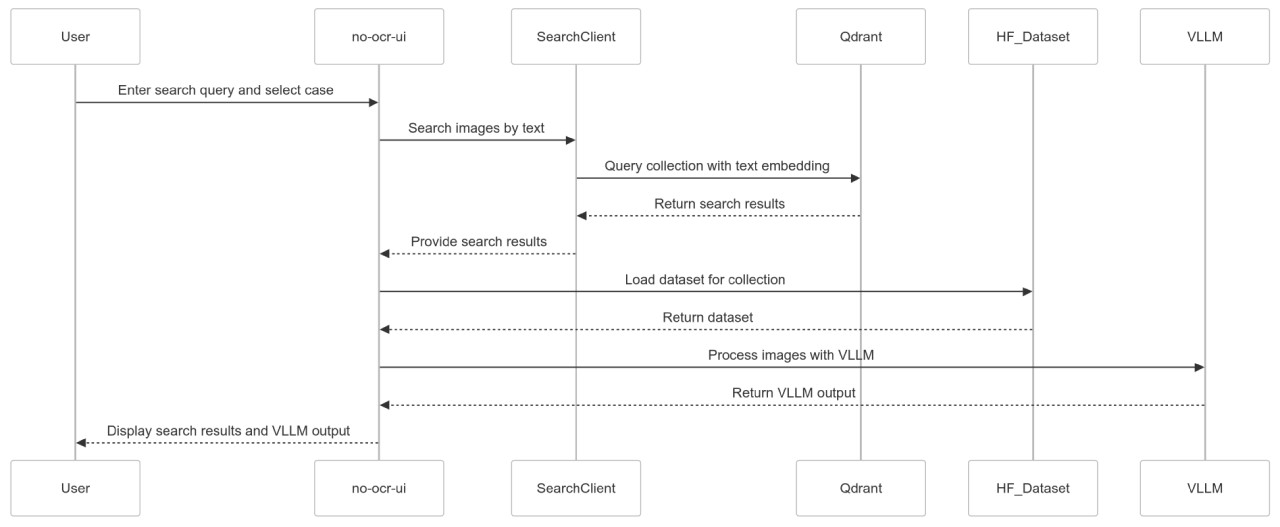
Suchablauf
Schritte zur Nutzung von No-OCR
Komplexe PDFs hochladen und verarbeiten: Benutzer laden anspruchsvolle PDF-Dateien hoch, um einen neuen Case zu erstellen. Das System erzeugt Embeddings ohne komplexe OCR-Verarbeitung.
Durchsuchbar machen: Nach der Verarbeitung können Benutzer textbasierte Abfragen ausführen und schnell relevante Seiten und Verweise finden, unabhängig davon, wie komplex das PDF-Layout ist.
Visuelle Fragen stellen: Die Plattform lokalisiert schnell relevante Seiten und verfeinert die Antworten anschließend mithilfe spezialisierter Open-Source-Vision-Modelle. Auch wenn das PDF Diagramme oder Schaubilder enthält, liefert sie kontextbezogene Erkenntnisse.
TLDR:https://no-ocr.com/about
Github:https://github.com/kyryl-opens-ml/no-ocr









