
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Video-R1: Das weltweit erste Video-R1-Modell, vorgestellt von der CUHK und der Tsinghua-Universität
小编 ·

Video-R1: Das weltweit erste Video-R1-Modell, vorgestellt von der CUHK und der Tsinghua-Universität
Was ist Video-R1?
Video-R1 ist das weltweit erste R1-Modell für Videos, das gemeinsam von der Chinese University of Hong Kong und der Tsinghua-Universität entwickelt wurde. Es kann die Video-Reasoning-Fähigkeiten multimodaler großer Sprachmodelle (MLLMs) durch Reinforcement Learning verbessern.
Funktionen von Video-R1
Zeitbewusstes Reasoning: Video-R1 führt den T-GRPO-Algorithmus ein, der durch den Vergleich von unsortiert und sortiert eingegebenen Videobildern das Modell dazu anregt, zeitliche Informationen für das Reasoning zu nutzen, um zeitliche Zusammenhänge in Videos besser zu verstehen.
Training mit gemischten Daten: Um das Problem der Knappheit hochwertiger Video-Reasoning-Daten zu lösen, verwendet Video-R1 einen gemischten Datensatz aus Bildern und Videos, einschließlich Video-R1-COT-165k (für SFT Cold Start) und Video-R1-260k (für RL-Training), sodass das Modell von statischen Bild-Reasoning-Fähigkeiten auf dynamisches Video-Reasoning übertragen kann.
Verschiedene Ausgabetypen: Video-R1 unterstützt mehrere Arten von Antwortausgaben, darunter Multiple Choice, numerische Werte, OCR, Freiform und Regression.
Selbstreflexions-Reasoning-Verhalten: Das Modell reflektiert sich während des Reasoning-Prozesses selbst und passt die Reasoning-Richtung an, um genauere Schlussfolgerungen zu ziehen. Dieser „Aha-Moment" zeigt, dass das Modell aktiv interne Feedback-Schleifen durchführt.
Technologie von Video-R1
Zeitbewusster Algorithmus T-GRPO: Dieser Algorithmus verbessert die Fähigkeit des Modells, Zeitreihen zu verstehen, und ermöglicht es dem Modell, über kausale Zusammenhänge zwischen Ereignissen tief nachzudenken. Im Vergleich zum herkömmlichen GRPO-Algorithmus bindet T-GRPO das Zeitverständnis durch einen Belohnungsmechanismus, sodass das Modell nur dann eine Belohnung erhält, wenn es bei sortierter Eingabe einen höheren Anteil an Fragen richtig beantwortet.
Gemischter Bild-Video-Datensatz: Die Forscher haben zwei hochwertige Datensätze erstellt: Video-R1-COT-165k (hauptsächlich Bilder) und Video-R1-260k (mit hochwertigen Videos im Kern), um das Problem der Knappheit von Video-Reasoning-Daten zu lösen. Diese gemischte Trainingsmethode ermöglicht es dem Modell, sich vom „Bilder beschreiben" zum „tiefes Videoverständnis" weiterzuentwickeln und echtes multimodales Verständnis zu erreichen.
Reinforcement-Learning-Trainingsstrategie: Video-R1 wird durch Reinforcement Learning trainiert, wobei das Modell im Trainingsprozess nach und nach suboptimale Reasoning-Muster verwirft und effizientere, logischere Ausdruckswege entwickelt.
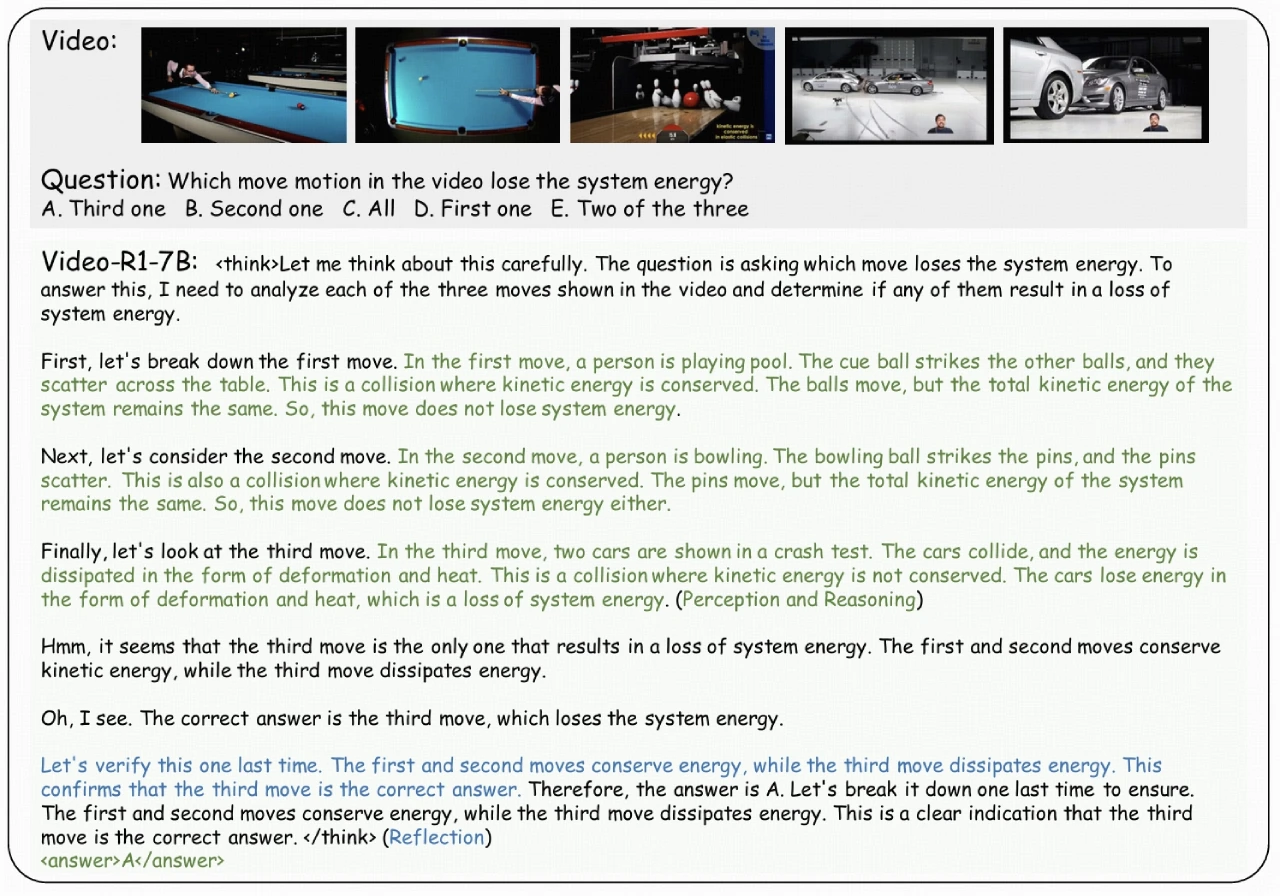
Anwendungen von Video-R1
Analyse von Videoinhalten: Video-R1 kann dynamische Inhalte in Videos effizient analysieren und verstehen und eignet sich für Funktionen wie die automatische Erstellung wichtiger Videoclips, Verhaltenserkennung und die Generierung intelligenter Tags.
Videosuche und -empfehlung: Durch tiefes Reasoning kann Video-R1 die Bedürfnisse der Nutzer präziser verstehen und Videoinhalte empfehlen, die den Interessen der Nutzer besser entsprechen.
Visuelles Verstehen für autonomes Fahren: Das Modell kann zeitliche Zusammenhänge und kausale Logik in Videos verstehen und hilft autonomen Fahrsystemen, die Straßenumgebung besser wahrzunehmen und vorherzusagen.
Videoüberwachung und Sicherheit: Video-R1 kann zur Echtzeitanalyse von Überwachungsvideos eingesetzt werden, um anormale Verhaltensweisen oder Ereignisse schnell zu erkennen und die öffentliche Sicherheit zu verbessern.
Bildung und Training: Im Bildungsbereich kann Video-R1 in intelligenten Tutoring-Systemen eingesetzt werden, um durch die Analyse von Lehrvideoinhalten personalisierte Lernempfehlungen für Schüler zu geben.
Smart Home: Das Modell kann in Smart-Home-Systeme integriert werden und durch Videoanalyse intelligentere Umgebungswahrnehmung und Automatisierungssteuerung ermöglichen.
GitHub-Adresse:https://github.com/tulerfeng/Video-R1
Paper:https://arxiv.org/abs/2503.21776









