
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
PDF Document Layout Analysis: Ein Docker-basierter PDF-Layoutanalyse- und PDF-OCR-Dienst
小编 ·

PDF Document Layout Analysis: Ein Docker-basierter PDF-Layoutanalyse- und PDF-OCR-Dienst
Was ist PDF Document Layout Analysis?
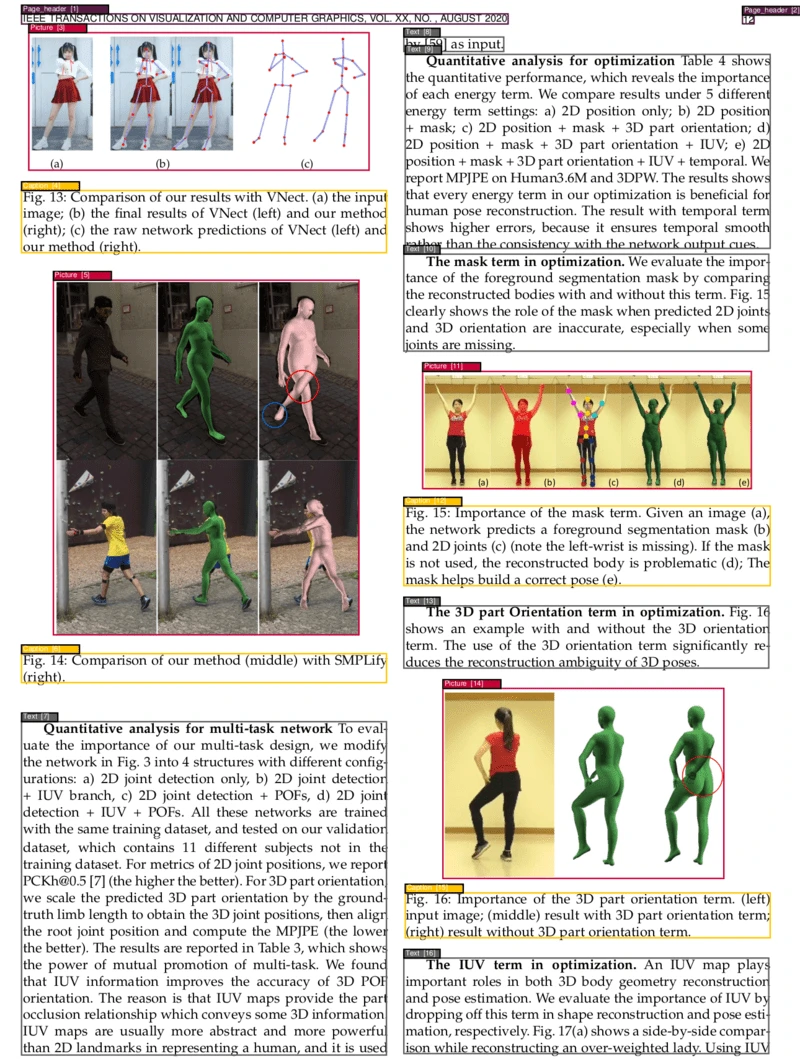
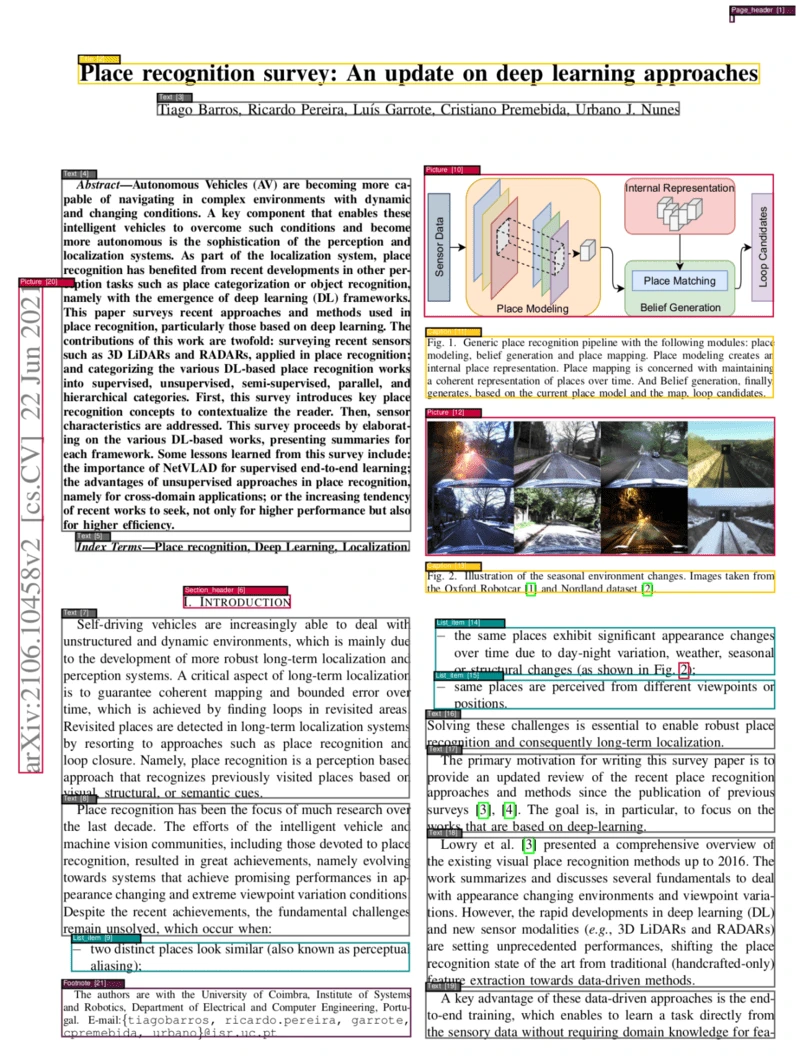
PDF Document Layout Analysis ist ein Docker-basierter Dienst zur Analyse des Layouts von PDF-Dokumenten. Er kann verschiedene Bereiche einer PDF-Seite segmentieren und klassifizieren und identifiziert automatisch und präzise Elemente wie Text, Überschriften, Bilder, Tabellen usw. in PDF-Seiten sowie deren korrekte Reihenfolge.
Funktionsmerkmale von PDF Document Layout Analysis
1. OCR-Funktion
Mehrsprachige Unterstützung: Unterstützt OCR in mehreren Sprachen. Benutzer können durch Angabe eines Sprachparameters PDF-Dokumente in verschiedenen Sprachen verarbeiten.
Textextraktion: Konvertiert Bilder oder nicht durchsuchbaren Text in PDFs in ein durchsuchbares Textformat, was die Weiterverarbeitung und Analyse erleichtert.
2. Seitensegmentierung und -klassifizierung
Erkennung mehrerer Elemente: Erkennt und klassifiziert verschiedene Elemente in PDF-Seiten:
Text: Normaler Textinhalt.
Überschriften: Titel und Zwischenüberschriften des Dokuments.
Bilder: Grafiken auf der Seite.
Tabellen: Tabelleninhalte.
Formeln: Mathematische Formeln, unterstützt LaTeX-Ausgabe.
Listenelemente: Geordnete oder ungeordnete Listen.
Kopf- und Fußzeilen: Kopf- und Fußzeilen der Seite.
Fußnoten: Fußnoten im Dokument.
Sonstiges: z. B. Bildunterschriften, Tabellenüberschriften usw.
Präzise Klassifizierung: Verwendet fortschrittliche visuelle Modelle (wie Vision Grid Transformer - VGT) und Machine-Learning-Modelle (wie LightGBM), um hochpräzise Klassifizierungsergebnisse sicherzustellen.
3. Elementsortierung
Logische Reihenfolge: Bestimmt automatisch die logische Reihenfolge der Elemente basierend auf dem Seitenlayout und dem Elementtyp, sodass das Ausgabeergebnis der Lesereihenfolge des Dokuments entspricht.
Benutzerdefinierte Sortierregeln: Kombiniert die anfängliche Lesereihenfolge von Poppler mit Absatztypen, um Elemente zu sortieren und so logische und kohärente Ausgaben sicherzustellen.
4. Visualisierungsausgabe
Visualisiertes PDF: Unterstützt die Visualisierung der Analyseergebnisse als neue PDF-Datei, sodass Benutzer die Segmentierungs- und Klassifizierungsergebnisse intuitiv anzeigen können.
Markierungsfunktion: In der Visualisierungsausgabe werden verschiedene Elementtypen mit unterschiedlichen Farben oder Stilen markiert, um sie leicht unterscheiden zu können.
5. Tabellen- und Formelextraktion
Tabellenextraktion: Unterstützt die Extraktion von Tabellen in verschiedene Formate wie Markdown, LaTeX oder HTML zur Weiterverarbeitung und Analyse.
Formelextraktion: Formeln werden im LaTeX-Format ausgegeben, was die Verwendung in wissenschaftlichen und technischen Dokumenten erleichtert.
Anwendungsbereiche von PDF Document Layout Analysis
Wissenschaftliche Forschung: Extraktion und Organisation von Text, Abbildungen, Tabellen und Referenzen aus Forschungsarbeiten zur Erleichterung von Literaturrecherchen und Datenanalyse.
Analyse juristischer Dokumente: Analyse und Strukturierung juristischer Dokumente, Verträge und Fallakten.
Geschäftsberichte: Automatisierte Extraktion von Finanzdaten, Diagrammen und Schlüsselkennzahlen zur einfacheren Gewinnung von Erkenntnissen und Zusammenfassungen.
Archive und Digitalisierung: Digitalisierung und Klassifizierung historischer Dokumente, Manuskripte und Archive in einem leicht durchsuchbaren Format.
Verlagswesen und Medien: Organisation und Formatierung von Manuskripten, Artikeln und Berichten zur Gewährleistung von Konsistenz und Qualität.
Schnellstart
Dienst ausführen: Unterstützt GPU- und Nicht-GPU-Modus.
OCR-Funktion: Unterstützt mehrere Sprachen und wird über curl-Befehle aufgerufen.
Segmentierungsergebnisse abrufen: Senden Sie PDF-Dateien über curl-Befehle, um die segmentierten Ergebnisse zu erhalten.
Dienst beenden: Bietet Befehle zum Stoppen des Servers.
Abhängigkeiten und Anforderungen
Docker Desktop: Docker Desktop 4.25.0 oder höher muss installiert sein.
GPU-Unterstützung: Für GPU-Beschleunigung muss die entsprechende GPU-Unterstützungssoftware installiert sein.
Hardwareanforderungen: Mindestens 2 GB RAM erforderlich; bei Verwendung einer GPU werden 5 GB GPU-Speicher benötigt.
Modelle
Vision-Modell (Vision Grid Transformer - VGT): Das Standardmodell, trainiert vom Alibaba-Forschungsteam, unterstützt komplexere Layoutanalysen, benötigt jedoch mehr Ressourcen.
LightGBM-Modell: Nicht-visuelles Modell, das die mit Poppler extrahierten XML-Informationen zur Klassifizierung und Segmentierung verwendet. Es ist schneller und ressourcenschonender.
Daten
Trainingsdaten: Verwendet den DocLayNet-Datensatz mit 11 Kategorien wie Überschriften, Fußnoten, Formeln, Listenelementen usw.
Verwendung
Grundlegende Befehle: Senden Sie PDF-Dateien über curl-Befehle und wählen Sie zwischen visuellem oder nicht-visuellem Modell.
Visualisierungsausgabe: Unterstützt die Visualisierung der Analyseergebnisse als PDF-Datei.
Tabellen- und Formelextraktion: Unterstützt die Extraktion von Tabellen und Formeln in verschiedenen Formaten (z. B. LaTeX, Markdown).
Ausgabereihenfolge
Sortierregeln: Sortierung basierend auf der anfänglichen Lesereihenfolge von Poppler und dem Absatztyp, um eine logische Ausgabereihenfolge sicherzustellen.
Leistung und Geschwindigkeit
Leistung: Das VGT-Modell erzielt auf dem PubLayNet-Datensatz hervorragende Ergebnisse mit einer durchschnittlichen Genauigkeit von über 96 %.
Geschwindigkeit: Das nicht-visuelle Modell verarbeitet auf der CPU 0,42 Sekunden pro Seite, das visuelle Modell auf der GPU 1,75 Sekunden und auf der CPU 13,5 Sekunden.
Verwandte Links
GitHub: https://github.com/huridocs/pdf-document-layout-analysis
DockerHub: https://hub.docker.com/r/huridocs/pdf-document-layout-analysis









