
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
UNO: Ein Multi-Subject-Bildgenerierungsmodell mit Bedingungen von ByteDance
小编 ·

UNO: Ein Multi-Subject-Bildgenerierungsmodell mit Bedingungen von ByteDance
Was ist UNO?
UNO ist ein von der Forschungsabteilung von ByteDance entwickeltes Multi-Subject-Bedingungsbildgenerierungsmodell, das durch die Kontextgenerierungsfähigkeit eines Diffusion Transformers hochkonsistente Multi-Subject-Paardaten erzeugt.
Kernmerkmale von UNO
Multi-Bild-Bedingungsgenerierung: Unterstützt die Bildgenerierung mit einem oder mehreren Subjekten und kann neue Bilder auf Basis eines oder mehrerer Referenzbilder erzeugen.
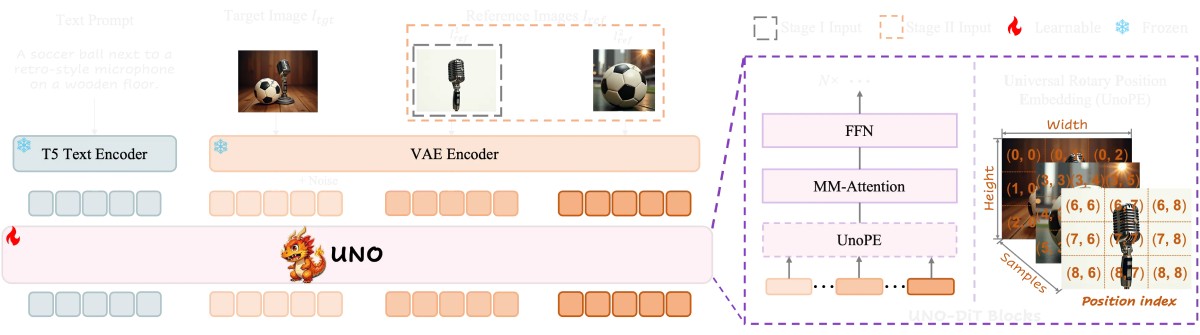
Progressive Cross-Modal Alignment: Verbessert die Generierungskonsistenz durch schrittweise Ausrichtung verschiedener Modalitäten (wie Text und Bild) in zwei Phasen. In der ersten Phase werden mit Single-Subject-Kontextdaten ein vortrainiertes Text-zu-Bild-Modell feinabgestimmt, um es in ein Subjekt-zu-Bild-Modell zu verwandeln; in der zweiten Phase wird das Training auf generierten Multi-Subject-Datenpaaren fortgesetzt.
Universal Rotary Position Embedding: Unterstützt die Bildgenerierung in verschiedenen Auflösungen und Seitenverhältnissen und kann das Problem der Attributverwechslung bei der erweiterten visuellen Subjektkontrolle wirksam abmildern.
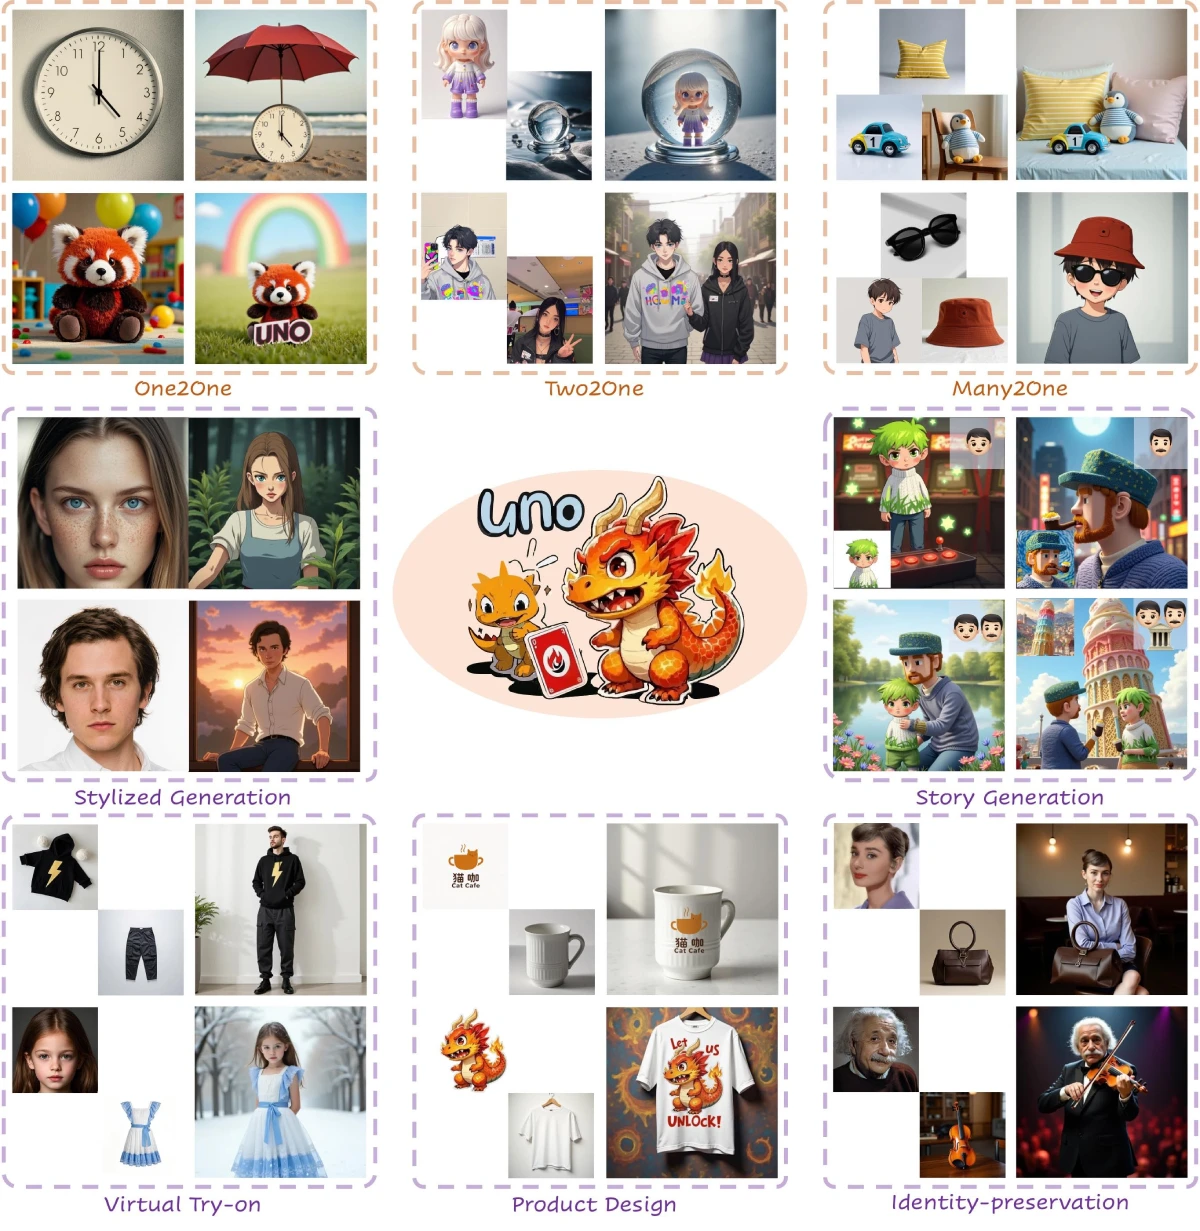
Schlüsselmechanismen von UNO:
Progressive Cross-Modal Alignment: Unterteilt in zwei Phasen. In der ersten Phase werden mit Single-Subject-Kontextdaten ein vortrainiertes Text-zu-Bild-Modell feinabgestimmt, um es in ein Subjekt-zu-Bild-Modell zu verwandeln; in der zweiten Phase wird das Training auf generierten Multi-Subject-Datenpaaren fortgesetzt.
Universal Rotary Position Embedding (UnoPE): Kann das Problem der Attributverwechslung bei der erweiterten visuellen Subjektkontrolle wirksam abmildern und unterstützt die Bildgenerierung in verschiedenen Auflösungen und Seitenverhältnissen.
So funktioniert UNO
UNO nutzt die Kontextgenerierungsfähigkeit von Diffusion Transformers, um hochkonsistente Multi-Subject-Paardaten zu erzeugen. Es wird iterativ aus einem Text-zu-Bild-Modell trainiert und erreicht durch seine einzigartigen Mechanismen wie Progressive Cross-Modal Alignment und Universal Rotary Position Embedding sowohl hohe Konsistenz als auch Steuerbarkeit bei der Generierung mit einem oder mehreren Subjekten.
Anwendungsszenarien von UNO
Single-Subject-Generierung: Generiert Bilder auf Basis eines Referenzbildes, z. B. kann anhand des Bildes einer Uhr ein Bild einer Uhr am Strand erzeugt werden.
Multi-Subject-Generierung: Generiert Bilder auf Basis mehrerer Referenzbilder, z. B. kann anhand der Bilder einer Puppe und einer Kristallkugel ein Bild der Puppe in der Kristallkugel erzeugt werden.
Kontextgenerierung: Erzeugt hochkonsistente Bilder durch Kontext-Prompts, z. B. wird mit einem Prompt wie „eine Uhr am Strand mit einem roten Sonnenschirm“ und dem Referenzbild der Uhr ein Bild erzeugt, das der Beschreibung entspricht.
So verwendet man UNO
Umgebungskonfiguration:
Virtuelle Umgebung erstellen und Abhängigkeiten installieren:
python -m venv uno_env
source uno_env/bin/activate
pip install -r requirements.txt
Modellgewichte herunterladen: Automatischer Download (der Code lädt sie automatisch herunter, wenn das Inferenz-Skript ausgeführt wird), oder manueller Download der Gewichte mit huggingface-cli in das angegebene Verzeichnis.
Inferenz-Beispiel: Führen Sie den folgenden Befehl aus, um ein Bild zu erzeugen:
python inference.py --prompt "A clock on the beach is under a red sun umbrella" --image_paths "assets/clock.png" --width 704 --height 704
Training: Trainingsskript ausführen:
accelerate launch train.py
Zugehörige Links
Projekt-Website:https://bytedance.github.io/UNO
GitHub-Repository:https://github.com/bytedance/UNO
arXiv-Paper:https://arxiv.org/abs/2504.02160
Demo:https://huggingface.co/spaces/bytedance-research/UNO-FLUX









