
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Cloudflare stellt AutoRAG vor: eine vollständig verwaltete RAG-Pipeline
小编 ·

Cloudflare stellt AutoRAG vor: eine vollständig verwaltete RAG-Pipeline
Was ist AutoRAG
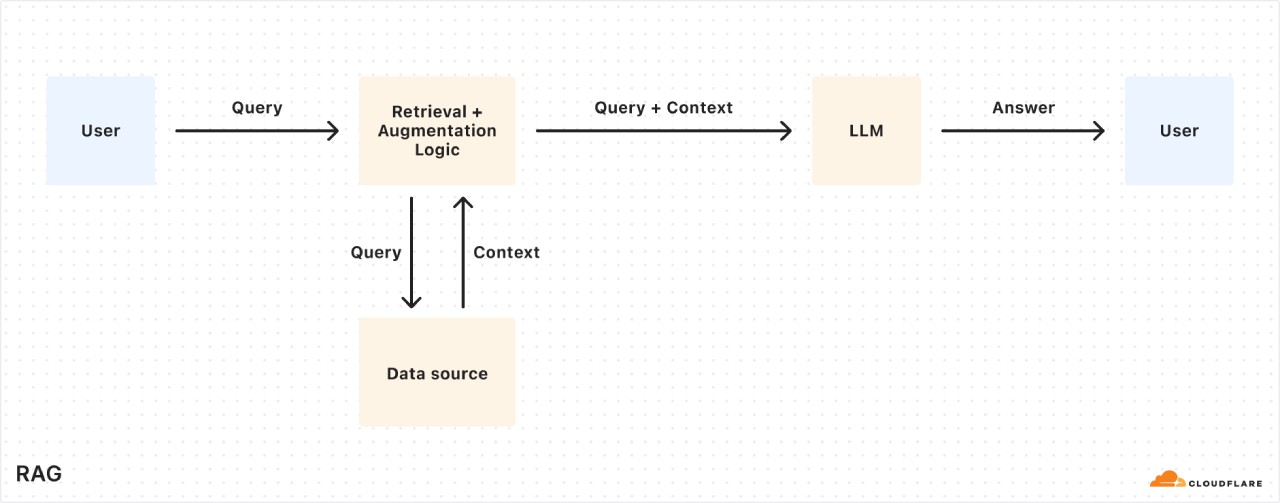
AutoRAG ist eine vollständig verwaltete RAG-Pipeline, die von Cloudflare unterstützt wird. RAG ist eine Methode, bei der Informationen aus den eigenen Daten eines Nutzers abgerufen und einem großen Sprachmodell (LLM) zur Verfügung gestellt werden, um genauere und kontextbezogenere Antworten zu generieren.
Schmerzpunkte herkömmlicher RAG-Pipelines
Der Aufbau einer RAG-Pipeline erfordert das Zusammenstückeln mehrerer Tools und Dienste wie Datenspeicher, Vektor-Datenbanken, Embedding-Modelle, LLMs usw. Wenn sich die Daten ändern, müssen die Daten zudem manuell neu indexiert und neue Embeddings erzeugt werden, um die Relevanz und Leistung des Systems aufrechtzuerhalten. AutoRAG wurde entwickelt, um diese Komplexität zu beseitigen und mit nur wenigen Klicks eine durchgängig verwaltete RAG-Pipeline bereitzustellen – von der Datenaufnahme, dem automatischen Chunking und Embedding bis hin zur Speicherung der Vektoren in Cloudflares Vectorize-Datenbank, der Durchführung semantischer Abfragen und der Generierung hochwertiger Antworten mit Workers ai. AutoRAG überwacht die Datenquellen zudem kontinuierlich im Hintergrund und führt die Neuindizierung durch, sodass die KI ohne manuellen Aufwand aktuell bleibt.
Warum RAG verwenden
Einschränkungen von LLMs: LLMs wie Metas Llama 3.3 sind zwar leistungsstark, ihr Wissen beschränkt sich jedoch auf die Inhalte, mit denen sie trainiert wurden, und sie tun sich oft schwer, genaue Antworten auf neue, proprietäre oder domänenspezifische Informationen zu geben. Die Bereitstellung relevanter System-Prompt-Informationen ist zwar hilfreich, erhöht jedoch die Eingabegröße und unterliegt der Begrenzung des Kontextfensters. Das Feintuning eines Modells ist kostspielig und erfordert zudem ein kontinuierliches Neutraining, um aktuell zu bleiben.
Vorteile von RAG: RAG kann zum Zeitpunkt der Abfrage relevante Informationen aus Datenquellen abrufen, sie mit der Eingabeanfrage des Nutzers kombinieren und gemeinsam an ein LLM übergeben, um eine auf den Nutzerdaten basierende Antwort zu erzeugen. Dadurch eignet sich RAG ideal für Anwendungsfälle wie KI-gestützte Support-Bots, interne Wissensassistenten, semantische Suche über Dokumente hinweg und mehr – Szenarien, in denen sich die tatsächlichen Informationsquellen ständig ändern.
So funktioniert AutoRAG
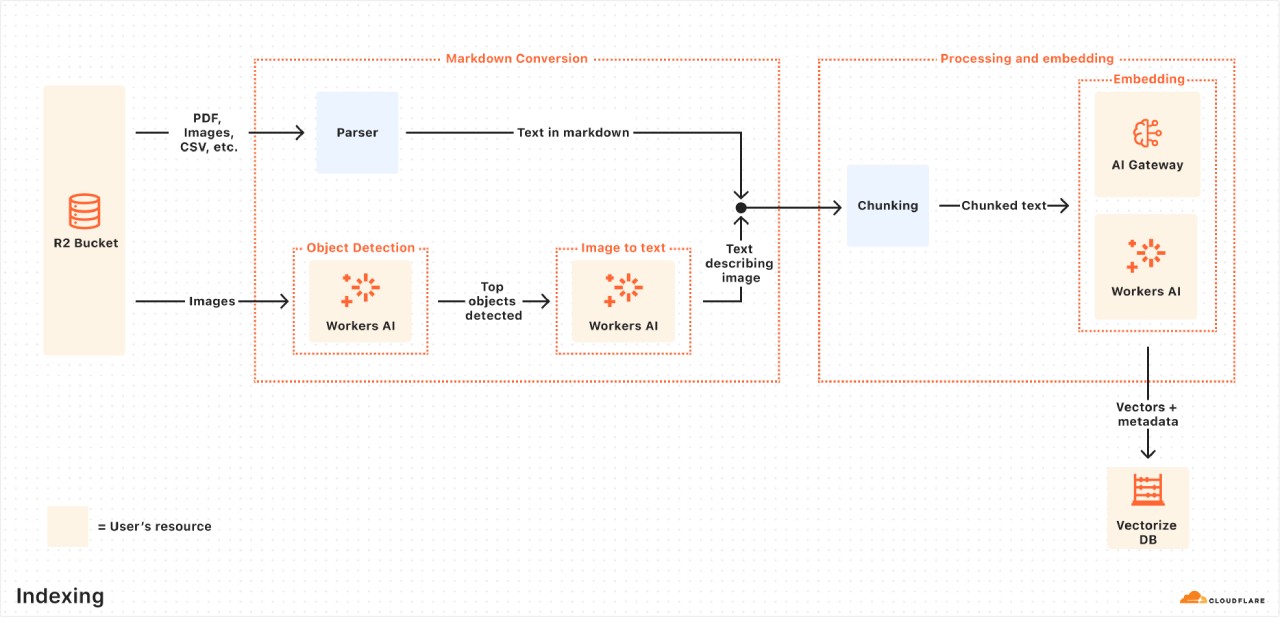
Indexierungsprozess: Dies ist ein asynchroner Prozess, der im Hintergrund abläuft, ab der Erstellung von AutoRAG automatisch startet und nach jedem abgeschlossenen Durchlauf neu hinzugekommene oder aktualisierte Dateien erneut verarbeitet. Während der Indexierung werden die Inhalte in für die semantische Suche optimierte Vektoren umgewandelt.
Datei-Erfassung: AutoRAG liest Dateien direkt aus Datenquellen und unterstützt derzeit die Integration mit Cloudflare R2, in dem Dokumente in verschiedenen Formaten wie PDF, Bilder, Text, HTML, CSV usw. zur Verarbeitung gespeichert werden können.
Markdown-Konvertierung: Mithilfe der Markdown-Konvertierung von Workers AI werden alle Dateien in ein strukturiertes Markdown-Format umgewandelt, um die Konsistenz zwischen verschiedenen Dateitypen sicherzustellen. Bei Bildern wird mit Workers AI eine Objekterkennung durchgeführt und anschließend eine Vision-zu-Sprache-Umwandlung vorgenommen, um Bilder in Markdown-Text zu konvertieren.
Chunking: Der extrahierte Text wird in kleinere Chunks aufgeteilt, um die Granularität der Abfrage zu verbessern.
Embedding: Mithilfe des Embedding-Modells von Workers AI wird jeder Chunk eingebettet und der Inhalt in einen Vektor umgewandelt.
Vektorspeicherung: Die resultierenden Vektoren sowie Metadaten (wie Quellort und Dateiname) werden in der Vectorize-Datenbank von Cloudflare gespeichert, die in deinem Konto erstellt wird.
Abfrageprozess: Dies ist ein synchroner Prozess, der ausgelöst wird, wenn ein Nutzer eine Suchanfrage sendet.
Empfang der Abfrage von der AutoRAG-API: Wenn du eine Anfrage an den AI-Such- oder Such-Endpunkt von AutoRAG sendest, beginnt der Abfrage-Workflow.
Abfrage-Umschreibung (optional): AutoRAG bietet die Option, die Eingabeanfrage mithilfe eines der LLMs von Workers AI umzuschreiben, um die Abfragequalität zu verbessern, indem die ursprüngliche Anfrage in eine effektivere Suchanfrage umgewandelt wird.
Embedding der Abfrage: Die umgeschriebene (oder ursprüngliche) Anfrage wird mithilfe desselben Embedding-Modells, das auch für das Embedding der Daten verwendet wurde, in einen Vektor umgewandelt, um sie mit den vektorisierten Daten zu vergleichen und die relevantesten Treffer zu finden.
Vektorsuche in Vectorize: Der Abfragevektor wird mit den in der mit AutoRAG verknüpften Vectorize-Datenbank gespeicherten Vektoren durchsucht.
Abruf von Metadaten + Inhalten: Vectorize gibt die relevantesten Chunks samt ihrer Metadaten zurück, und die ursprünglichen Inhalte werden aus dem R2-Bucket abgerufen. Diese Inhalte werden an das Textgenerierungsmodell übergeben.
Antwortgenerierung: Mithilfe des Textgenerierungsmodells von Workers AI wird eine Antwort auf Grundlage der abgerufenen Inhalte und der ursprünglichen Nutzeranfrage erzeugt.
AutoRAG-Tutorial
Verwendung der Browser Rendering API: Wenn sich die Inhalte nicht in einem R2-Bucket, sondern noch auf Webseiten befinden oder über ein Frontend-UI dynamisch dargestellt werden müssen, kannst du die Browser Rendering API verwenden, um deine eigene Website zu crawlen und so die Inhalte für RAG bereitzustellen. Die Browser Rendering REST API ist nun allgemein verfügbar und bietet Endpunkte für gängige Browser-Operationen, einschließlich des Extrahierens von HTML-Inhalten, Aufnehmen von Screenshots und Erzeugen von PDFs. Außerdem wird demnächst ein Crawling-Endpunkt eingeführt, der das Abrufen von Webinhalten weiter erleichtert.
Schritt 1: Worker erstellen, um Webseiten zu scrapen und in R2 hochzuladen
Erstelle ein neues Worker-Projekt mit dem Namen browser-r2-worker und wähle die entsprechenden Optionen für die Einrichtung.
Installiere @cloudflare/puppeteer, um die Browser-Rendering-Instanz zu steuern.
Erstelle einen neuen R2-Bucket mit dem Namen html-bucket.
Füge die entsprechende Konfiguration in der Wrangler-Konfigurationsdatei hinzu, damit der Worker Browser Rendering und den neuen R2-Bucket nutzen kann.
Ersetze den Inhalt von src/index.ts durch Skriptcode, mit dem Webseiten gescrapet und in den R2-Bucket gespeichert werden.
Stelle den Worker in deinem Cloudflare-Konto bereit.
Teste den Worker mit einer cURL-Anfrage, um die HTML-Datei der Webseite zu scrapen und in den html-bucket hochzuladen.
Schritt 2: AutoRAG erstellen und die Indexierung überwachen
Navigiere im Cloudflare-Dashboard zu AI > AutoRAG.
Wähle die Erstellung von AutoRAG und schließe den Einrichtungsprozess ab, einschließlich der Auswahl des R2-Buckets mit der Wissensdatenbank, des Embedding-Modells, des LLMs, des AI-Gateways, der Benennung von AutoRAG sowie der Auswahl oder Erstellung eines Service-API-Tokens.
Nach der Erstellung von AutoRAG wird automatisch eine Vectorize-Datenbank in deinem Konto angelegt und mit der Indexierung der Daten begonnen. Den Fortschritt der Indexierungsjobs kannst du auf der Übersichtsseite von AutoRAG einsehen.
Schritt 3: Testen und in die Anwendung integrieren
Sobald die Indexierung abgeschlossen ist, kannst du beginnen, AutoRAG Fragen zu stellen. Du kannst im Playground-Tab der AutoRAG-Instanz Fragen stellen, z. B. „Was ist AutoRAG?"
Wenn du mit den Ergebnissen im Playground zufrieden bist, kannst du AutoRAG direkt in die Anwendung integrieren, die du gerade entwickelst. Wenn du die Anwendung mit einem Worker erstellst, kannst du AutoRAG direkt über die KI-Bindung aufrufen.
In der offenen Beta-Phase ist AutoRAG kostenlos. Für die Berechnungsoperationen der Indexierung, Abfrage und Anreicherung fallen in dieser Phase keine zusätzlichen Kosten an.
Offizielle ausführliche Vorstellung:https://blog.cloudflare.com/introducing-autorag-on-cloudflare/









