
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Crawl4AI: ein Open-Source-Webcrawler und -Scraper, der KI-freundlich ist
小编 ·

Crawl4AI: ein Open-Source-Webcrawler und -Scraper, der KI-freundlich ist
Was ist Crawl4ai?
Crawl4AI ist ein Open-Source-, KI-freundlicher Web-Crawler und Scraper, ein beliebtes Projekt auf GitHub, das speziell für LLMs, KI-Agenten und Datenpipelines entwickelt wurde. Es unterstützt die schnelle und flexible Extraktion von Webdaten, generiert LLM-gerechte Markdown-formatierte Daten und bietet Funktionen wie strukturierte Datenextraktion, Browser-Integration und Verarbeitung dynamischer Inhalte.
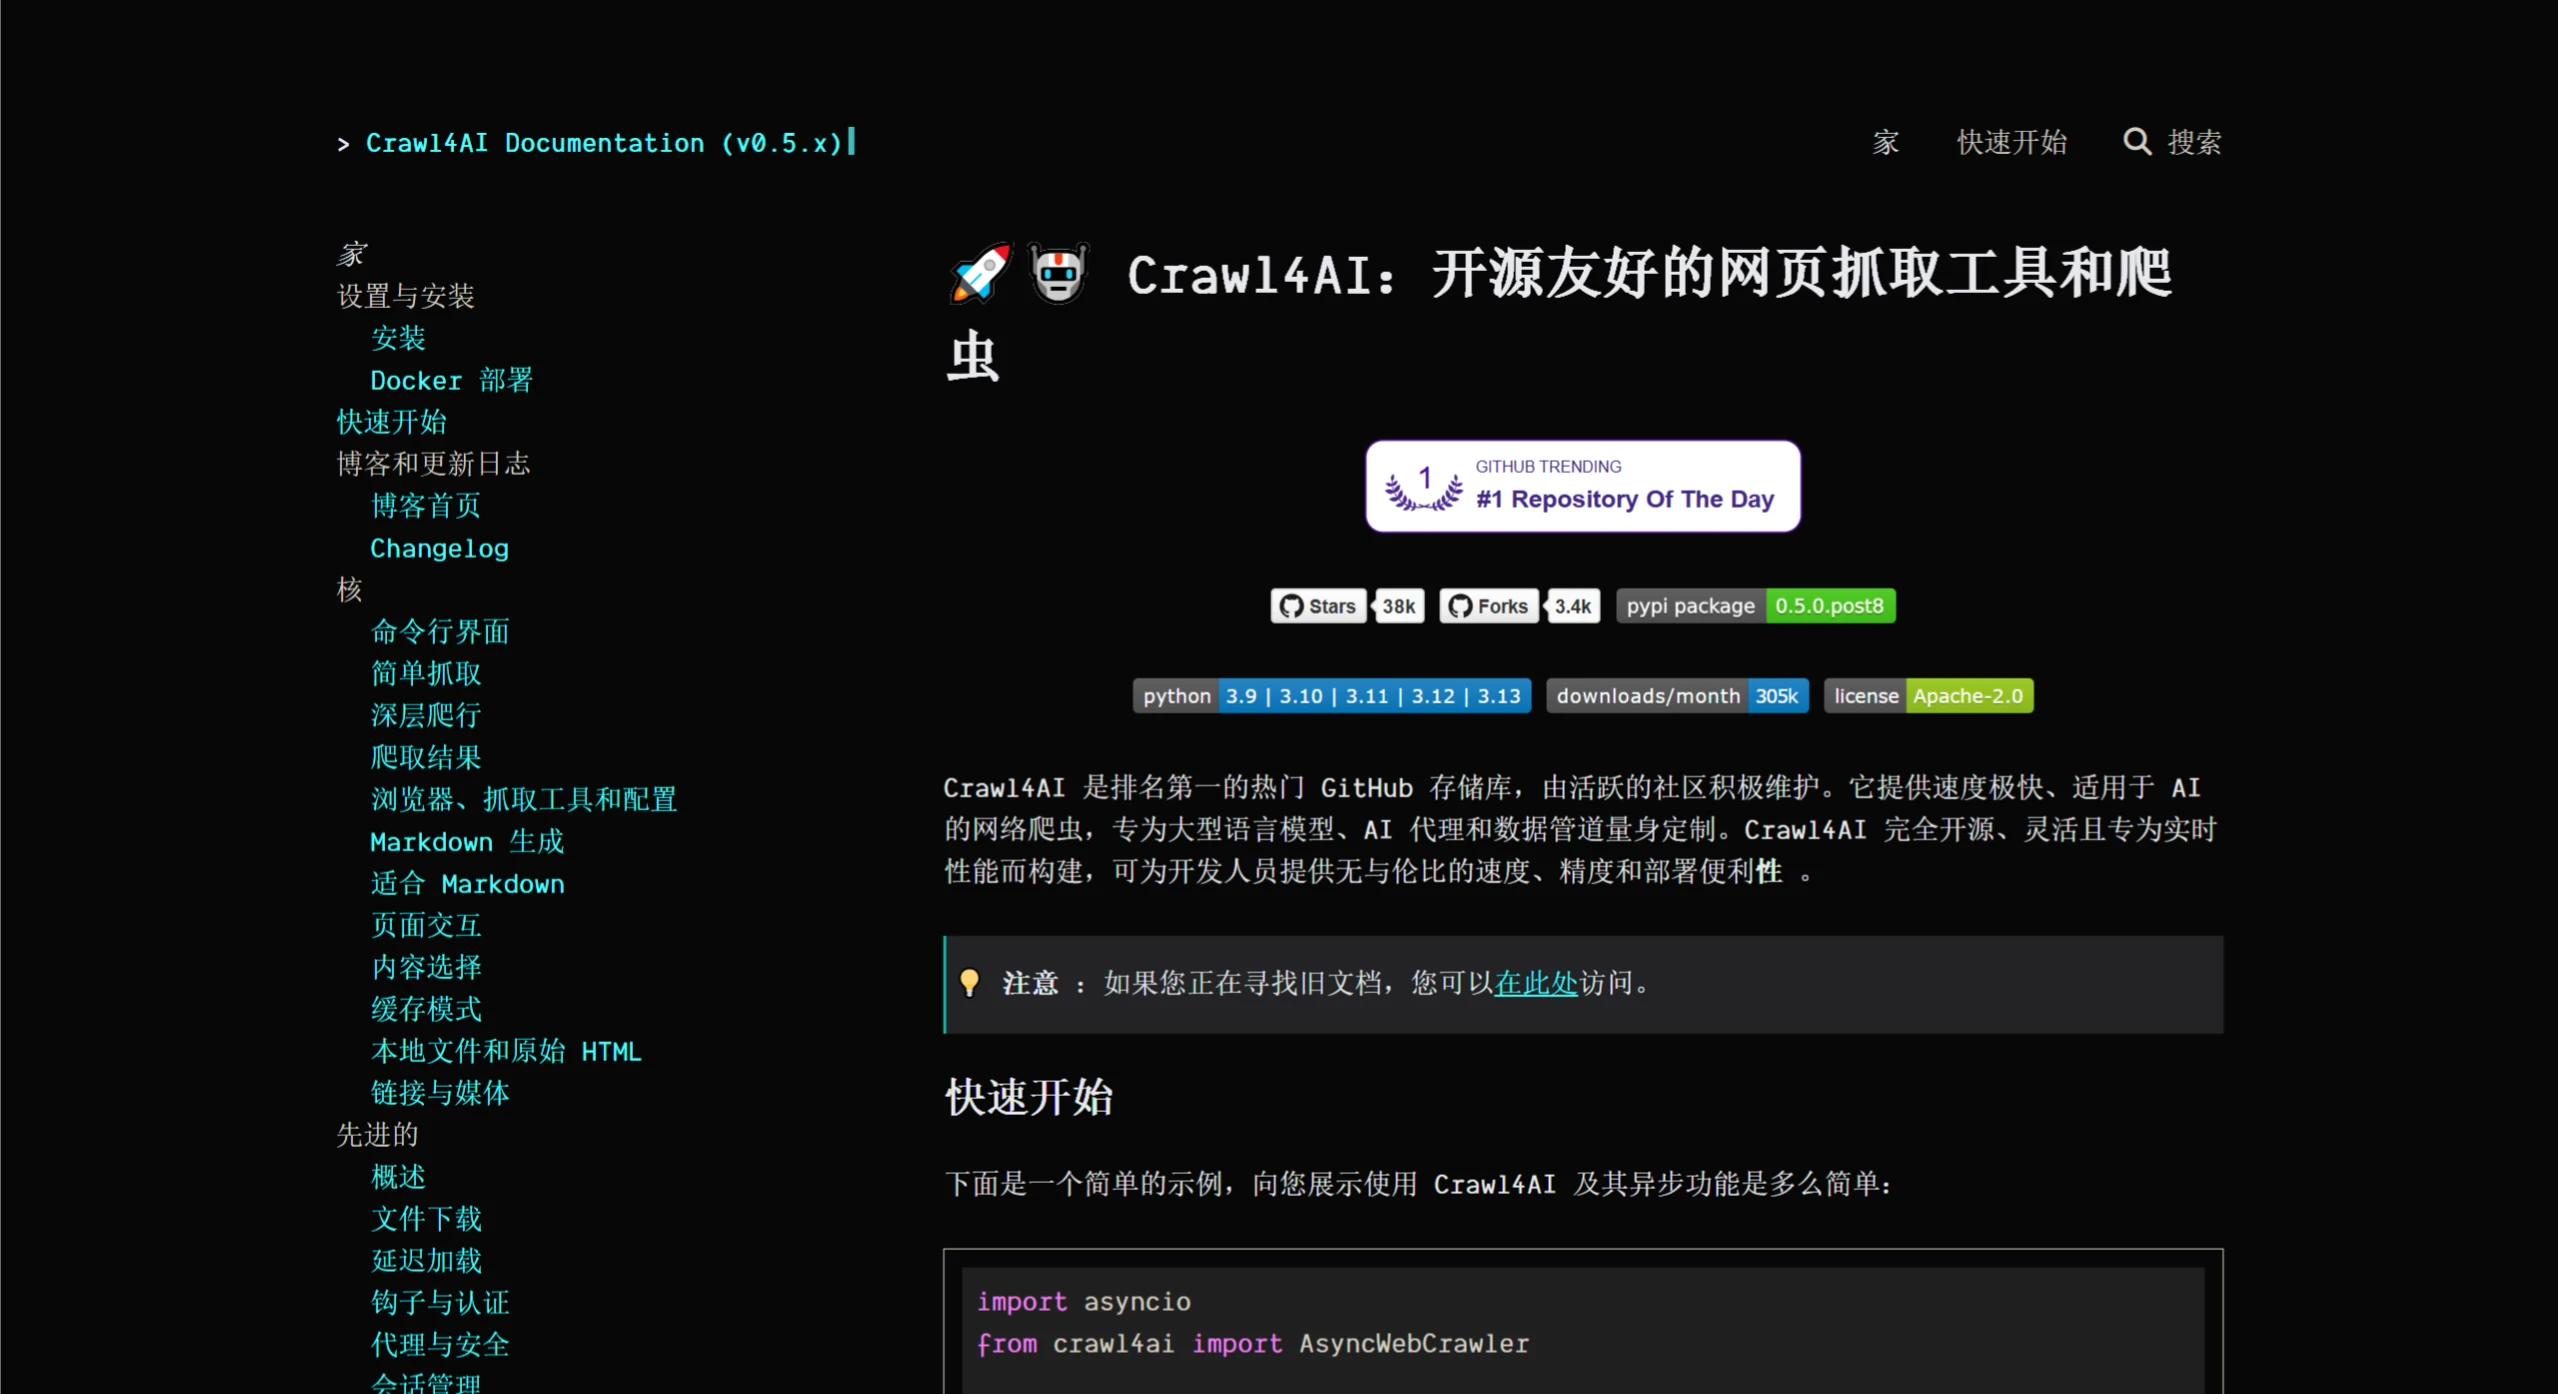
Crawl4AI Funktionen
Markdown-Generierung
Sauberes Markdown: Generiert klar strukturierten und genau formatierten Markdown-Text.
Optimiertes Markdown: Filtert mithilfe heuristischer Algorithmen Rauschen und irrelevante Inhalte heraus und erzeugt KI-gerechtes Markdown.
Zitate und Referenzen: Wandelt Seitenlinks in nummerierte Referenzlisten um und stellt klare Zitate bereit.
Benutzerdefinierte Strategien: Benutzer können eigene Markdown-Generierungsstrategien erstellen, um spezifische Anforderungen zu erfüllen.
BM25-Algorithmus: Filtert Inhalte basierend auf dem BM25-Algorithmus, um Kerninformationen zu extrahieren und irrelevante Inhalte zu entfernen.
Strukturierte Datenextraktion
LLM-gesteuerte Extraktion: Unterstützt alle LLMs (Open Source und proprietär) für die strukturierte Datenextraktion.
Chunking-Strategien: Implementiert themen-, regex- und satzbasierte Chunking-Verarbeitung.
Cosinus-Ähnlichkeit: Findet relevante Inhaltsblöcke basierend auf Benutzeranfragen für semantische Extraktion.
CSS-basierte Extraktion: Verwendet XPath- und CSS-Selektoren für schnelle, musterbasierte Datenextraktion.
Schema-Definition: Definiert benutzerdefinierte Schemata zur Extraktion strukturierter JSON-Daten aus wiederkehrenden Mustern.
Browser-Integration
Verwalteter Browser: Verwendet den eigenen Browser des Nutzers, um eine Erkennung als Crawler zu vermeiden.
Ferngesteuerte Browser-Steuerung: Verbindet sich über das Chrome-Entwicklertool-Protokoll mit entfernten Browsern für die Datenextraktion im großen Maßstab.
Browser-Profile: Erstellt und verwaltet persistente Profile, die Authentifizierungsstatus, Cookies und Einstellungen speichern.
Sitzungsverwaltung: Bewahrt den Browserzustand und verwendet ihn wieder, um mehrstufiges Crawlen zu unterstützen.
Proxy-Unterstützung: Nahtlose Verbindung zu authentifizierten Proxies für sicheren Zugriff.
Vollständige Browser-Steuerung: Ändert Request-Header, Cookies, User-Agent usw., um die Crawling-Einstellungen anzupassen.
Multi-Browser-Unterstützung: Kompatibel mit Chromium, Firefox und WebKit.
Dynamische Viewport-Anpassung: Passt den Browser-Viewport automatisch an den Seiteninhalt an, um vollständiges Rendering und Erfassung aller Elemente sicherzustellen.
Crawling und Scraping
Medienunterstützung: Extrahiert Bilder, Audio, Videos sowie responsive Bildformate (wie srcset und picture).
Dynamisches Crawlen: Führt JavaScript aus und wartet auf asynchrone oder synchrone Inhalte, um dynamische Inhalte zu extrahieren.
Screenshots: Erfasst Seitenscreenshots während des Crawling-Prozesses zum Debuggen oder zur Analyse.
Rohdaten-Crawling: Verarbeitet direkt rohes HTML (raw:) oder lokale Dateien (file://).
Umfassende Linkextraktion: Extrahiert interne, externe Links sowie eingebettete iframe-Inhalte.
Benutzerdefinierte Hooks: Definiert Hooks in jedem Schritt, um das Crawling-Verhalten anzupassen.
Caching: Zwischenspeichert Daten zur Steigerung der Geschwindigkeit und vermeidet doppeltes Scraping.
Metadatenextraktion: Extrahiert strukturierte Metadaten aus Webseiten.
iframe-Inhaltsextraktion: Extrahiert nahtlos eingebettete iframe-Inhalte.
Lazy-Loading-Behandlung: Wartet, bis Bilder vollständig geladen sind, um sicherzustellen, dass durch Lazy Loading keine Inhalte verloren gehen.
Vollständiger Seiten-Scan: Simuliert Scrollen, um alle dynamischen Inhalte zu laden und zu erfassen – geeignet für Seiten mit unendlichem Scrollen.
Weitere Funktionen
Stealth-Modus: Vermeidet Erkennung als Crawler durch Nachahmung realen Nutzerverhaltens.
Tag-basierte Inhaltsextraktion: Verfeinert die Crawling-Inhalte anhand benutzerdefinierter Tags, Titel oder Metadaten.
Link-Analyse: Extrahiert und analysiert alle Links für detaillierte Datenexploration.
Fehlerbehandlung: Robustes Fehlermanagement für nahtlose Ausführung.
CORS und statischer Service: Unterstützt dateisystembasiertes Caching und Cross-Origin-Anfragen.
Klare Dokumentation: Vereinfachte Anleitungen für Einsteiger und fortgeschrittene Nutzung.
Vorteile von Crawl4AI
Maßgeschneidert für LLMs: Generiert intelligentes, prägnantes Markdown, das für RAG- und Fine-Tuning-Anwendungen geeignet ist.
Extrem hohe Geschwindigkeit: Echtzeit-, kosteneffiziente Leistung, 6-mal schneller als herkömmliche Methoden.
Flexible Browser-Steuerung: Bietet Sitzungsverwaltung, Proxy-Unterstützung und benutzerdefinierte Hooks für nahtlosen Datenzugriff.
Heuristische Intelligenz: Nutzt fortschrittliche Algorithmen zur effizienten Inhaltsextraktion und reduziert die Abhängigkeit von teuren Modellen.
Open Source und bereitstellbar: Vollständig Open Source, keine API-Schlüssel erforderlich, unterstützt Docker und Cloud-Integration.
Crawl4AI-Anwendungsfälle
KI und maschinelles Lernen: Liefert qualitativ hochwertige Trainingsdaten für LLMs, unterstützt NLP und den Aufbau von Wissensgraphen.
Datenpipelines: Aufbau effizienter Datenpipelines zur Echtzeit-Extraktion und -Verarbeitung von Webdaten.
Inhaltsextraktion: Extrahiert Text, Bilder, Videos und andere multimediale Inhalte aus Webseiten für Content-Management-Systeme.
Akademische Forschung: Unterstützt Forscher bei der Extraktion von Arbeiten und Forschungsdaten aus dem Web und unterstützt akademische Forschungsarbeiten.
Business Intelligence: Extrahiert Marktdaten, Produktinformationen und Nutzerbewertungen zur Unterstützung geschäftlicher Entscheidungen.
Nachrichtenmedien: Schnelles Scraping von Nachrichteninhalten zur Unterstützung von Nachrichtenaggregation und Inhaltsanalyse.
Crawl4AI Installations- und Nutzungsanleitung
Installation
Standardinstallation:
pip install crawl4ai
crawl4ai-setup  # 设置浏览器
Installation der Vorabversion:
pip install crawl4ai --pre
Entwicklungsinstallation:
git clone https://github.com/unclecode/crawl4ai.git
cd crawl4ai
pip install -e .  # 基本安装
pip install -e ".[all]"  # 安装所有可选功能
Github-Adresse:https://github.com/unclecode/crawl4ai
Crawl4AI-Dokumentation:https://docs.crawl4ai.com/
Discord:https://discord.com/invite/jP8KfhDhyN









