
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Versatile-OCR-Program: OCR, das strukturierte Daten aus komplexen Materialien wie Prüfungsbögen extrahiert
小编 ·

Versatile-OCR-Program: OCR, das strukturierte Daten aus komplexen Materialien wie Prüfungsbögen extrahiert
Was ist Versatile-OCR-Program?
Versatile-OCR-Program ist ein speziell für das Training von Machine-Learning-Modellen optimiertes OCR-System, das strukturierte Daten aus komplexen Bildungsmaterialien (wie Prüfungsunterlagen) extrahieren und in den Formaten JSON oder Markdown ausgeben kann. Es unterstützt Japanisch, Koreanisch und Englisch und lässt sich auf weitere Sprachen, mathematische Formeln, Tabellen sowie Diagramme und Grafiken erweitern. Darüber hinaus kann es semantische Annotationen in Form von natürlichsprachlichen Beschreibungen erzeugen.
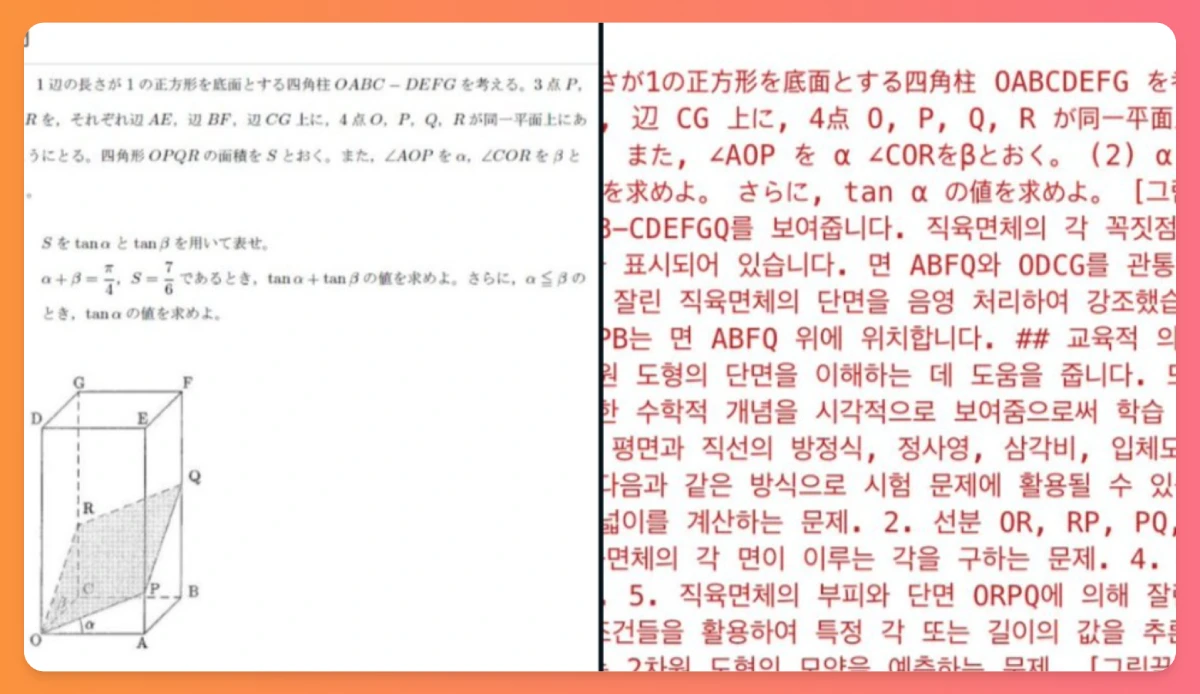
Hauptmerkmale von Versatile-OCR-Program
Optimierung für Machine-Learning-Training: Extrahierte Elemente (wie Diagramme, Tabellen und Grafiken) werden semantisch annotiert, einschließlich automatisch generierter natürlichsprachlicher Beschreibungen visueller Inhalte, um das Training nachgelagerter Modelle zu verbessern.
Mehrsprachige Unterstützung: Unterstützt Japanisch, Koreanisch und Englisch und kann problemlos an weitere Sprachen angepasst werden.
Strukturierte Ausgabe: Erzeugt KI-fähige Ausgaben im JSON- oder Markdown-Format, einschließlich menschenlesbarer Beschreibungen mathematischer Ausdrücke, Tabellenzusammenfassungen und Diagrammtiteln.
Hohe Genauigkeit: Auf realen akademischen Datensätzen wie EJU Biologie und Mathematik der Universität Tokio werden Genauigkeiten von 90 % – 95 % erreicht.
Unterstützung komplexer Layouts: Kann prüfungsähnliche PDFs mit dichten wissenschaftlichen Inhalten, formelreichen Absätzen und zahlreichen visuellen Elementen präzise verarbeiten.
Technische Umsetzung: Verwendet unter anderem DocLayout-YOLO, Google Vision API, Gemini Pro Vision, MathPix OCR, OpenAI API und OpenCV.
Beispielausgaben
Es werden konkrete Beispielausgaben bereitgestellt, einschließlich Eingabebildern und konvertierten Ausgabebildern für Mathematik- und Biologieaufgaben sowie semantischer Kontext mit englischer Übersetzung und extrahierten Daten.
Beispiel Mathematikaufgabe: Zeigt, wie aus einem Bild mit geometrischen Figuren und Winkeln Informationen extrahiert und zugehörige Beschreibungen sowie Aufgabenstellungen erzeugt werden.
Beispiel Biologieaufgabe: Zeigt, wie aus einem Bild, das den Prozess der Mitose in Zellen einer Zwiebelwurzelspitze darstellt, Informationen extrahiert und zugehörige Beschreibungen sowie Aufgabenstellungen erzeugt werden.
Ablauf der Nutzung von Versatile-OCR-Program
Schritt 1: Erste OCR-Extraktion: Ausführen des Skripts ocr_stage1.py, um Roher-Elemente (Text, Tabellen, Grafiken usw.) aus dem eingegebenen PDF zu extrahieren, eine Layout-Erkennung durchzuführen und Zwischenergebnisse zu speichern.
Schritt 2: Semantische Interpretation und endgültige Ausgabe: Ausführen des Skripts ocr_stage2.py, das die Zwischendaten verarbeitet und in strukturierte, menschenlesbare Ausgaben umwandelt, einschließlich der Erzeugung natürlichsprachlicher Erklärungen, Zusammenfassungen und der Organisation der Inhalte in einem KI-fähigen Format (JSON/Markdown).
Technische Umsetzung
Optimierung der Tabellenverarbeitung: DocLayout-YOLO wird zur Erkennung von Tabellenbereichen eingesetzt, Google Vision OCR für die Tabellenverarbeitung verwendet (bessere Ergebnisse bei japanischem Text) und die Tabellenstruktur in einem strukturierten JSON-Format beibehalten.
Verarbeitung von Bildern und speziellen Bereichen: Die Bildanalysefunktionen der Google Vision API werden zur Verarbeitung von Bildbereichen genutzt, die Google Cloud Vision API erzeugt Bildbeschreibungen und die Dokumentanalysefunktion der Google Cloud Vision API verarbeitet Diagramme/Grafiken. Die Verarbeitungsergebnisse werden in einem strukturierten JSON-Format gespeichert.
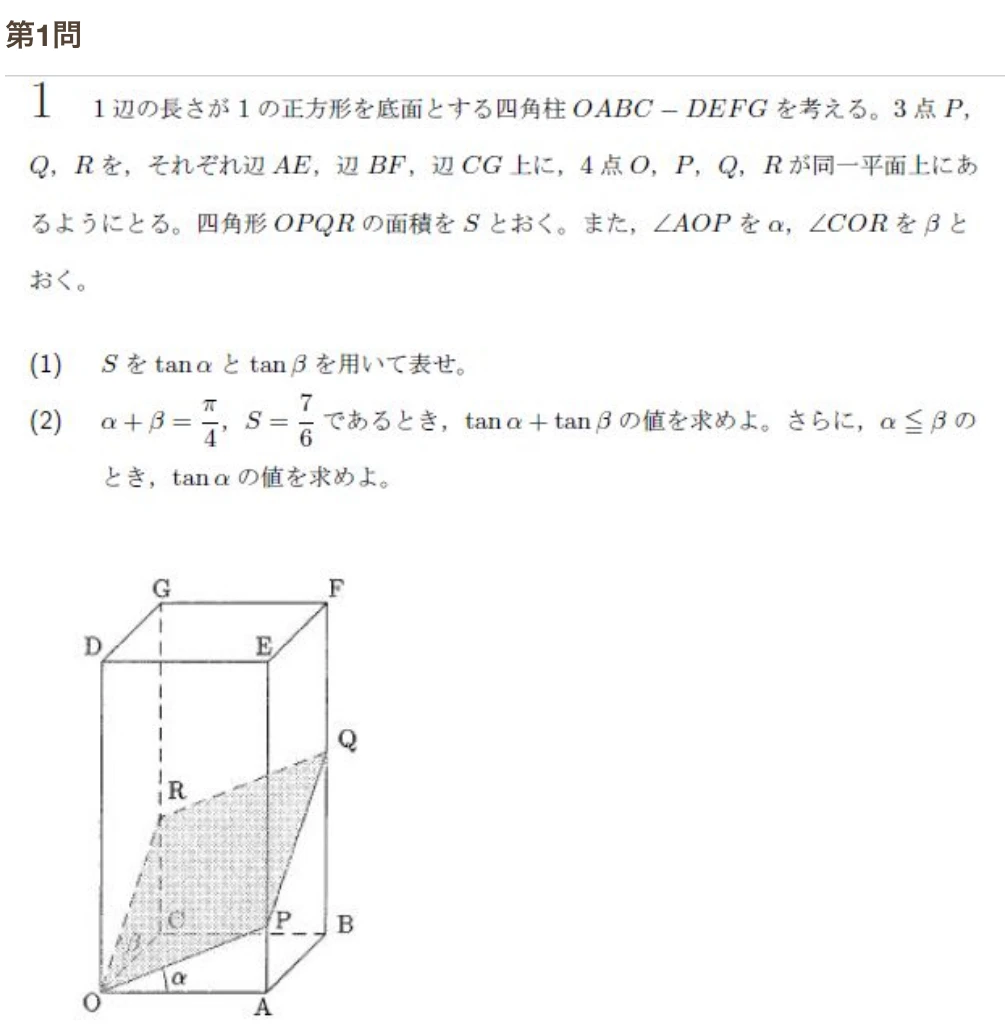
Eingabeeffekt
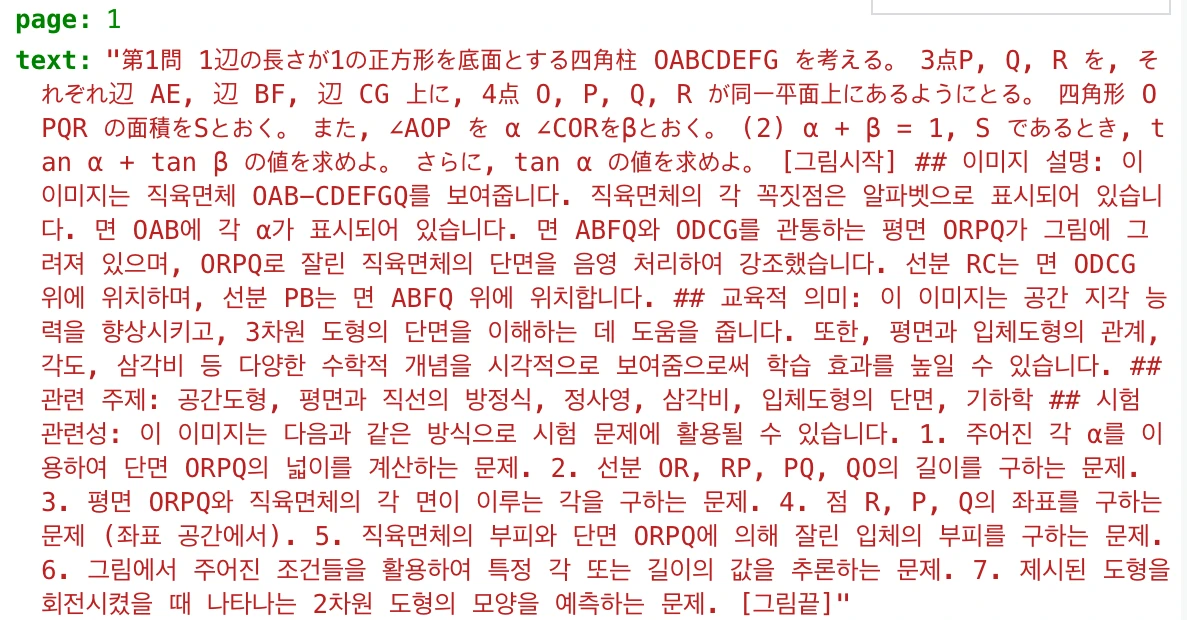
Ausgabeeffekt
Anwendungen von Versatile-OCR-Program
Bildungsbereich: Wird verwendet, um Daten aus Prüfungsunterlagen, wissenschaftlichen Arbeiten und anderen Bildungsmaterialien zu extrahieren und aufzubereiten und unterstützt damit Bildungsforschung und Lernen.
Machine-Learning-Training: Erzeugt hochwertige Trainingsdatensätze für das Training von Machine-Learning-Modellen, insbesondere für Anwendungen im Bildungsbereich.
Verarbeitung mehrsprachiger Dokumente: Eignet sich für Szenarien, in denen Dokumente in mehreren Sprachen verarbeitet werden müssen, wie etwa internationaler akademischer Austausch oder die Digitalisierung mehrsprachiger Bildungsmaterialien.
GitHub-Projekt:https://github.com/ses4255/Versatile-OCR-Program









