
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
OmniTalker: Alibabas Framework für textgesteuerte sprechende Avatare in Echtzeit
小编 ·

OmniTalker: Alibabas Framework für textgesteuerte sprechende Avatare in Echtzeit
Was ist OmniTalker?
OmniTalker ist ein von Alibaba Tongyi Lab entwickeltes Echtzeit-Text-getriebenes sprechendes Avatar-KI-Multimodal-Generierungs-Framework. Es kann basierend auf dem eingegebenen Textinhalt in Echtzeit passende Sprach- und Video-Animationen erzeugen. Die generierte Sprache und das Video sind nicht nur von hoher Qualität, sondern simulieren auch realistisch Gesichtsausdrücke und Kopfbewegungen, als ob ein echter „digitaler Mensch" mit dir sprechen würde. OmniTalker unterstützt die wechselseitige Umwandlung zwischen Chinesisch und Englisch, unterstützt emotionalen Ausdruck wie zum Beispiel Ruhe, Freude, Trauer, Wut und weitere Emotionen und ermöglicht die Generierung langer Videos.
Funktionsmerkmale von OmniTalker
Multimodale Eingabeverarbeitung: Kann mehrere Modalitäten wie Text, Bilder, Audio und Video wahrnehmen.
Streaming-Generierung: Generiert Text und natürlich klingende Sprachantworten auf Streaming-Weise. Die Audio- und Video-Encoder verwenden eine blockweise Verarbeitungsmethode, die die Verarbeitung langer multimodaler Datensequenzen entkoppelt.
Präzise Audio-Video-Synchronisation: Durch die TMRoPE-Technologie wird eine präzise Synchronisation von Video- und Audio-Eingaben gewährleistet.
Echtzeit-Interaktion: Unterstützt blockweise Eingabe und sofortige Ausgabe und ermöglicht vollständige Echtzeit-Interaktion.
Natürlich fließende Sprachgenerierung: Hervorragende Leistung in Bezug auf Natürlichkeit und Stabilität der Sprachgenerierung, die viele bestehende Streaming- und Nicht-Streaming-Alternativen übertrifft.
Leistungsvorteile: Zeigt herausragende Leistung in multimodalen Benchmarks. Die Audio-Fähigkeiten übertreffen das ähnlich große Qwen2-Audio und sind auf dem gleichen Niveau wie Qwen2.5-VL-7B.
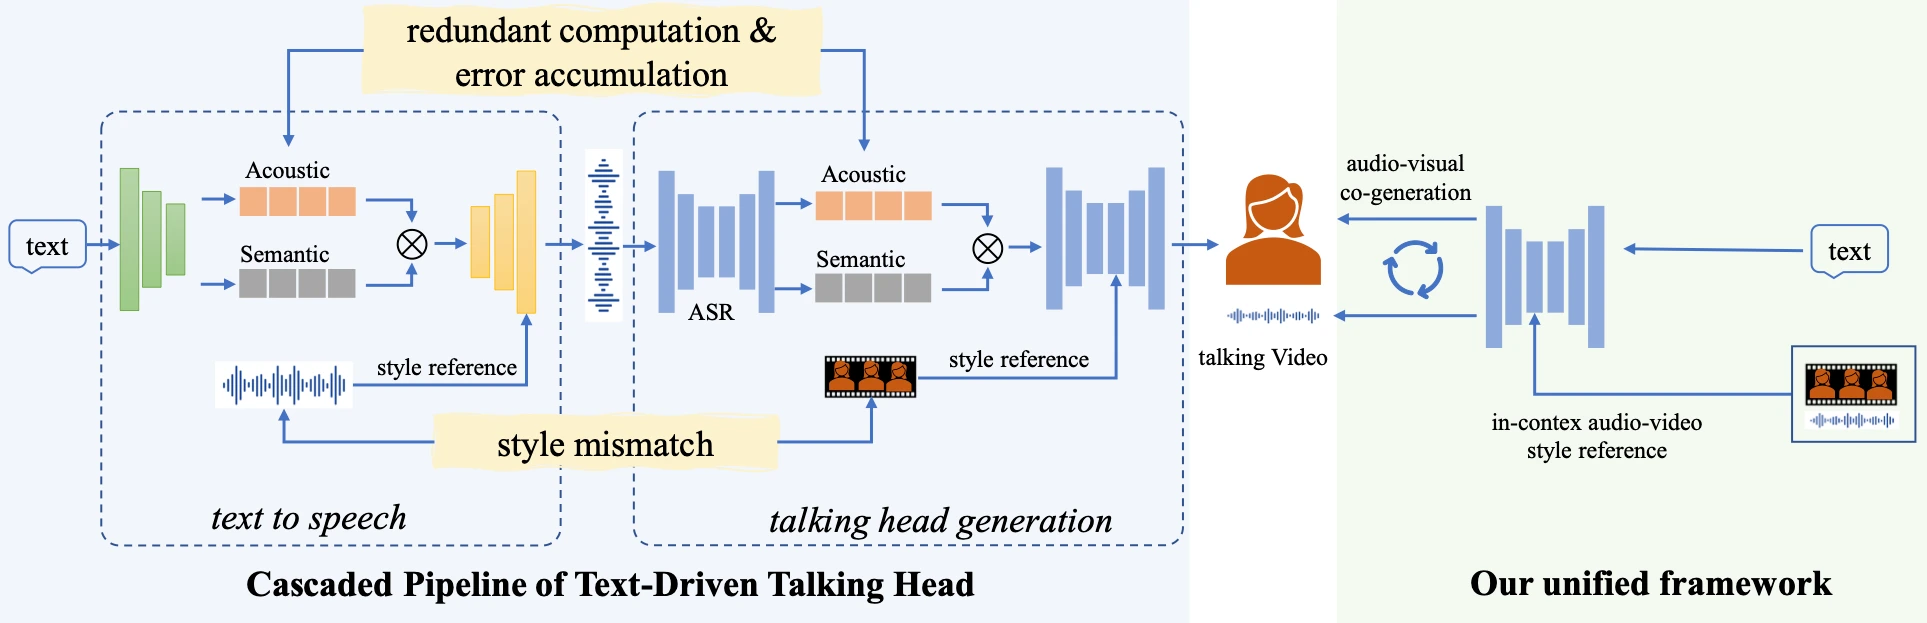
Kerntechnologie von OmniTalker
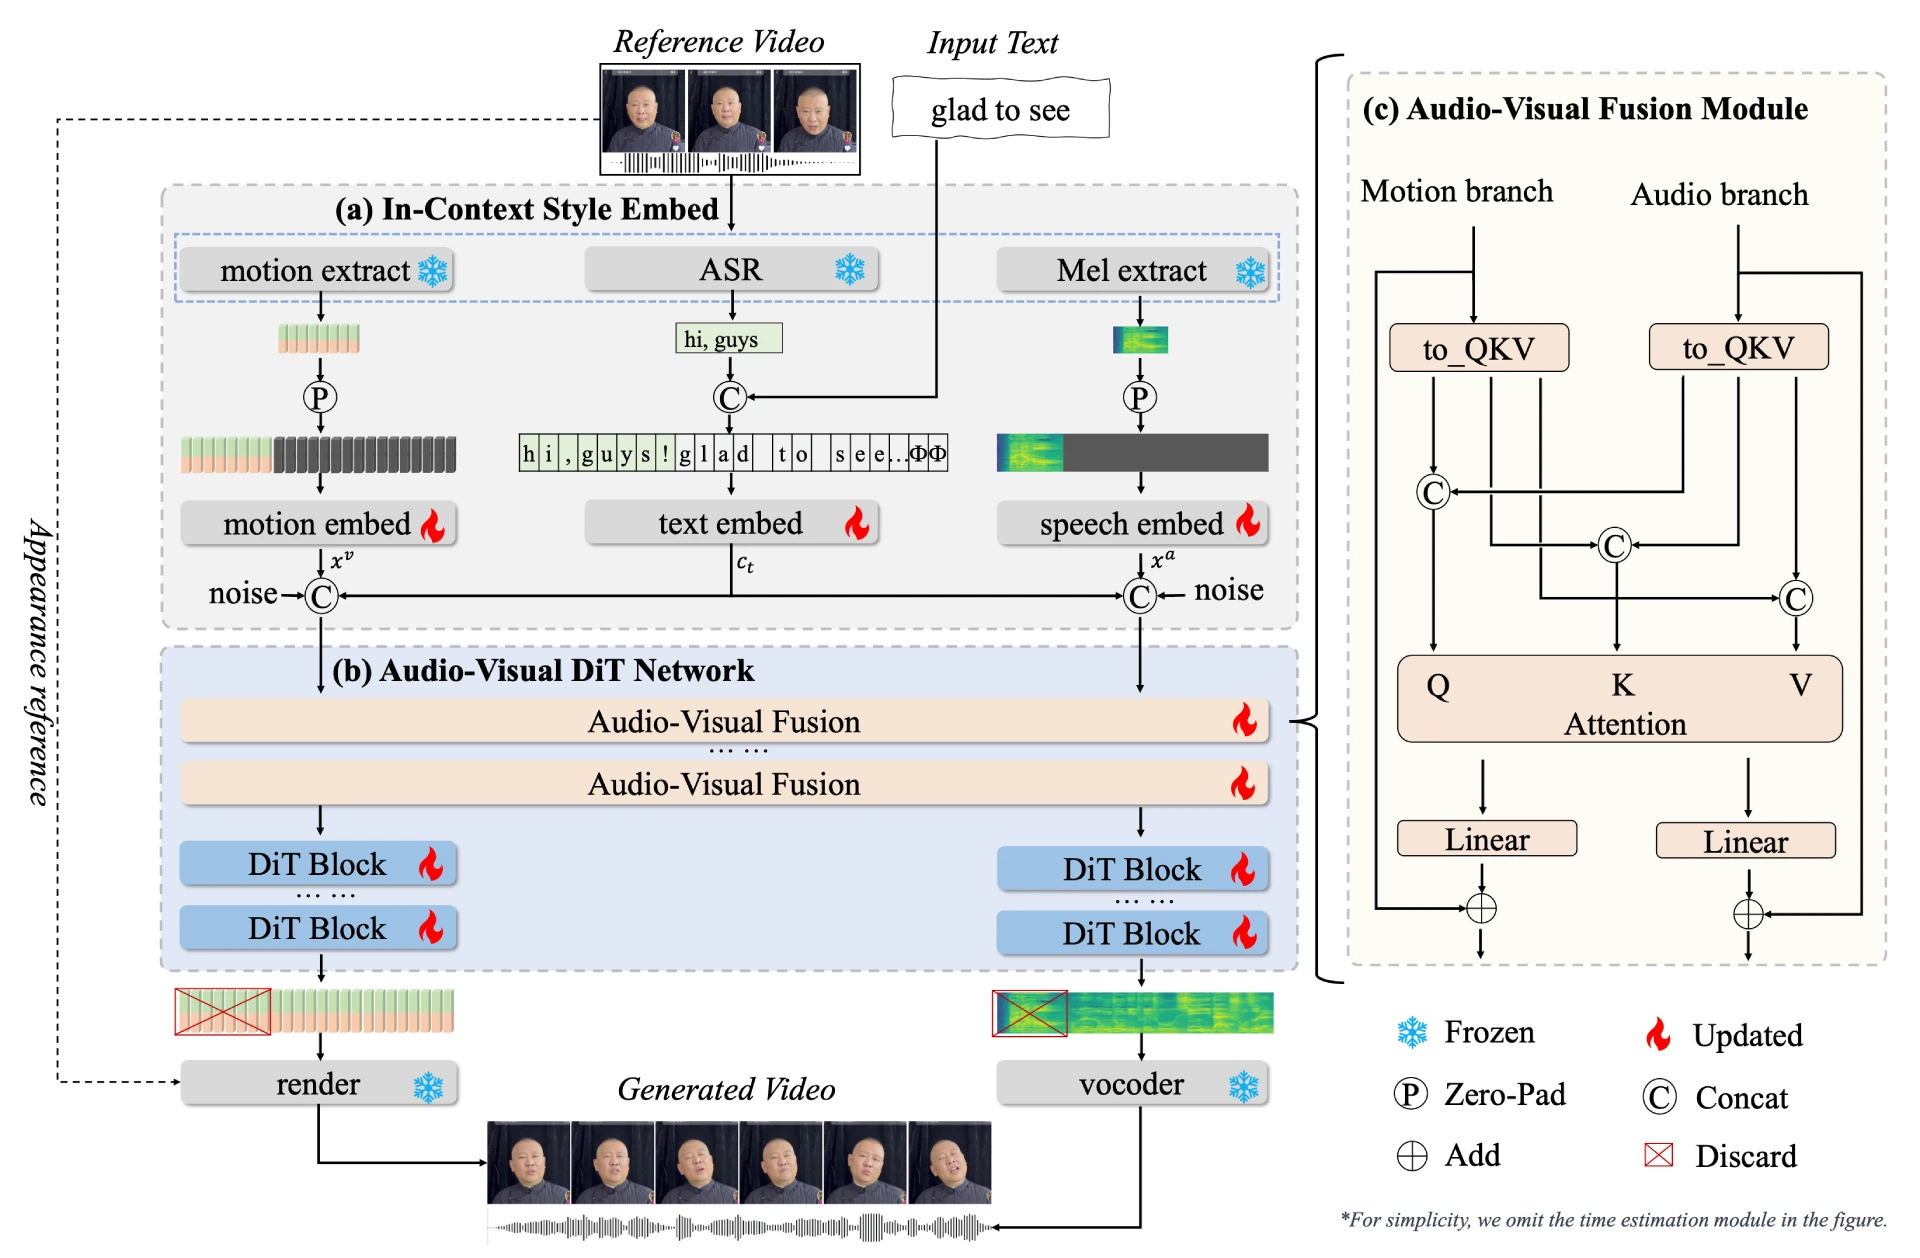
1. Dual-Branch Diffusion Transformer (DiT) Architektur
Besteht aus Audio-Branch und Visual-Branch:
Audio-Branch: Synthetisiert hochwertige Sprache aus Text.
Visual-Branch: Sagt Kopfhaltungen und Gesichtsdynamik vorher.
Durch ein neuartiges Audio-Visual-Fusionsmodul werden die zeitliche Synchronisation und die stilistische Konsistenz der Audio- und Video-Ausgaben sichergestellt.
2. Kontext-Referenz-Lernen
OmniTalker kann Sprach- und Gesichtst stilmerkmale aus einem einzigen Referenzvideo erfassen, ohne dass zusätzliche Stil-Extraktionsmodule erforderlich sind. Das bedeutet, dass OmniTalker unabhängig vom eingegebenen Text Sprach- und Videoinhalte erzeugen kann, die stark mit dem Stil des Referenzvideos übereinstimmen.
3. Echtzeitfähigkeit und Effizienz
OmniTalker kann in Echtzeit mit 25 FPS Sprache und Video generieren, was in dieser Technologiekategorie sehr führend ist. Diese hohe Inferenzgeschwindigkeit ermöglicht es, OmniTalker in Szenarien wie Echtzeit-Videochats und virtuellen Live-Übertragungen einzusetzen und den Nutzern ein flüssiges Interaktionserlebnis zu bieten.
Anwendungsszenarien von OmniTalker
Intelligente Sprachassistenten: Verarbeiten Sprachbefehle der Nutzer und generieren in Echtzeit Sprachantworten.
Multimodale Content-Erstellung: Verarbeitet gleichzeitig Text-, Bild- und Videoeingaben und erzeugt entsprechende Text- oder Sprachbeschreibungen.
Bildung und Schulung: Generiert virtuelle Lehrer, die basierend auf den Lehrinhalten Sprache und Video erzeugen.
Virtueller Kundenservice und Assistenten: Erstellt virtuellen Kundenservice oder Assistenten, die in Echtzeit Sprach- und Videoantworten erzeugen.
Unterhaltung und Medien: Erstellt virtuelle Moderatoren und Schauspieler, die in Echtzeit Aufführungsinhalte generieren.
Vorteile von OmniTalker
Hochwertige Generierung: Die erzeugten Sprach- und Videoinhalte sind von hoher Qualität und können den Stil des Referenzvideos präzise reproduzieren, einschließlich feiner Nuancen in Sprachmelodie, Rhythmus und Gesichtsausdrücken.
Zero-Shot-Lernen: Keine umfangreichen Trainingsdaten erforderlich. Kann basierend auf Eingabetext und Referenzvideo schnell Inhalte erzeugen und sich an verschiedene Szenarien und Anforderungen anpassen.
Echtzeit-Interaktion: Generiert in Echtzeit mit 25 FPS Sprache und Video bei niedriger Latenz, geeignet für Szenarien wie Echtzeit-Videochats und virtuelle Live-Übertragungen.
Projekt-Website:https://humanaigc.github.io/omnitalker/
Technisches Paper:https://arxiv.org/pdf/2504.02433v1









