
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Was ist der Unterschied zwischen Llama 4 Scout und Maverick?
小编 ·

Was ist der Unterschied zwischen Llama 4 Scout und Maverick?
Am 5. April 2025 hat Meta die neueste Generation der Open-Source-ai-Modelle Llama 4 veröffentlicht, darunter Llama 4 Scout und Llama 4 Maverick. Beide KI-Modelle sind die ersten multimodalen Modelle, die eine Mixture-of-Experts-Architektur (MoE) verwenden – worin unterscheiden sie sich?
Die wichtigsten Unterschiede zwischen Llama 4 Scout und Llama 4 Maverick:
Llama 4 Scout
Parametergröße: 17 Milliarden aktive Parameter, 16 „Experten“-Modelle, mit einer Gesamtparameteranzahl von 109 Milliarden.
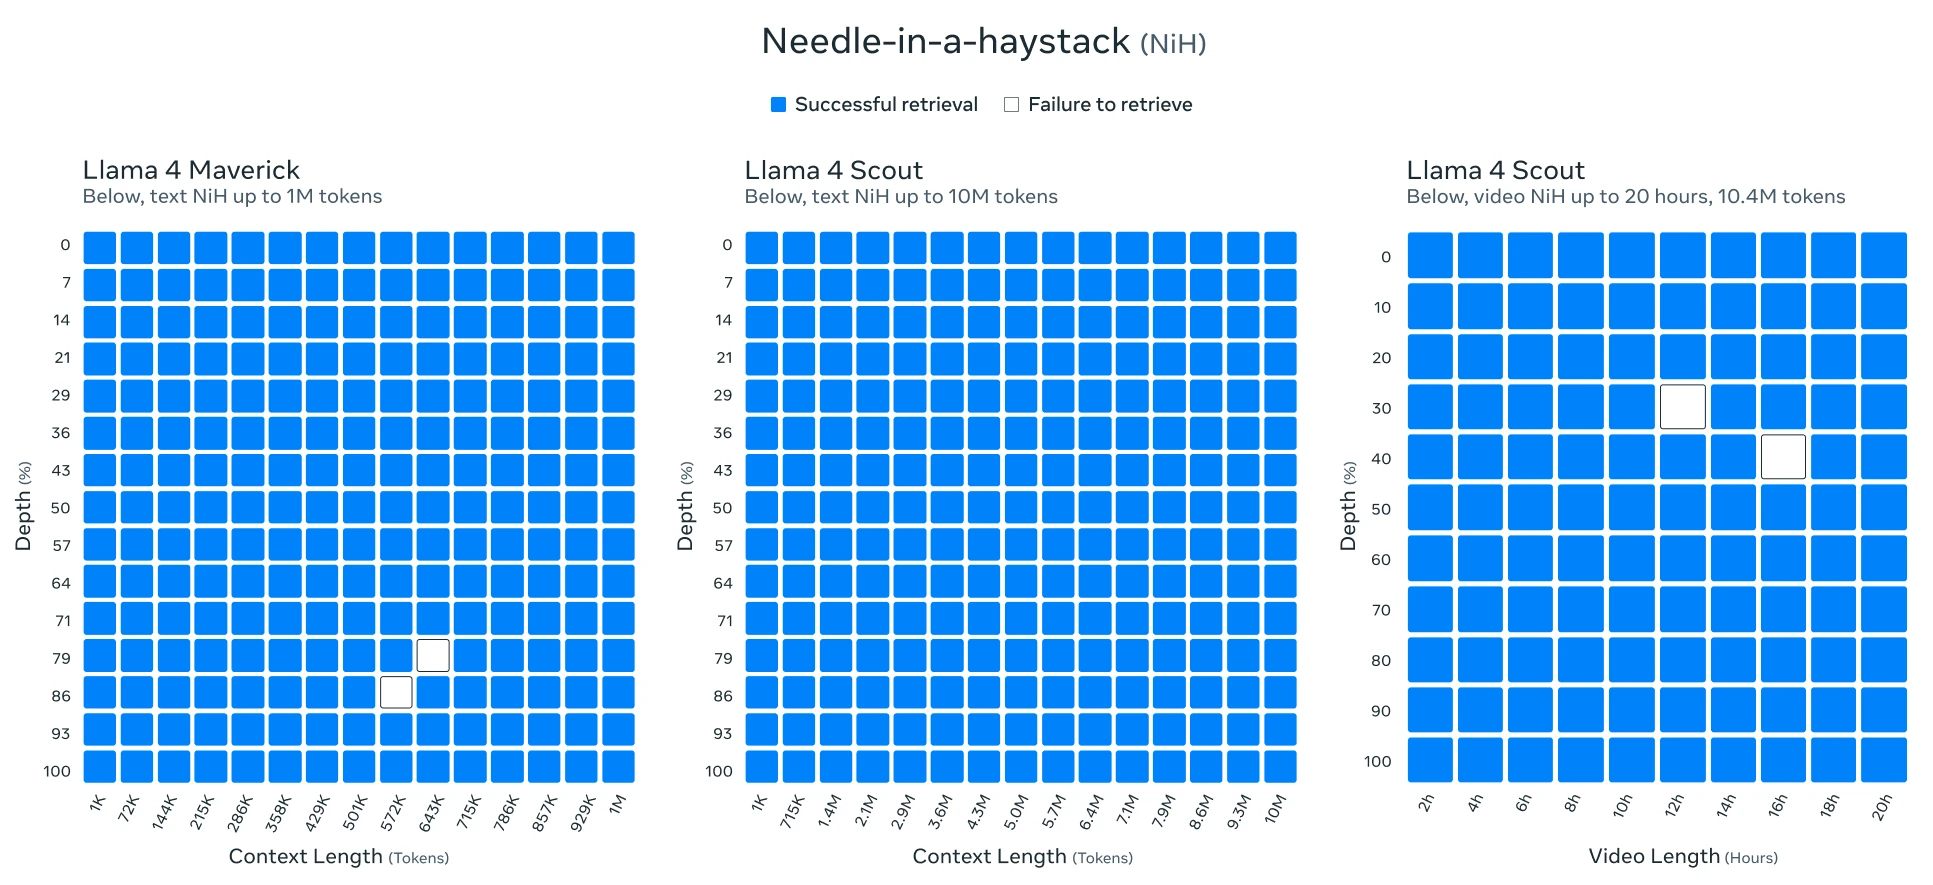
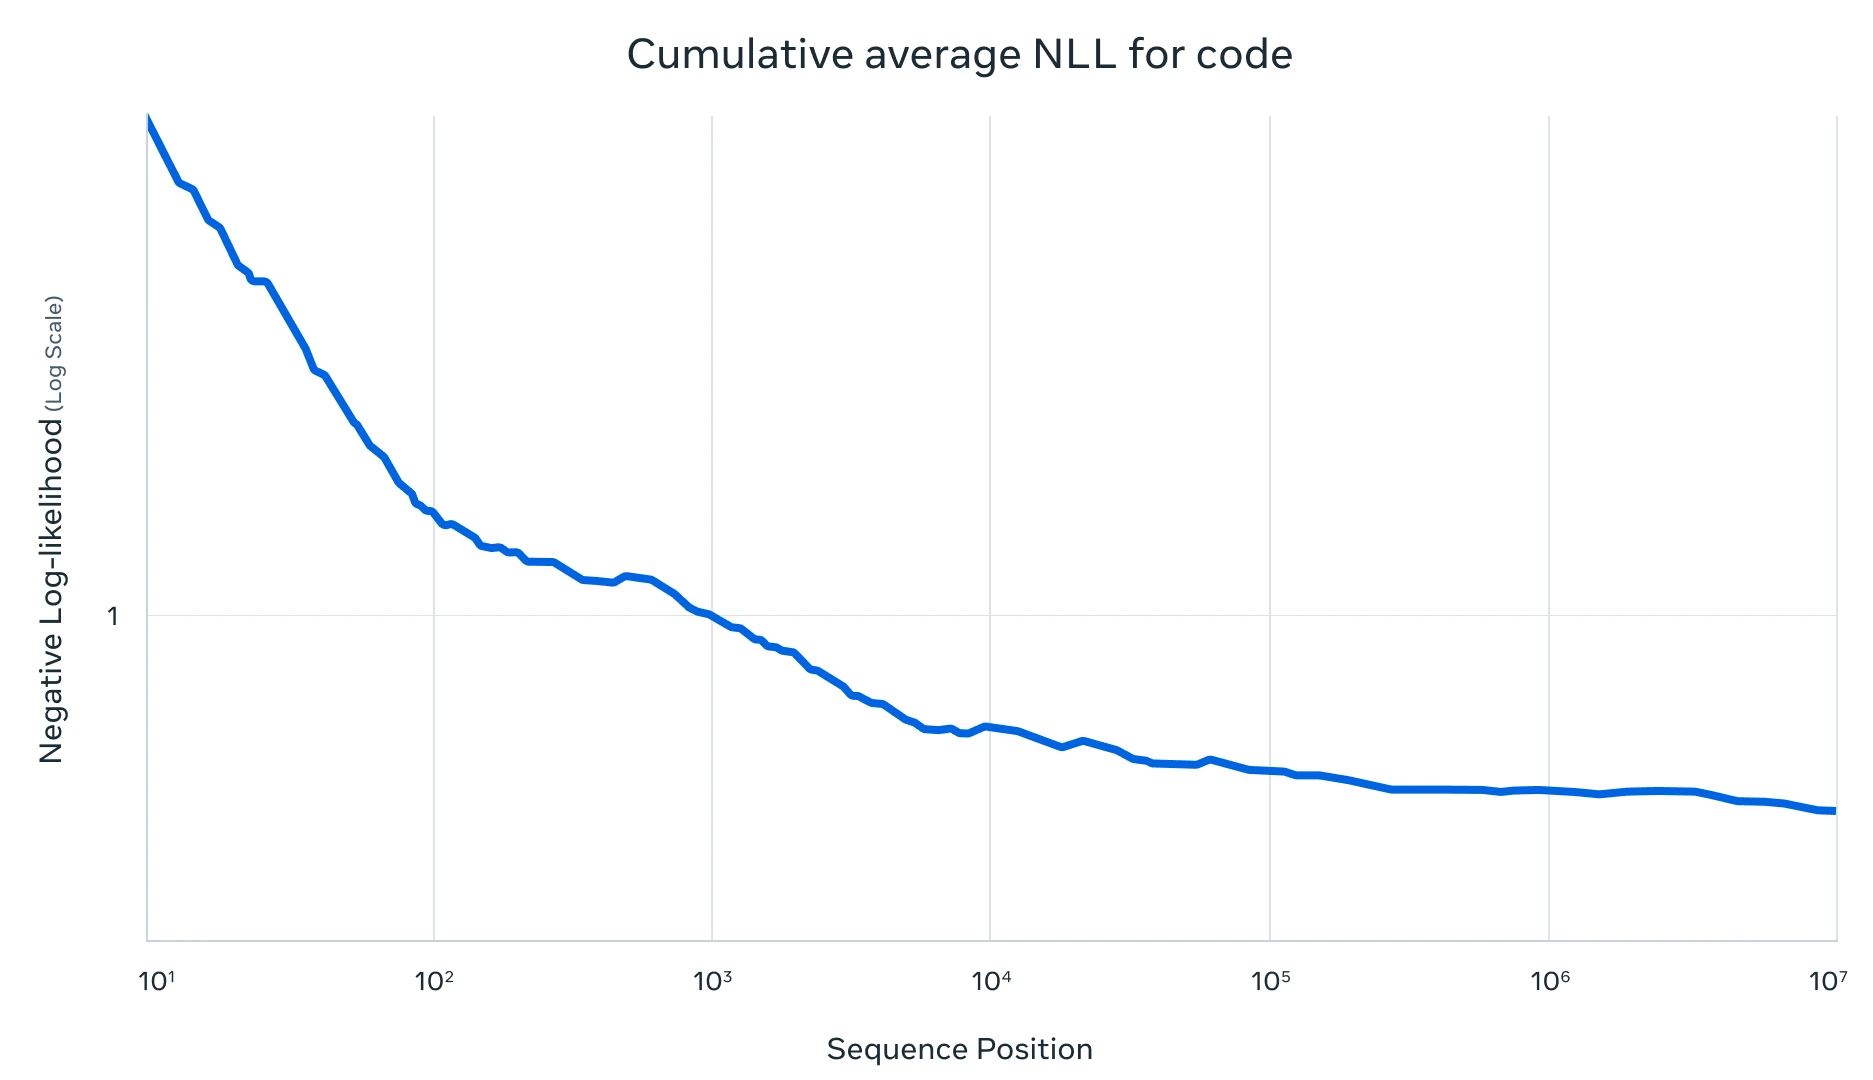
Kontextfenster: Unterstützt ein Kontextfenster von bis zu 10 Millionen Tokens, wodurch es sich besonders bei der Verarbeitung langer Dokumente hervortut.
Anwendungsfälle: Geeignet für Dokumentenzusammenfassungen und Schlussfolgerungen auf Basis großer Codebasen – ideal für Szenarien, die effizientes Reasoning und die Verarbeitung langer Texte erfordern.
Hardwareanforderungen: Kann auf einer einzelnen NVIDIA H100 GPU ausgeführt werden; nach Int4-Quantisierung ist der Ressourcenbedarf gering.
Llama 4 Maverick
Parametergröße: 17 Milliarden aktive Parameter, 128 „Experten“-Modelle, mit einer Gesamtparameteranzahl von bis zu 400 Milliarden.
Kontextfenster: Unterstützt ein Kontextfenster von 1 Million Tokens.
Anwendungsfälle: Übertrifft in kreativem Schreiben, Codegenerierung, Übersetzung, Reasoning, Zusammenfassung langer Textkontexte sowie bei Bild-Benchmarks Modelle wie OpenAIs GPT-4o und Googles Gemini 2.0.
Hardwareanforderungen: Erfordert den Betrieb auf einem NVIDIA H100 DGX-Host oder einer vergleichbaren Hardware.
Vergleich der beiden Modelle
Leistung: Maverick schneidet bei multimodalen Aufgaben und im Reasoning stärker ab, während Scout bei der Verarbeitung langer Texte und der Dokumentenzusammenfassung Vorteile bietet.
Ressourcenbedarf: Scout eignet sich besser für ressourcenbeschränkte Szenarien, da es auf einer einzelnen GPU laufen kann; Maverick erfordert eine höhere Hardwareausstattung.
Anwendungsfälle: Scout ist ideal für Szenarien mit umfangreichen Texten, etwa Dokumentenverarbeitung und Code-Reasoning; Maverick eignet sich besser für Aufgaben, die multimodale Interaktion und komplexes Reasoning erfordern, wie kreatives Schreiben und Bildverarbeitung.
Inferenzkosten
Llama 4 Scout: Aufgrund seiner geringeren Modellgröße und effizienten Quantisierungstechnik sind die Inferenzkosten relativ niedrig – ideal für Anwendungen, die schnelle Reaktion und geringen Ressourcenverbrauch erfordern.
Llama 4 Maverick: Obwohl die Gesamtparameteranzahl größer ist, wurden die Inferenzkosten durch die Mixture-of-Experts-Architektur ebenfalls optimiert. Meta schätzt die Inferenzkosten für Llama 4 Maverick auf 0,19 bis 0,49 US-Dollar pro 1 Million Tokens (bei einem Eingabe-Ausgabe-Verhältnis von 3:1), wodurch es deutlich günstiger ist als proprietäre Modelle wie GPT-4o.
Llama 4 Scout eignet sich besser für Szenarien, die lange Texte und ressourcenbeschränkte Umgebungen erfordern, während Llama 4 Maverick mit hervorragenden Reasoning- und Codegenerierungsfähigkeiten glänzt und ideal für Anwendungen ist, die hohe Leistung und multimodale Verarbeitung benötigen. Beide nutzen die Mixture-of-Experts-Architektur für eine effiziente Ressourcenauslastung, wobei der konkrete Ressourcenbedarf und die Kosten jedoch von deinem jeweiligen Anwendungsfall und deiner Hardware abhängen.









