
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Dolphin: Ein automatisiertes Spracherkennungsmodell für östliche Sprachen, gemeinsam veröffentlicht von Datatang und der Tsinghua-Universität
小编 ·

Dolphin: Ein automatisiertes Spracherkennungsmodell für östliche Sprachen, gemeinsam veröffentlicht von Datatang und der Tsinghua-Universität
Was ist Dolphin?
Dolphin ist ein automatisiertes Spracherkennungsmodell, das speziell für östliche Sprachen entwickelt wurde und gemeinsam von Haitianshen und dem Labor für Sprach- und Audiotechnologie der Fakultät für Elektrotechnik der Tsinghua-Universität entwickelt wurde.Dolphin unterstützt 40 östliche Sprachen und 22 chinesische Dialekte. Es bietet eine hohe Genauigkeit und starke Robustheit und kann sich an verschiedene komplexe Sprachumgebungen anpassen. Dolphin wird häufig in Szenarien wie Sprache-zu-Text, Sprachinteraktion und Analyse von Sprachinhalten eingesetzt und unterstützt die One-Click-Installation sowie mehrere Aufrufmethoden.
Modellmerkmale von Dolphin
Mehrsprachige Unterstützung: Dolphin unterstützt 40 östliche Sprachen, einschließlich Sprachen aus Ost-, Süd- und Südostasien sowie dem Nahen Osten, und zusätzlich 22 chinesische Dialekte (einschließlich Mandarin).
Sprachanpassung: Erkennt automatisch die Sprache der eingegebenen Sprache, ohne dass eine manuelle Angabe erforderlich ist.
Hohe Genauigkeit: Auf mehreren Testdatensätzen ist die Wortfehlerrate (WER) deutlich niedriger als bei vergleichbaren Modellen.
Hohe Robustheit: Passt sich an unterschiedliche Akzente, Sprechgeschwindigkeiten, Hintergrundgeräusche und andere komplexe Sprachumgebungen an.
Hohe Leistung: Im Vergleich zu Whisper-Modellen gleicher Größe auf den drei Testdatensätzen Haitianshen, Fleurs und CommonVoice weist Dolphin eine deutlich geringere Wortfehlerrate (WER) auf. Beispielsweise sinkt die durchschnittliche WER der Base-Version um 63,1 %, die durchschnittliche WER der Small-Version um 68,2 %.
Open Source: Die Base- und Small-Versionen des Dolphin-Modells sowie der Inferenzcode sind vollständig Open Source.
Technische Architektur von Dolphin
Netzwerkstruktur: Basierend auf der CTC-Attention-Architektur, verwendet einen E-Branchformer-Encoder und einen Transformer-Decoder mit einer 4-fachen Unterschicht. Diese Struktur kombiniert die Sequenzmodellierungsfähigkeiten von CTC mit der Kontexterfassungsfähigkeit des Aufmerksamkeitsmechanismus und kann die Erkennungsgenauigkeit und -effizienz des Modells effektiv verbessern.
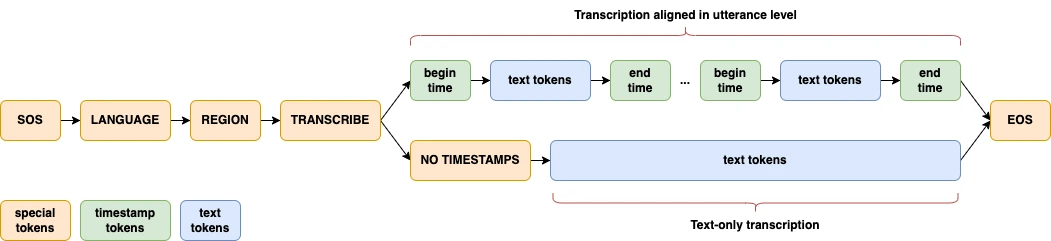
Multitasking-Format: Dolphin orientiert sich an den Designansätzen von Whisper und OWSM und konzentriert sich auf ASR, wobei einige wesentliche Änderungen vorgenommen wurden, wie z. B. die Entfernung der Verwendung von „previous text" und zugehöriger Tags, wodurch das Eingabeformat vereinfacht wird. Darüber hinaus führt Dolphin ein zweistufiges Sprachetikettensystem ein, um die Vielfalt von Sprachen und Regionen besser zu verarbeiten.
Datengrundlage
Der Trainingsdatensatz von Dolphin integriert proprietäre Daten von Haitianshen und mehrere Open-Source-Datensätze mit einer Gesamtdauer von über 212.000 Stunden. Davon enthält der Haitianshen-Datensatz 137.712 Stunden Audio, die 38 östliche Sprachen abdecken.
Anwendungsszenarien
Sprache zu Text: Geeignet für Szenarien wie Besprechungsaufzeichnungen und Spracheingabemethoden.
Sprachinteraktion: Wird in KI-Sprachassistenten, Smart-Home-Geräten usw. verwendet, um das Interaktionserlebnis zu verbessern.
Sprachinhaltsanalyse: Schnelle Transkription und Analyse von Sprachmedieninhalten.
Dolphin Nutzungsanleitung
Installation: Benutzer können mit dem Befehl pip install -U dataoceanai-dolphin eine One-Click-Installation durchführen.
Aufruf über die Kommandozeile: Beispielsweise kann mit dolphin audio.wav eine Spracherkennung durchgeführt werden, wobei auch die Modellversion sowie Sprach- und Regions-Tags angegeben werden können.
Python-Aufruf: Durch Importieren des dolphin -Moduls und Laden von Audio und Modell kann die Spracherkennung durchgeführt werden.
Verwandte Links
Github-Adresse: https://github.com/DataoceanAI/Dolphin
Projekt-Hauptseite: https://huggingface.co/DataoceanAI









