
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Speech-02: Ein leistungsstarkes Text-to-Speech-Modell (TTS) von MiniMax Audio
小编 ·

Speech-02: Ein leistungsstarkes Text-to-Speech-Modell (TTS) von MiniMax Audio
Was ist Speech-02?
MiniMax Audio Speech-02 ist ein leistungsstarkes Text-zu-Sprache-Modell (TTS), das jede Datei oder URL sofort in realistisches Audio umwandeln kann. Es unterstützt Eingaben von bis zu 200.000 Zeichen pro Aufruf, deckt über 30 Sprachen ab und bietet authentische Akzente. Darüber hinaus unterstützt Speech-02 unbegrenztes Voice Cloning, Sub-Sekunden-Streaming-Verarbeitung sowie mehrere Audioformate (wie FLAC, WAV, MP3 und PCM).
Das Speech-02-Modell ist in zwei Versionen verfügbar: speech-02-hd-preview (zeichnet sich durch 99 % Stimmähnlichkeit und Studioqualität aus und eignet sich für Synchronisation, Hörbücher und andere Szenarien, die realistische Leistung erfordern) und speech-02-turbo-preview (bietet ein Gleichgewicht zwischen niedriger Latenz und hoher Leistung und eignet sich für Echtzeitanwendungen).
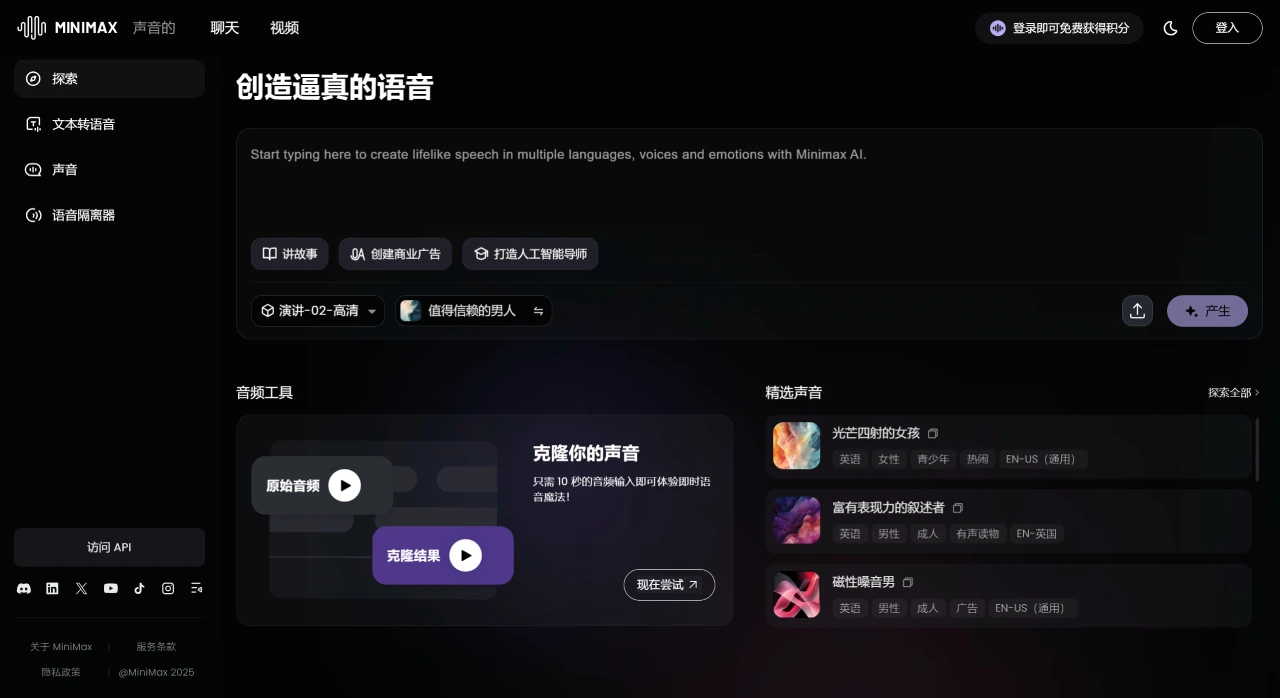
Sprach- und Stimmfähigkeiten
Mehrsprachige Unterstützung: Speech-02 unterstützt Text-zu-Sprache in über 30 Sprachen, darunter Englisch, Chinesisch, Japanisch, Koreanisch, Französisch, Deutsch, Spanisch, Portugiesisch, Italienisch, Arabisch, Russisch, Türkisch, Niederländisch, Ukrainisch, Vietnamesisch, Hindi, Thai, Polnisch, Rumänisch, Griechisch, Finnisch und Indonesisch, jeweils mit authentischen Akzenten.
Umfangreiche Stimmbibliothek: Über 300 natürlich klingende Stimmen, die authentische Ausdrucksformen in mehreren Sprachen unterstützen.
Technische Leistung
Zeichen pro Eingabe: Bis zu 200.000 Zeichen pro einzelner Eingabe.
Streaming-Geschwindigkeit: Unterstützt Streaming-Verarbeitung im Sub-Sekunden-Bereich.
Modellversionen: Umfasst speech-02-hd-preview und speech-02-turbo-preview. Erstere zeichnet sich durch 99 % Stimmähnlichkeit und Studioqualität aus und eignet sich für Synchronisation, Hörbücher und andere Szenarien, die realistische Leistung erfordern; Letztere bietet ein Gleichgewicht zwischen niedriger Latenz und hoher Leistung und eignet sich für Echtzeitanwendungen.
Funktionsmerkmale von Speech-02
Unbegrenztes Voice Cloning: Kann mit branchenführender Qualität schnell Stimmen in verschiedenen Stilen und Tonlagen klonen.
Stimmsteuerung: Benutzer können Emotion, Lautstärke, Geschwindigkeit und Ausgabeformat der Stimme einfach steuern.
Stimm-Mixing: Bestehende Stimmen können kombiniert werden, um völlig neue, einzigartige Stimmen zu erzeugen.
Unterstützte Audioformate: Unterstützt mehrere Audioformate wie FLAC, WAV, MP3 und PCM.
Anwendungsszenarien für Speech-02
Hörbuchproduktion: Geeignet, um Romane, wissenschaftliche Arbeiten und mehr in hochwertige Audioinhalte umzuwandeln.
Podcast-Erstellung: Hilft Podcastern, ansprechendere und vielfältigere Inhalte zu produzieren.
Film- und Spielsynchronisation: Bietet kinoähnliche Bässe und immersive Audioeffekte.
Internationale Konferenzen und Übersetzung: Unterstützt sofortigen, nahtlosen Wechsel zwischen mehreren Sprachen.
Derzeit ist das Speech-02-Modell auf der MiniMax Audio-Plattform und der API-Plattform verfügbar, wurde jedoch noch nicht für den chinesischen Markt veröffentlicht.
Offizielle Links
MiniMax Audio-Plattform: https://www.minimax.io/audio
MiniMax Audio API-Plattform: https://www.minimax.io/platform









