
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
SegAnyMo: Bewegte Objekte in Videos automatisch erkennen und präzise segmentieren
小编 ·

SegAnyMo: Bewegte Objekte in Videos automatisch erkennen und präzise segmentieren
Was ist SegAnyMo?
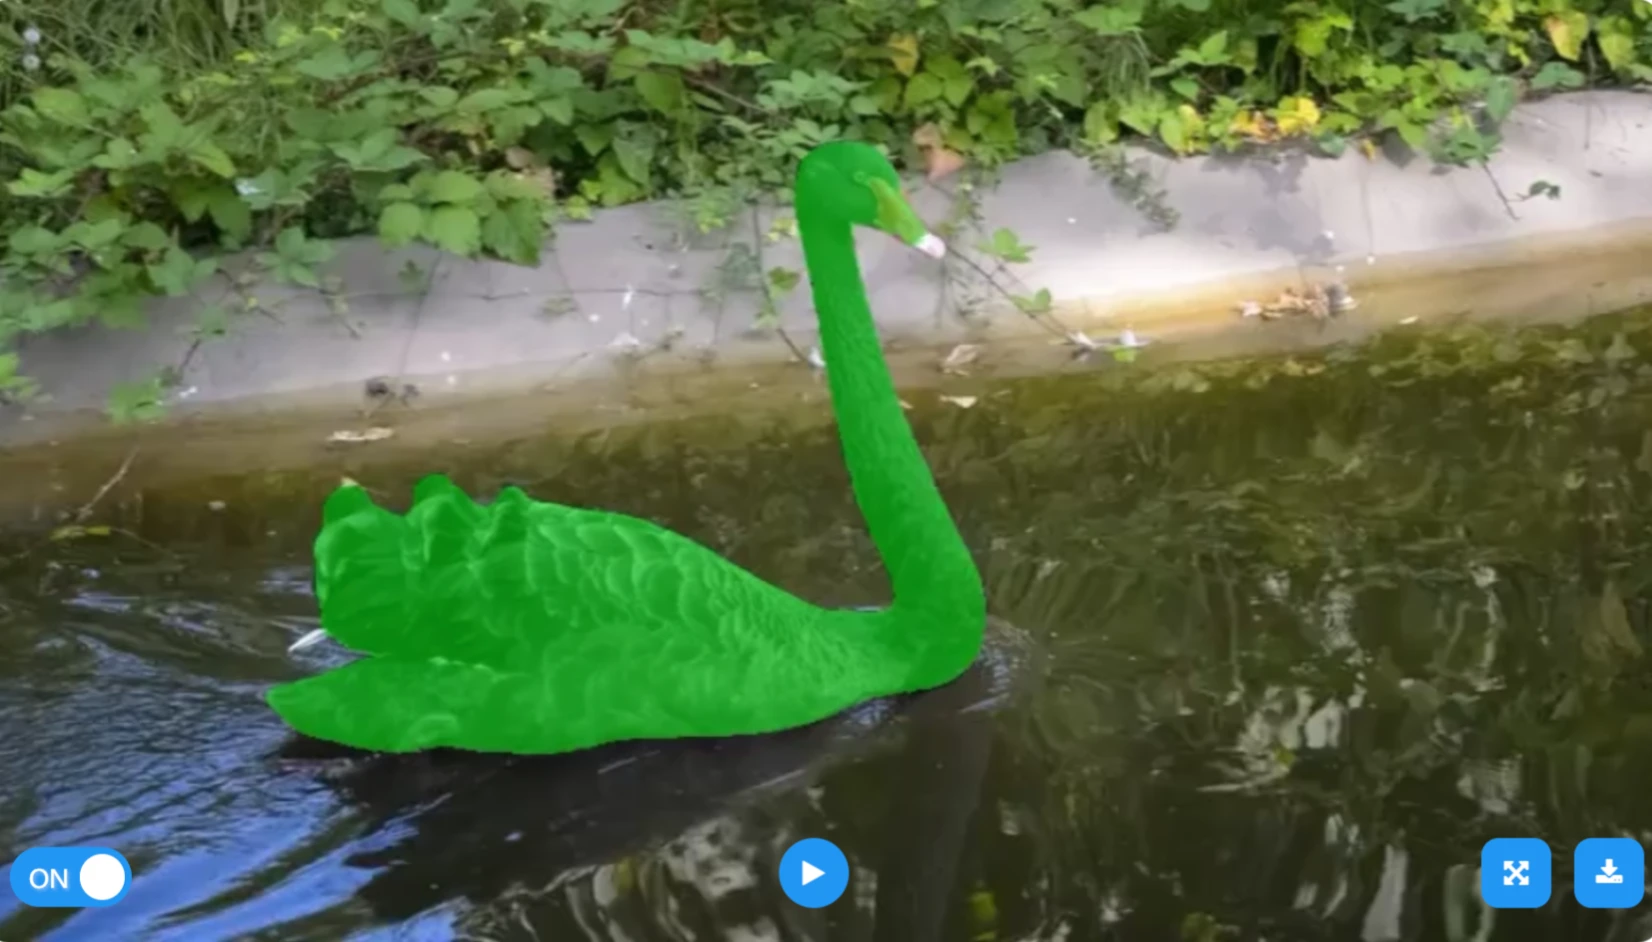
SegAnyMo (Segment Any Motion in Videos) ist ein intelligentes „VideoFreistellung"Tool. Es kann bewegte Objekte in Videos automatisch erkennen und präzise segmentieren, es benötigt keine manuelle Annotation, um mehrere bewegte Objekte in einem Video zu segmentieren, und kann Szenen verarbeiten, in denen sich Objekte zu schnell bewegen, das Bild unscharf ist oder der Hintergrund komplex ist.
Forschungshintergrund
Die Segmentierung bewegter Objekte ist eine Schlüsselaufgabe für ein hochrangiges Verständnis visueller Szenen und hat zahlreiche nachgelagerte Anwendungen. Frühere Forschungen stützten sich meist auf optischen Fluss, um Bewegungsinformationen zu liefern, aber dieser Ansatz führt bei Herausforderungen wie Teilbewegung, komplexer Verformung, Bewegungsunschärfe und Hintergrundstörungen oft zu ungenauen Vorhersagen.
Methode
Diese Forschung stellt eine neue Methode zur Segmentierung bewegter Objekte vor, die langreichweitige Trajektorien-Bewegungsinformationen mit auf DINO basierenden semantischen Merkmalen kombiniert und SAM2 mithilfe einer iterativen Prompting-Strategie zur pixelweisen Maskenverdichtung nutzt. Der konkrete Ablauf ist wie folgt:
Eingabeverarbeitung: Als Eingabe dienen 2D-Trajektorien und Tiefenkarten, die von bestehenden Modellen erzeugt werden. Ein Bewegungs-Encoder erfasst Bewegungsmuster und erzeugt Merkmalstrajektorien.
Trajektoriendecodierung: Ein Trajektoriendecoder, der DINO-Merkmale integriert, decodiert die Merkmalstrajektorien, entkoppelt Bewegungs- und Semantikinformationen und liefert schließlich dynamische Trajektorien.
Maskengenerierung: SAM2 gruppiert die zum selben Objekt gehörenden dynamischen Trajektorien und erzeugt feine Masken der bewegten Ziele.
Funktionen von SegAnyMo
Erkennung und Segmentierung bewegter Ziele: Erkennt automatisch bewegte Objekte in Videos und erzeugt entsprechende Segmentierungsmasken, die Umriss und Position der bewegten Objekte präzise kennzeichnen.
Verarbeitung komplexer Szenen: Bewältigt komplexe Szenen mit Teilbewegung, komplexer Verformung, Bewegungsunschärfe und Hintergrundstörungen und segmentiert die Zielobjekte weiterhin präzise.
Mehrfachzielsegmentierung: Kann mehrere bewegte Ziele in einem Video gleichzeitig erkennen und segmentieren und für jedes Ziel eine eigene Segmentierungsmaske erzeugen, was die Einzelverarbeitung und -analyse erleichtert.
Generalisierungsfähigkeit: Verfügt über eine starke Generalisierungsfähigkeit und kann sich an unterschiedliche Video-Datensätze und Szenen anpassen, wobei es auch in unbekannten Szenen eine hohe Segmentierungsgenauigkeit beibehält.
Kombination semantischer Informationen: Durch die Kombination semantischer Informationen werden bewegte Ziele genauer segmentiert und Fehlklassifikationen von statischen Objekten als bewegt vermieden.
Echtzeitfähigkeit und Effizienz: Erfüllt in gewissem Maße Echtzeitverarbeitungsanforderungen und kann in Szenen mit hohen Echtzeitanforderungen eingesetzt werden.
Unterstützung mehrerer Eingaben: Unterstützt verschiedene Eingabedaten wie 2D-Trajektorien und Tiefenkarten und kann die Segmentierungsstrategie flexibel an unterschiedliche Eingabebedingungen anpassen.
Erweiterbarkeit: Die Architektur ist gut erweiterbar und kann durch Hinzufügen oder Anpassen von Modulen die Leistung verbessern oder an neue Aufgabenanforderungen angepasst werden.
Technische Vorteile
Aufmerksamkeitsmechanismus für räumlich-zeitliche Trajektorien: Durch diesen Mechanismus kann das Modell Bewegungsinformationen besser fokussieren und gleichzeitig semantische Unterstützung einbeziehen, sodass es bewegte Ziele auch in komplexen Szenen genau segmentiert.
Entkoppeltes Bewegungs-Semantik-Embedding: Vermeidet Fehlurteile, die durch eine übermäßige Abhängigkeit des Modells von semantischen Informationen entstehen, wie z. B. die fälschliche Klassifizierung einer statischen Fahrbahn als dynamisches Objekt.
Starke Generalisierungsfähigkeit: Umfangreiche Tests an mehreren Datensätzen zeigen, dass das Modell in anspruchsvollen Szenen und bei der feinkörnigen Segmentierung mehrerer Ziele hervorragende Leistungen erbringt.
Anwendungsszenarien
Videoüberwachung: Echtzeit-Erkennung von bewegten Zielen wie Fußgängern und Fahrzeugen, Reduzierung von Fehlalarmen und Verbesserung der Genauigkeit von Sicherheitsüberwachung.
Autonomes Fahren: Erkennung dynamischer Hindernisse auf der Straße zur Unterstützung von Entscheidungen beim autonomen Fahren.
Sportvideoanalyse: Segmentierung von Sportlerbewegungen, Unterstützung der Analyse komplexer Bewegungen und Szenen mit mehreren Personen.
Intelligente Sicherheit: Vermeidung von Fehlalarmen durch statische Objekte, Erhöhung der Systemzuverlässigkeit.
Videobearbeitung: Klassifizierung und Verarbeitung verschiedener bewegter Ziele zur Erleichterung des Hinzufügens von Effekten und des Austauschens von Zielen.
Verkehrsüberwachung: Analyse der Bewegung mehrerer Fahrzeuge zur Unterstützung des Verkehrsflussmanagements.
RoboterVision: Nutzung von Tiefenkarten zur Segmentierung bewegter Ziele, Unterstützung der Roboter-Navigation und Hindernisvermeidung.
Mehrpersonen-Videokonferenzen: Segmentierung der Bilder der Sprecher zur Verbesserung des Interaktionserlebnisses.
Forschung und Entwicklung: Open-Source-Code erleichtert die Reproduktion und Weiterentwicklung und unterstützt das Training und Testen mit neuen Datensätzen.
Projekt-Website:https://motion-seg.github.io/
Github-Adresse:https://github.com/nnanhuang/SegAnyMo









