
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
VideoMind: All-in-One-Video-KI-Tool für automatisierte Produktion, Langvideo-Reasoning und Video-Zusammenfassungen
小编 ·

VideoMind: All-in-One-Video-KI-Tool für automatisierte Produktion, Langvideo-Reasoning und Video-Zusammenfassungen
Was ist VideoMind?
VideoMind ist ein Video-KI-Tool, das Funktionen wie die automatisierte Produktion von KI-Modellen für Videos, Langvideo-Reasoning und Videozusammenfassungen in sich vereint. Es basiert auf prozessbasierten Abläufen mit einem hohen Automatisierungsgrad, verfügt über integrierte umfangreiche Daten und ermöglicht das schnelle Training hochwertiger Modelle. Durch die Chain-of-LoRA-Strategie wird zudem ein präzises Langvideo-Reasoning mit genauer Lokalisierung und Generierung von Antworten ermöglicht. Darüber hinaus können mit einem Klick Videozusammenfassungen erstellt werden, die den Nutzern helfen, Schlüsselinformationen schnell zu extrahieren und die Effizienz der Videobearbeitung zu steigern.
Funktionsmerkmale von VideoMind
Umfassende Funktionen: Integriert alle Schritte von der Modellerstellung bis zur Veröffentlichung, einschließlich der 7 Phasen: neues Modell erstellen, Tags anlegen, Daten hochladen, Daten annotieren, Modell trainieren, Evaluierung und Validierung sowie Modell veröffentlichen.
Umfangreiche Daten: Integriert annotierte Daten von bis zu einer Million Stunden und verfügt über eine riesige Auswahl an vordefinierten Themen- und Entitätstags. Wenn ein vom Nutzer angelegter Tag erfolgreich auf einen internen Tag abgebildet werden kann, müssen für diesen Tag keine Daten hochgeladen oder annotiert werden.
Hohe Produktionseffizienz: Einerseits senkt der automatisierte Produktionsprozess die technische Hürde und spart den Kunden Entwicklungszeit; andererseits ermöglichen die integrierten vortrainierten KI-Netzwerkstrukturen und Parameter ein schnelles Training und eine zügige Iteration der Modelle.
Hohe Modellqualität: Dank der langjährigen Erfahrung von Baidu im Bereich KI liefern die mit VideoMind erstellten Modelle hervorragende Ergebnisse und unterstützen die Analyse vertikaler Video- und Bildinhalte in Unternehmen.
Flexible Bereitstellung: Die trainierten Modelle können in der Public Cloud, Private Cloud oder auf Embedded-Geräten bereitgestellt und anschließend per API aufgerufen werden.
Zusammenfassung mit einem Klick: Mit einem Klick lassen sich Videozusammenfassungen, Übersetzungen und Formatierungen von Social-Media-Beiträgen erstellen.
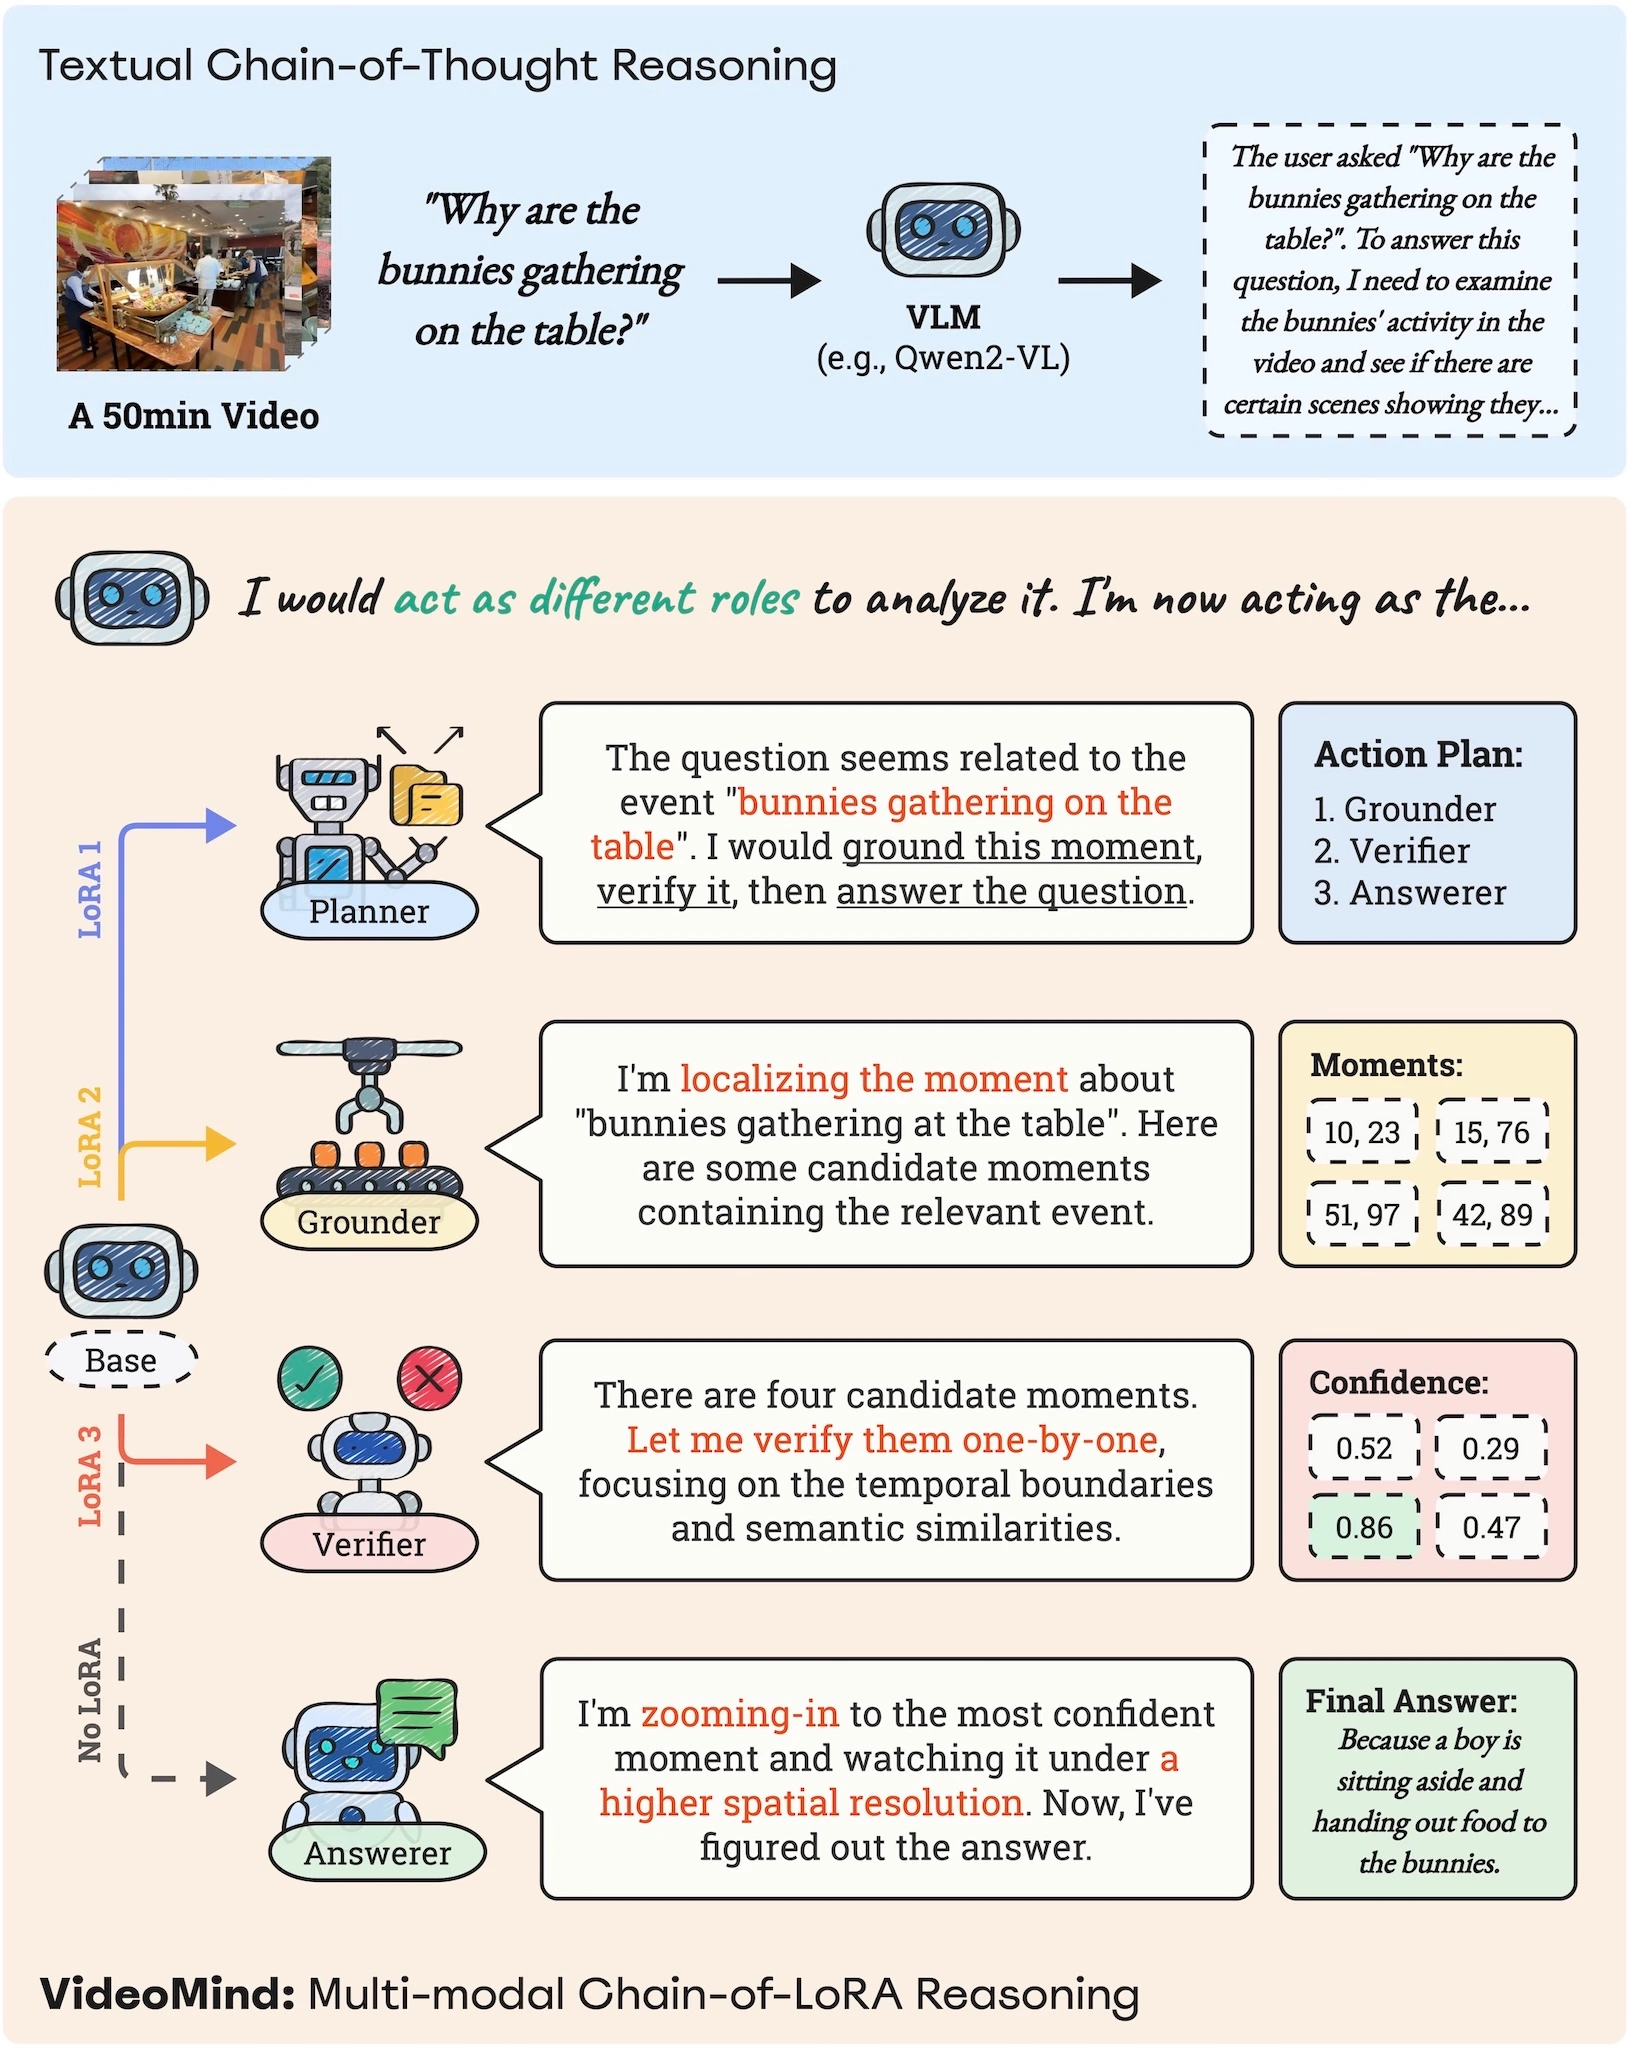
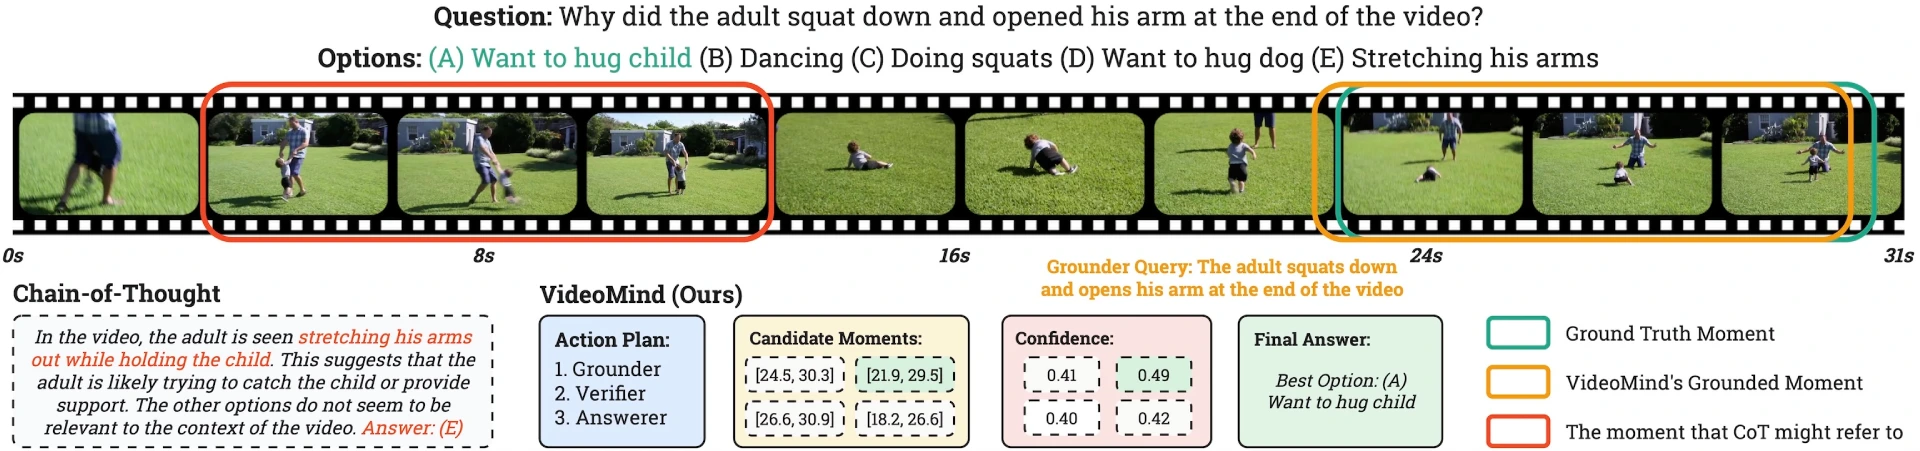
Langvideo-Reasoning-Fähigkeit: Durch einen rollenbasierten Workflow (bestehend aus Planner, Grounder, Verifier und Answerer) und die Chain-of-LoRA-Strategie wird eine präzise zeitliche Lokalisierung und ein exaktes Reasoning in langen Videos ermöglicht, sodass komplexe Videoverstehensaufgaben effizient bewältigt werden.
Schnelles Extrahieren von Schlüsselinformationen: Hilft Nutzern, die wichtigsten Informationen aus YouTube-Videos schnell und präzise zu analysieren und zusammenzufassen, und spart so Zeit und Aufwand.
Chain-of-LoRA-Agent für Langvideo-Reasoning
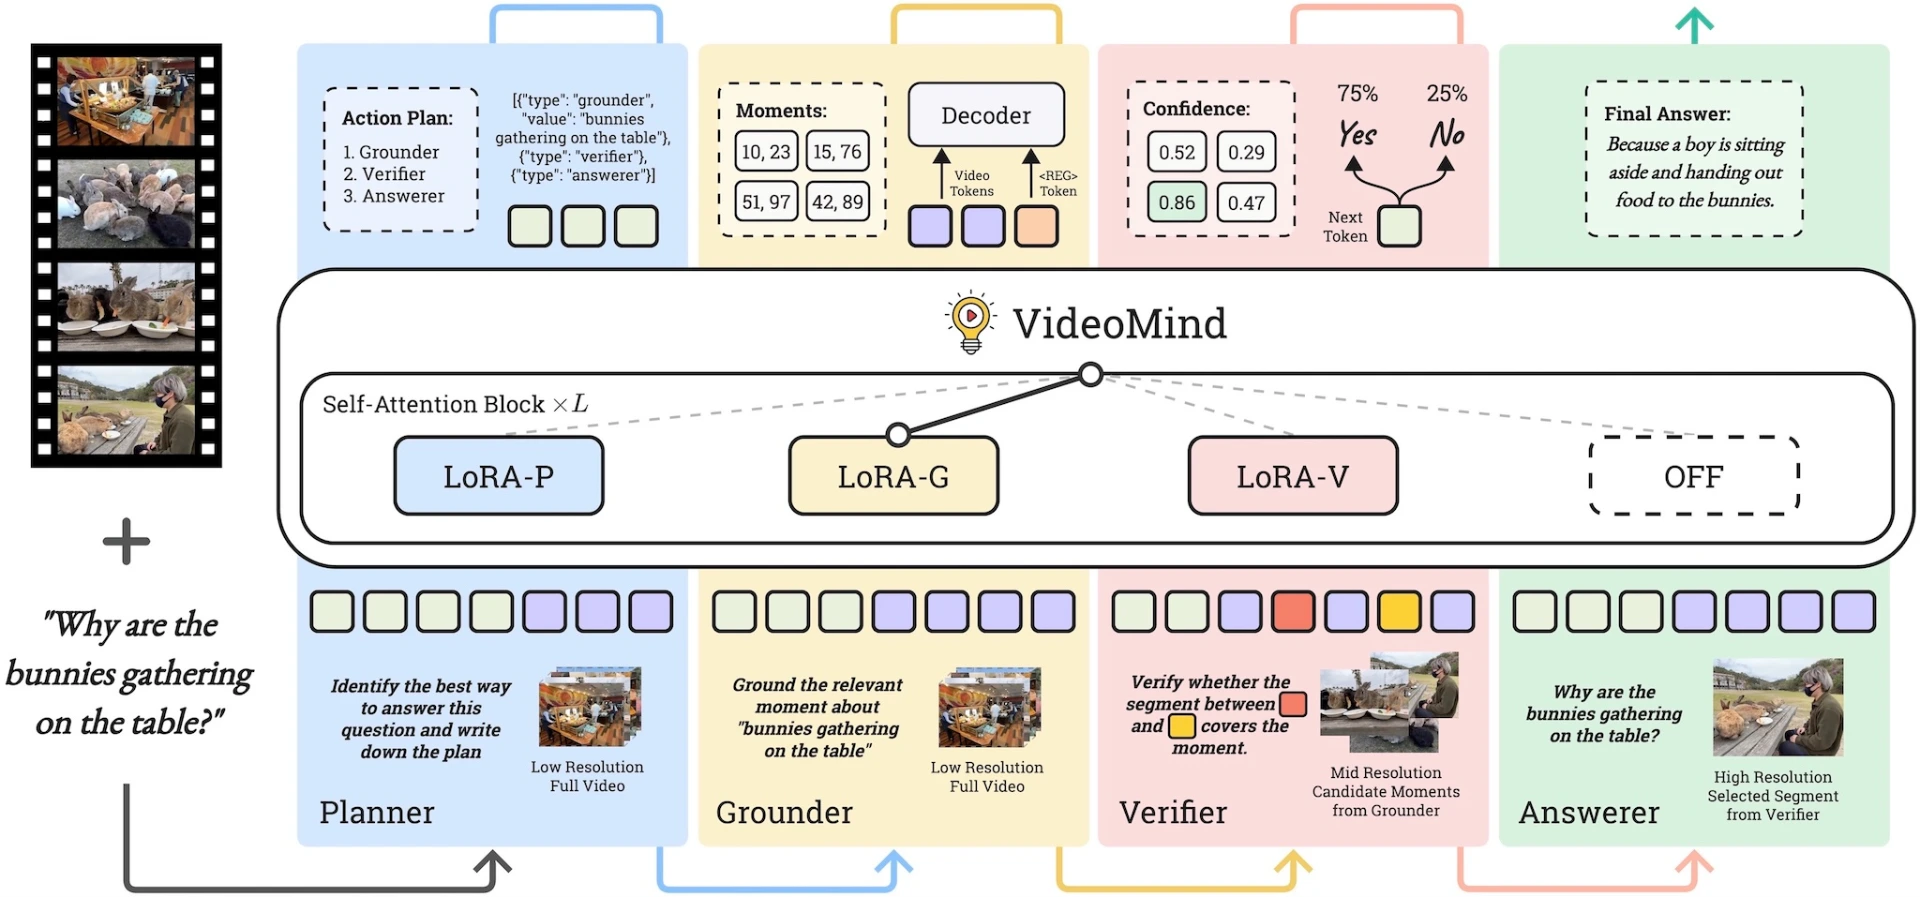
Rollenbasierter Workflow: Definiert vier Rollen, die zusammenarbeiten, um Langvideo-Reasoning zu realisieren – Planner, Grounder, Verifier und Answerer.
Planner: Koordiniert dynamisch die Aufrufreihenfolge der anderen Rollen basierend auf der Anfrage.
Grounder: Lokalisiert basierend auf Textanfragen präzise die relevanten Stellen im Video.
Verifier: Überprüft die Genauigkeit der Ergebnisse des Grounders.
Answerer: Generiert die endgültige Antwort in natürlicher Sprache.
Chain-of-LoRA-Strategie: Basierend auf einem Vision-Language-Modell werden zur Inferenzzeit rollenspezifische LoRA-Adapter dynamisch aktiviert, um die oben genannten Rollen effizient zu integrieren.
Hervorragende Leistung: Erzielt in mehreren öffentlichen Benchmarks herausragende Ergebnisse, darunter bei detaillierten Video-Question-Answering-Aufgaben, Videotemporallokalisierungsaufgaben und allgemeinen Video-Question-Answering-Aufgaben.
Anwendungsszenarien von VideoMind
Bildungsbereich: Studierende können schnell die Kerninhalte von Lehrvideos erfassen und so beim Lernen und Wiederholen unterstützt werden.
Business-Analyse: Unternehmen können Marktforschungsvideos zusammenfassen lassen und so rasch Branchentrends und Wettbewerberinformationen gewinnen.
Content-Erstellung: Video-Creator können die Highlights ihrer Videos herausarbeiten und Werbematerialien oder Social-Media-Inhalte erstellen.
Unterhaltungskonsum: Nutzer können beim Ansehen langer Videos schnell den Hauptinhalt erfassen und so entscheiden, ob sie das gesamte Video ansehen möchten.
Social Media: Auf Kurzvideo-Plattformen können Nutzer Highlights aus Videos extrahieren und ansprechende Kurzvideo-Inhalte erstellen.
Verwandte Links
Projektseite:https://videomind.github.io/
Github-Adresse:https://github.com/yeliudev/VideoMind
Demo:https://huggingface.co/spaces/yeliudev/VideoMind-2B
Paper:https://arxiv.org/abs/2503.13444









