
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
QVQ-Max: Alibabas Visual-Reasoning-Modell, das Bilder und Videos versteht
小编 ·

QVQ-Max: Alibabas Visual-Reasoning-Modell, das Bilder und Videos versteht
Was ist QVQ-Max?
QVQ-Max ist ein visuelles Schlussfolgerungsmodell, das in der Lage ist, die Inhalte von Bildern und Videos zu verstehen, auf Grundlage relevanter Informationen Analysen und Schlussfolgerungen durchzuführen und Lösungen bereitzustellen. Das QVQ-Max-Modell zeigt in vielen Bereichen hervorragende Leistungen, etwa bei der Lösung mathematischer Aufgaben, der Bearbeitung von Alltagsfragen, der Programmierunterstützung sowie der künstlerischen Gestaltung.
Designursprung
Herkömmliche KI-Modelle basieren meist auf Texteingaben, doch in der Realität liegen viele Informationen in Form von Bildern, Diagrammen oder Videos vor. QVQ-Max zielt darauf ab, einen Assistenten zu schaffen, der visuelle Informationen geschickt erfasst und gleichzeitig eine schnelle Analysefähigkeit besitzt, um Nutzern bei der Lösung verschiedener praktischer Probleme zu helfen.
Kernfähigkeiten von QVQ-Max
Detailgenaues Beobachten: QVQ-Max kann Schlüsselelemente in Bildern schnell erkennen – egal ob komplexe Diagramme oder alltägliche Fotos, es erfasst die Details.
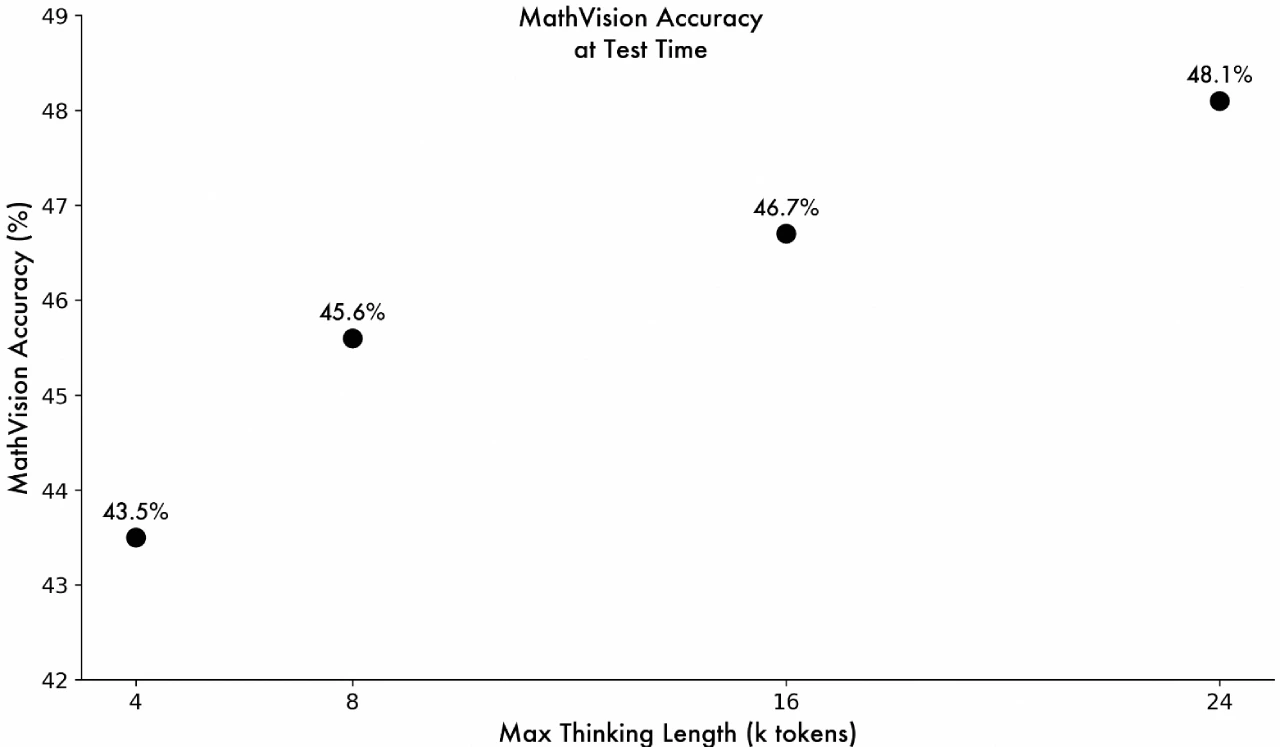
Tiefgehende Schlussfolgerung: Das Modell erkennt nicht nur Inhalte, sondern kann auch Hintergrundwissen für Schlussfolgerungen heranziehen. Beispielsweise kann es geometrische Figuren in Aufgaben analysieren und die Antwort ableiten.
Flexible Anwendung: Neben Analyse und Schlussfolgerung kann QVQ-Max auch für kreative Aufgaben eingesetzt werden, etwa zum Entwerfen von Illustrationen, zum Erstellen von Skripten für kurze Videos oder zum Generieren von Rollenspielinhalten nach Nutzerwunsch.
Anwendungsszenarien von QVQ-Max
Berufliche Anwendung: Unterstützung bei Datenanalyse, Informationsaufbereitung und Programmierung.
Lernhilfe: Unterstützung bei der Lösung schwieriger Aufgaben in Mathematik, Physik und anderen Fächern, insbesondere bei Aufgaben mit Diagrammen.
Unterstützung im Alltag: Bietet Outfit-Vorschläge auf Grundlage von Fotos des Kleiderschranks oder Kochanleitungen anhand von Rezeptbildern.
Nutzungsanleitung für QVQ-Max
1. Rufen Sie https://chat.qwen.ai/ auf
2. Wählen Sie das Modell QWQ-32B aus
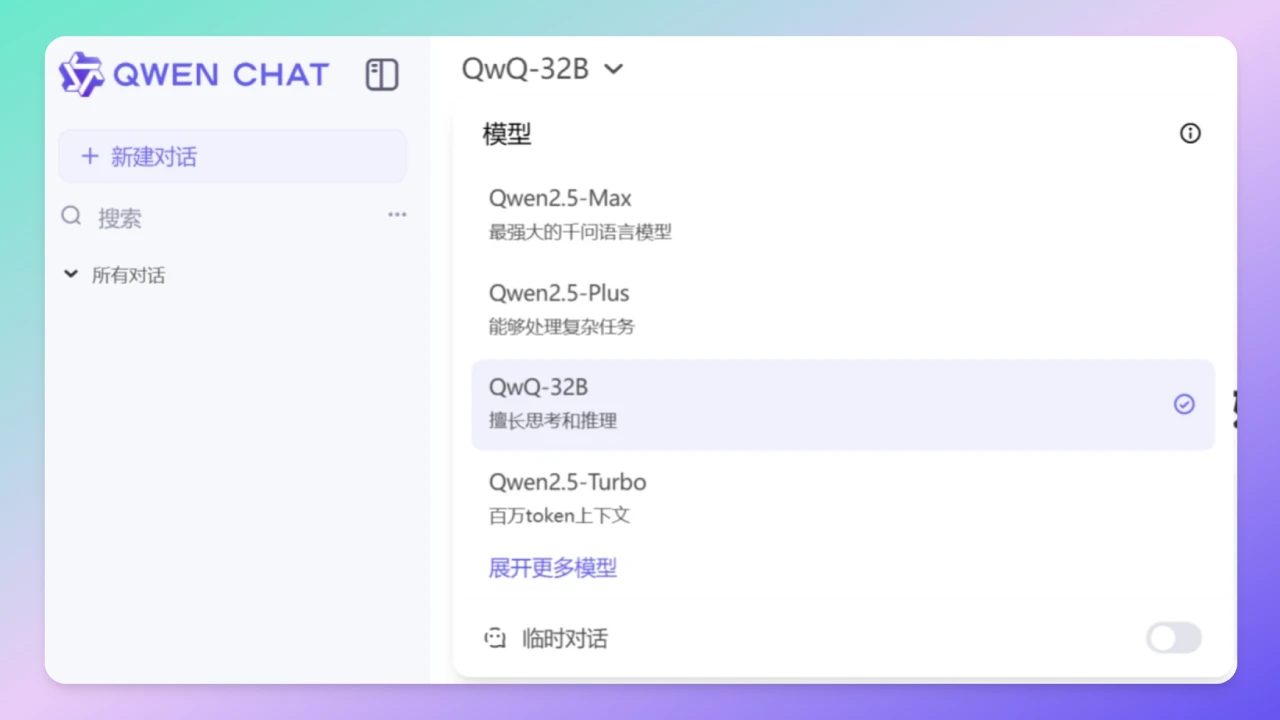
3. Klicken Sie im Eingabefeld auf das „+“-Zeichen, um ein Bild oder Video hochzuladen.
4. Stellen Sie eine Frage zum Inhalt des Bildes.
Zukünftige Entwicklungsrichtung
Verbesserung der Beobachtungsfähigkeit: Mittels Techniken zur Überprüfung visueller Inhalte (wie Grounding) wird die Erkennungsgenauigkeit erhöht.
Stärkung der Aufgabenverarbeitung: Entwicklung eines visuellen Agenten, um die Fähigkeit zur Bearbeitung mehrstufiger und komplexer Aufgaben zu verbessern, etwa das Bedienen von Smartphones oder Computern oder das Spielen von Spielen.
Optimierung des Interaktionserlebnisses: Erweiterung der Interaktionsmodalitäten, einschließlich Tool-Überprüfung sowie visueller Generierung.
QVQ-Max als visuelles Schlussfolgerungsmodell besitzt ein enormes Potenzial. Es kann nicht nur Bildinhalte erkennen, sondern Informationen auch analysieren und Schlussfolgerungen ziehen und sogar einige kreative Aufgaben bewältigen. Obwohl es sich derzeit erst um die erste Version handelt, zeigt es bereits großes Potenzial und könnte in Zukunft ein praktischer visueller Agent werden, der den Nutzern eine starke Unterstützung bei der Lösung realer Probleme bietet.
Ausführliche Einführung: https://qwenlm.github.io/zh/blog/qvq-max-preview/
Nutzungsadresse: https://chat.qwen.ai/









