
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Qwen2.5-Omni: Alibabas End-to-End Multimodal-Flaggschiff-Modell
小编 ·

Qwen2.5-Omni: Alibabas End-to-End Multimodal-Flaggschiff-Modell
Was ist Qwen2.5-Omni?
Qwen2.5-Omni ist das neue Flaggschiff-Modell der nächsten Generation für Ende-zu-Ende-Multimodalität aus der von Alibaba veröffentlichten Qwen-Serie. Es wurde speziell für umfassende multimodale Wahrnehmung entwickelt, das heißt, es kann Text, Audio, Bilder und Videos verstehen, gleichzeitig denken und sprechen und durch Echtzeit-Streaming-Antworten sowohl Text als auch natürliche Sprachsynthese-Ausgaben erzeugen – ein KI-Modell.
Kernmerkmale von Qwen2.5-Omni
Innovative Architektur:
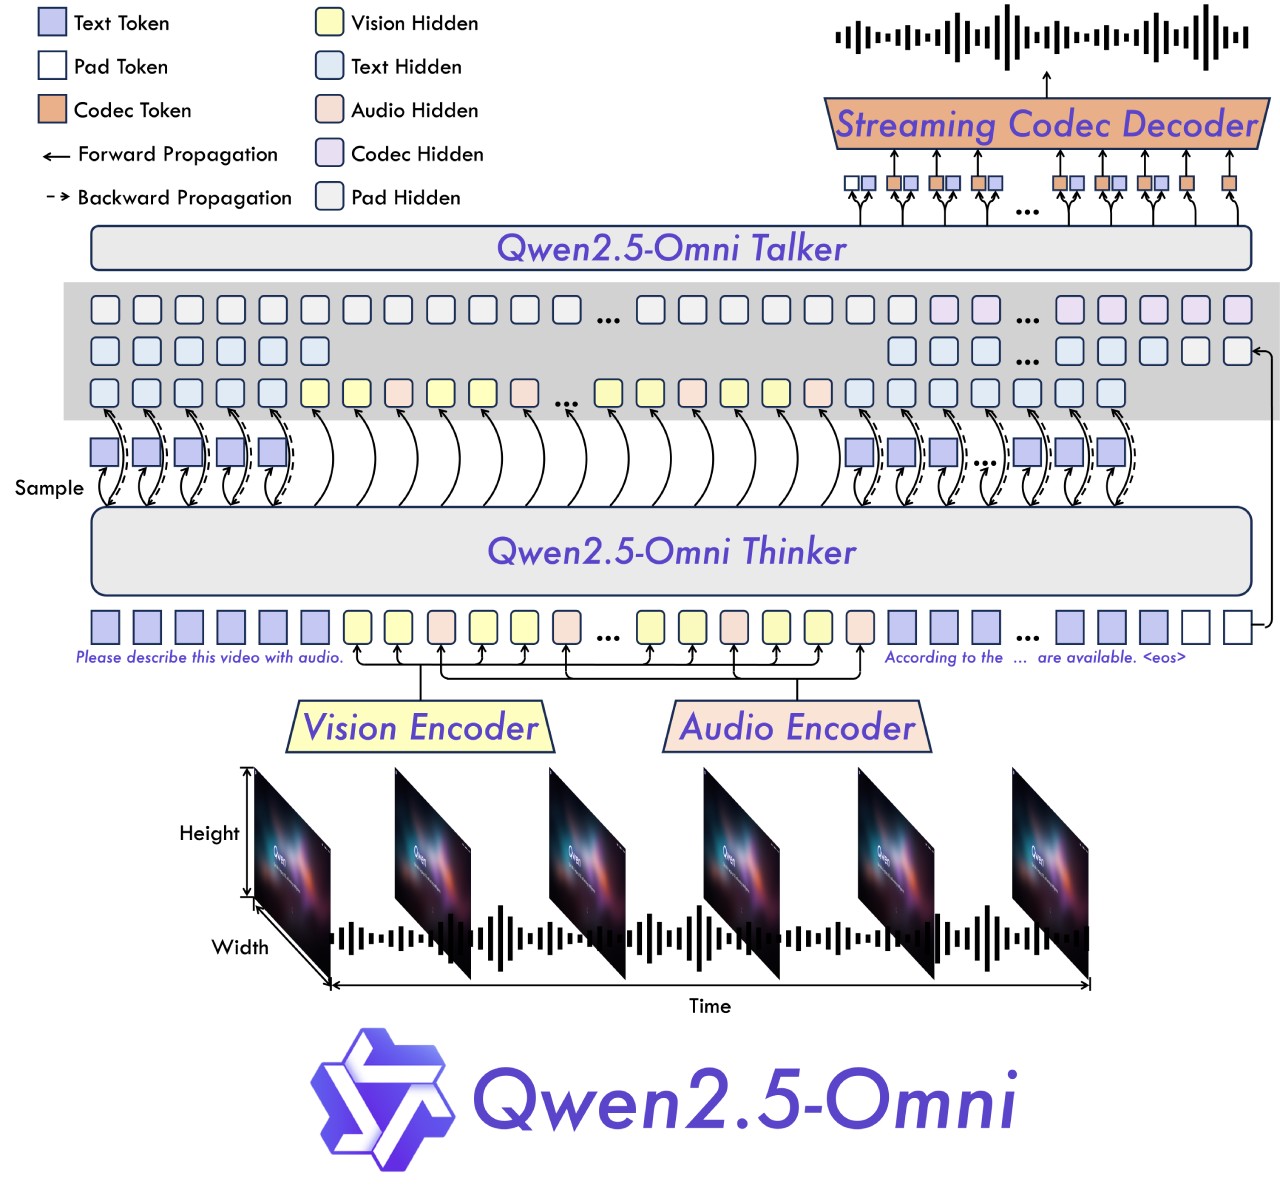
Thinker-Talker-Architektur: Thinker ist für die Verarbeitung und das Verständnis von Eingaben aus den Text-, Audio- und Video-Modalitäten zuständig und erzeugt hochrangige semantische Repräsentationen sowie entsprechende Textinhalte; Talker wandelt diese Inhalte in natürliche Sprachausgaben um.
TMRoPE-Technik: Eine neuartige Positionskodierungstechnik namens TMRoPE (Time-aligned Multimodal RoPE) wird vorgeschlagen, um Videoeingaben mit Audio-Zeitstempeln zu synchronisieren.
Echtzeit-Interaktion:
Unterstützt vollständige Echtzeit-Interaktion und kann Chunk-Eingaben verarbeiten sowie sofortige Ausgaben liefern.
Natürliche und flüssige Sprachgenerierung:
Übertrifft in Bezug auf Natürlichkeit und Stabilität der Sprachgenerierung viele bestehende Streaming- und Nicht-Streaming-Alternativen.
Leistungsvorteile über alle Modalitäten:
Zeigt hervorragende Leistungen bei multimodalen Aufgaben (wie OmniBench) und gleichzeitig auch bei unimodalen Aufgaben (wie Spracherkennung, Übersetzung, Audioverständnis, Bildinferenz, Videoverständnis usw.).
Ende-zu-Ende-Sprachbefehlsfolge-Fähigkeit:
Zeigt bei der Ende-zu-Ende-Sprachbefehlsfolge eine vergleichbare Leistung wie bei der Verarbeitung von Texteingaben und erzielt hervorragende Ergebnisse in Benchmarks wie MMLU und GSM8K.
Architekturdesign von Qwen2.5-Omni
Thinker: Vergleichbar mit einem Gehirn, zuständig für die Verarbeitung und das Verständnis von Eingaben aus den Text-, Audio- und Video-Modalitäten und erzeugt hochrangige semantische Repräsentationen sowie entsprechende Textinhalte.
Talker: Vergleichbar mit dem menschlichen Mund, empfängt die vom Thinker erzeugten hochrangigen semantischen Repräsentationen und Textinhalte und gibt auf Streaming-Weise natürliche Sprache aus.
Gesamtarchitektur: Thinker ist ein Transformer-Decoder, ausgestattet mit Encodern für Audio und Bilder zur Informationsextraktion. Talker ist eine Dual-Track-Autoregressiv-Transformer-Decoder-Architektur. Während des Trainings und der Inferenz empfängt Talker direkt die hochdimensionalen Repräsentationen vom Thinker und teilt den gesamten historischen Kontext des Thinkers. Die gesamte Architektur wird als einheitliches Modell Ende-zu-Ende trainiert und inferiert.
Leistung von Qwen2.5-Omni
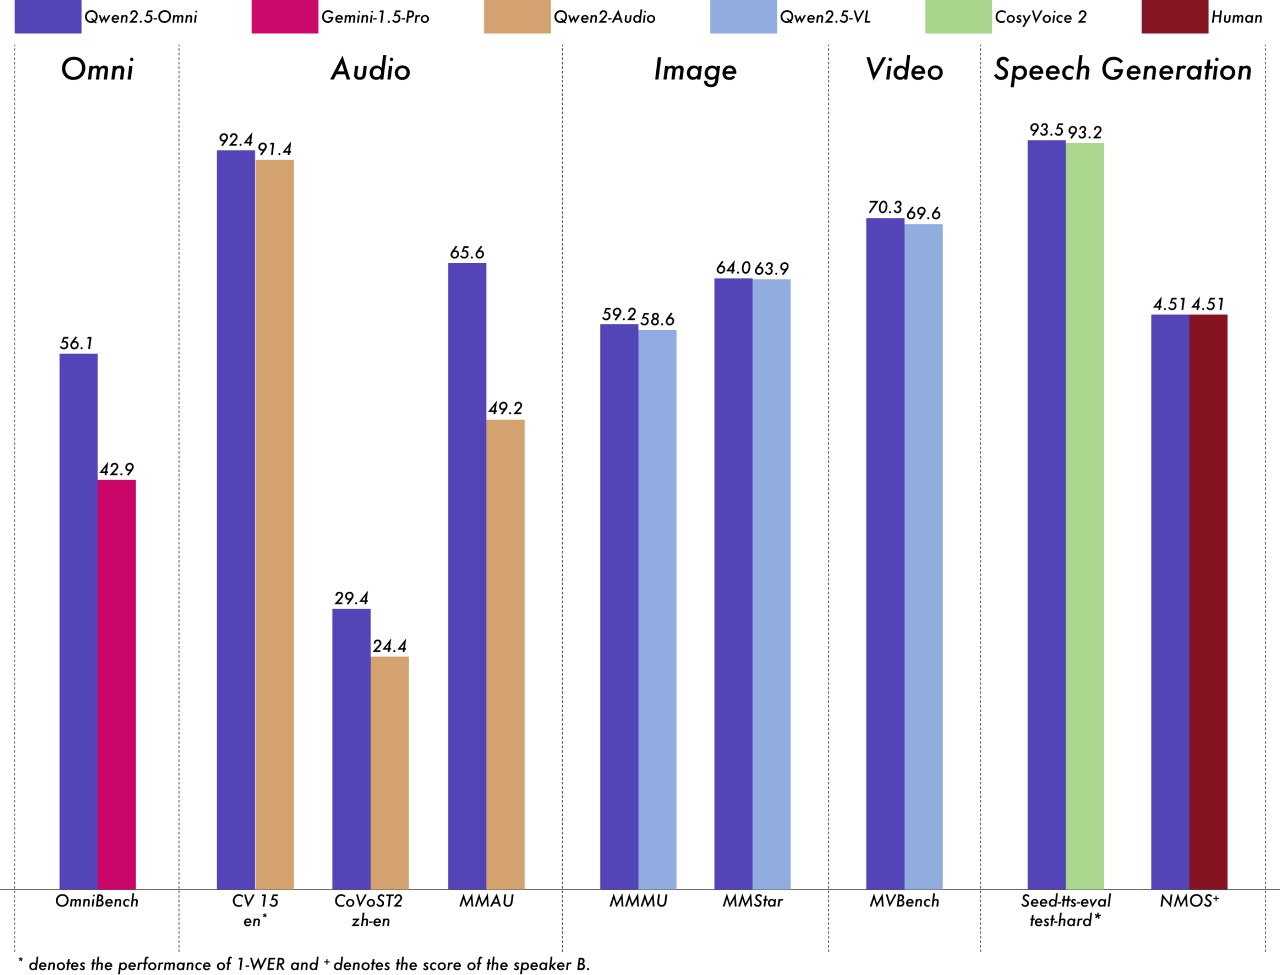
Bei multimodalen Aufgaben (wie OmniBench) erreicht Qwen2.5-Omni eine state-of-the-art Leistung.
Bei unimodalen Aufgaben zeigt es hervorragende Leistungen in den Bereichen Spracherkennung (Common Voice), Übersetzung (CoVoST2), Audioverständnis (MMAU), Bildinferenz (MMMU, MMStar), Videoverständnis (MVBench) und Sprachgenerierung (Seed-tts-eval sowie subjektive Natürlichkeit).
Verwandte Links
Qwen Chat:https://chat.qwenlm.ai
Hugging Face:https://huggingface.co/Qwen/Qwen2.5-Omni-7B
ModelScope:https://modelscope.cn/models/Qwen/Qwen2.5-Omni-7B
DashScope:https://help.aliyun.com/zh/model-studio/user-guide/qwen-omni
GitHub:https://github.com/QwenLM/Qwen2.5-Omni
Demo-Erfahrung:https://modelscope.cn/studios/Qwen/Qwen2.5-Omni-Demo









