
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
KDTalker: Realistische Gesichtsausdrücke und Bewegungsvideos aus Audio erzeugen
小编 ·

KDTalker: Realistische Gesichtsausdrücke und Bewegungsvideos aus Audio erzeugen
Was ist KDTalker?
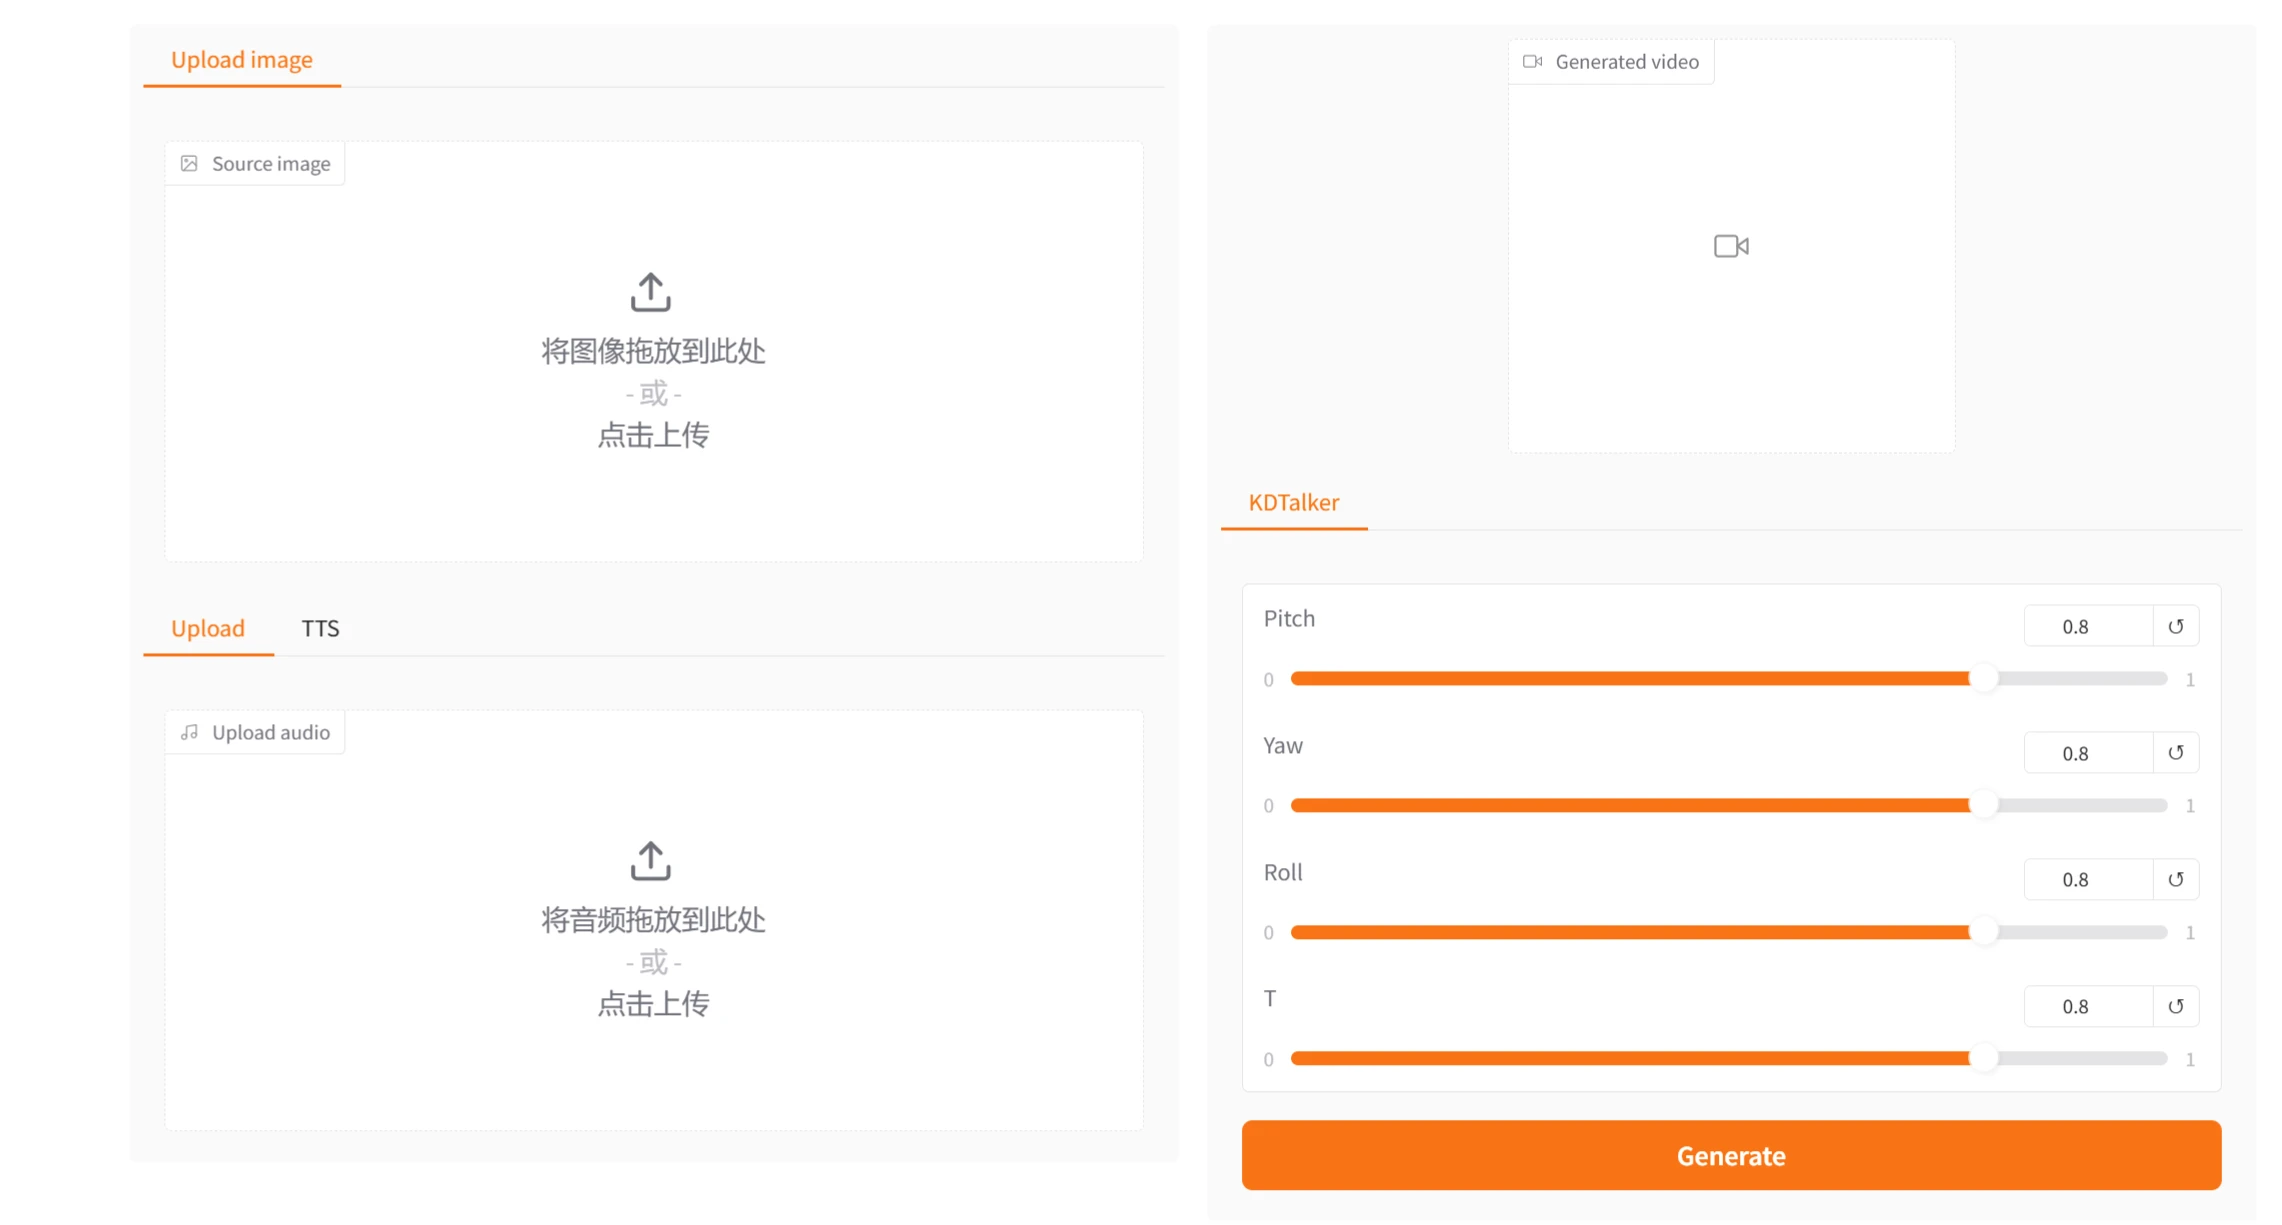
KDTalker ist ein Tool zur audio-gesteuerten Erzeugung dynamischer Porträts, das in der Lage ist, realistische Gesichtsausdrücke und -bewegungen auf Basis eines eingegebenen Audiosignals zu generieren. KDTalker zeichnet sich durch implizite Schlüsselpunkttechnik, ein raumzeitliches Diffusionsmodell und Posenvielfalt aus. Es eignet sich für verschiedene Szenarien wie Virtual Reality, soziale Medien und Videokonferenzen. Durch einfache Umgebungsvorbereitung und Kommandozeilenoperationen können Benutzer schnell hochwertige dynamische Porträtvideos erzeugen.
Funktionsmerkmale von KDTalker
Implizite Schlüsselpunkttechnik:
Durch die Nutzung impliziter Schlüsselpunkte werden feine Veränderungen von Gesichtsausdrücken und -bewegungen erfasst, wodurch die Beziehung zwischen Audio und Gesichtsbewegungen natürlicher abgebildet werden kann.
Im Vergleich zu herkömmlichen Methoden mit expliziten Schlüsselpunkten vermeiden implizite Schlüsselpunkte die Komplexität und Fehleranfälligkeit einer expliziten Annotation.
Raumzeitliches Diffusionsmodell:
In Kombination mit einem raumzeitlichen Diffusionsmodell werden weichere und kohärentere dynamische Effekte erzeugt, während Bildqualität und Stabilität erhalten bleiben.
Das raumzeitliche Diffusionsmodell ermöglicht eine bessere Handhabung der zeitlichen Kontinuität in Videosequenzen.
Posenvielfalt:
Die Erzeugung mehrerer Posen wird unterstützt, wobei die Haltung der Figur dynamisch an den Audioinhalt angepasst werden kann, was die Vielfalt und Natürlichkeit der Ergebnisse erhöht.
Benutzer können verschiedene Posestile festlegen, um individuellere dynamische Porträts zu erzeugen.
Hohe Effizienz:
Das optimierte Modelldesign und der effiziente Rechenablauf ermöglichen es, die Technik auf einer einzelnen RTX4090- oder RTX3090-Grafikkarte auszuführen, was eine hohe Praxistauglichkeit und Skalierbarkeit bietet.
Geeignet für den Einsatz auf Geräten mit begrenzten Ressourcen, wobei gleichzeitig eine hohe Generierungsgeschwindigkeit erhalten bleibt.
Hochwertige Erzeugung:
Die erzeugten dynamischen Porträts haben eine hohe Auflösung und Realitätsnähe und erfüllen die Anforderungen an hochwertige Videoerzeugung.
Durch vortrainierte Modelle und optimierte Inferenzabläufe werden Stabilität und Konsistenz der Ergebnisse sichergestellt.
Anwendungsszenarien von KDTalker
Virtual Reality (VR) und Augmented Reality (AR):
In VR- und AR-Anwendungen kann KDTalker realistische dynamische Porträts virtueller Charaktere erzeugen und so das Benutzererlebnis verbessern.
Beispielsweise können Benutzer in virtuellen Besprechungen über Audio-Steuerung ihr eigenes dynamisches Porträt erzeugen, wodurch die Fernkommunikation natürlicher wird.
Soziale Medien und Video-Content-Erstellung:
Benutzer können eigene Fotos und Audio in KDTalker einspeisen, um personalisierte dynamische Porträtvideos für das Teilen in sozialen Medien zu erzeugen.
Content-Ersteller können mit dieser Technik interessante Videoinhalte erzeugen und so die Attraktivität ihrer Videos steigern.
Videokonferenzen:
Bei Videokonferenzen kann eine instabile Netzwerkverbindung zu Rucklern oder Unschärfe im Video führen. KDTalker kann über Audio-Steuerung flüssige dynamische Porträts erzeugen und so auch in Umgebungen mit geringer Bandbreite eine gute visuelle Qualität gewährleisten.
Unterhaltung und Spiele:
In Spielen und Unterhaltungsanwendungen kann KDTalker dynamische Gesichtsausdrücke und Bewegungen virtueller Charaktere erzeugen und so die Immersion des Spiels verstärken.
In Rollenspielen können Spieler beispielsweise ihre Charakter-Porträts per Audio-Steuerung dynamisch erzeugen.
Bildung und Schulung:
In Bildungs- und Schulungsszenarien kann KDTalker dynamische Porträts von Lehrkräften oder Trainern erzeugen, die in Online-Kursen oder Schulungsvideos zum Einsatz kommen.
Audio-gesteuert erzeugte dynamische Porträts können die Lehrinhalte lebendiger gestalten und so den Lerneffekt verbessern.
Verwendung von KDTalker
1. Umgebungsvorbereitung
Hardwareanforderungen: Empfohlen werden Grafikkarten vom Typ RTX4090 oder RTX3090.
Softwareabhängigkeiten:
Installation von git, conda und FFmpeg.
Code klonen und Python-Umgebung erstellen:
git clone https://github.com/chaolongy/KDTalker
cd KDTalker
# 创建并激活conda环境
conda create -n KDTalker python=3.9
conda activate KDTalker
# 安装PyTorch和其他依赖
conda install pytorch==2.3.0 torchvision==0.18.0 torchaudio==2.3.0 pytorch-cuda=11.8 -c pytorch -c nvidia
pip install -r requirements.txt
2. Vortrainierte Gewichte herunterladen
Laden Sie die vortrainierten Gewichtsdateien von Google Drive oder Hugging Face herunter und legen Sie sie in den Verzeichnissen ./pretrained_weights und ./ckpts ab.
Stellen Sie sicher, dass die Verzeichnisstruktur wie folgt aussieht:
pretrained_weights
├── insightface
│   └── models
│       └── buffalo_l
│           ├── 2d106det.onnx
│           └── det_10g.onnx
└── liveportrait
    ├── base_models
    │   ├── appearance_feature_extractor.pth
    │   ├── motion_extractor.pth
    │   ├── spade_generator.pth
    │   └── warping_module.pth
    ├── landmark.onnx
    └── retargeting_models
        └── stitching_retargeting_module.pth
3. Inferenz ausführen
Führen Sie das Inferenz-Skript mit dem folgenden Befehl aus, um ein dynamisches Porträtvideo zu erzeugen:
python inference.py -source_image ./example/source_image/WDA_BenCardin1_000.png -driven_audio ./example/driven_audio/WDA_BenCardin1_000.wav -output ./results/output.mp4
-source_image: Gibt den Pfad zum eingegebenen Quellbild an.
-driven_audio: Gibt den Pfad zur eingegebenen Audiodatei an.
-output: Gibt den Speicherpfad für das Ausgabevideo an.
Projekt-Adresse: https://github.com/chaolongy/KDTalker
DEMO: https://kdtalker.com/









