
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Funktionen, Preise und Anwendungsfälle der OpenAI-Sprachmodelle GPT-4o-transcribe, GPT-4o-mini-transcribe und GPT-4o-mini-tts
小编 ·

Funktionen, Preise und Anwendungsfälle der OpenAI-Sprachmodelle GPT-4o-transcribe, GPT-4o-mini-transcribe und GPT-4o-mini-tts
Openai hat eine neue Generation von Sprachmodellen vorgestellt, die Entwicklern leistungsstärkere Fähigkeiten zur Sprachinteraktion bieten und die Entwicklung von Sprachagenten unterstützen. Diese Modelle umfassen zwei Sprach-zu-Text-Modelle (gpt-4o-transcribe und gpt-4o-mini-transcribe) sowie ein Text-zu-Sprache-Modell (gpt-4o-mini-tts). Welche Eigenschaften haben sie jeweils?
1. GPT-4o-transcribe (Sprach-zu-Text-Modell)
Eigenschaften:
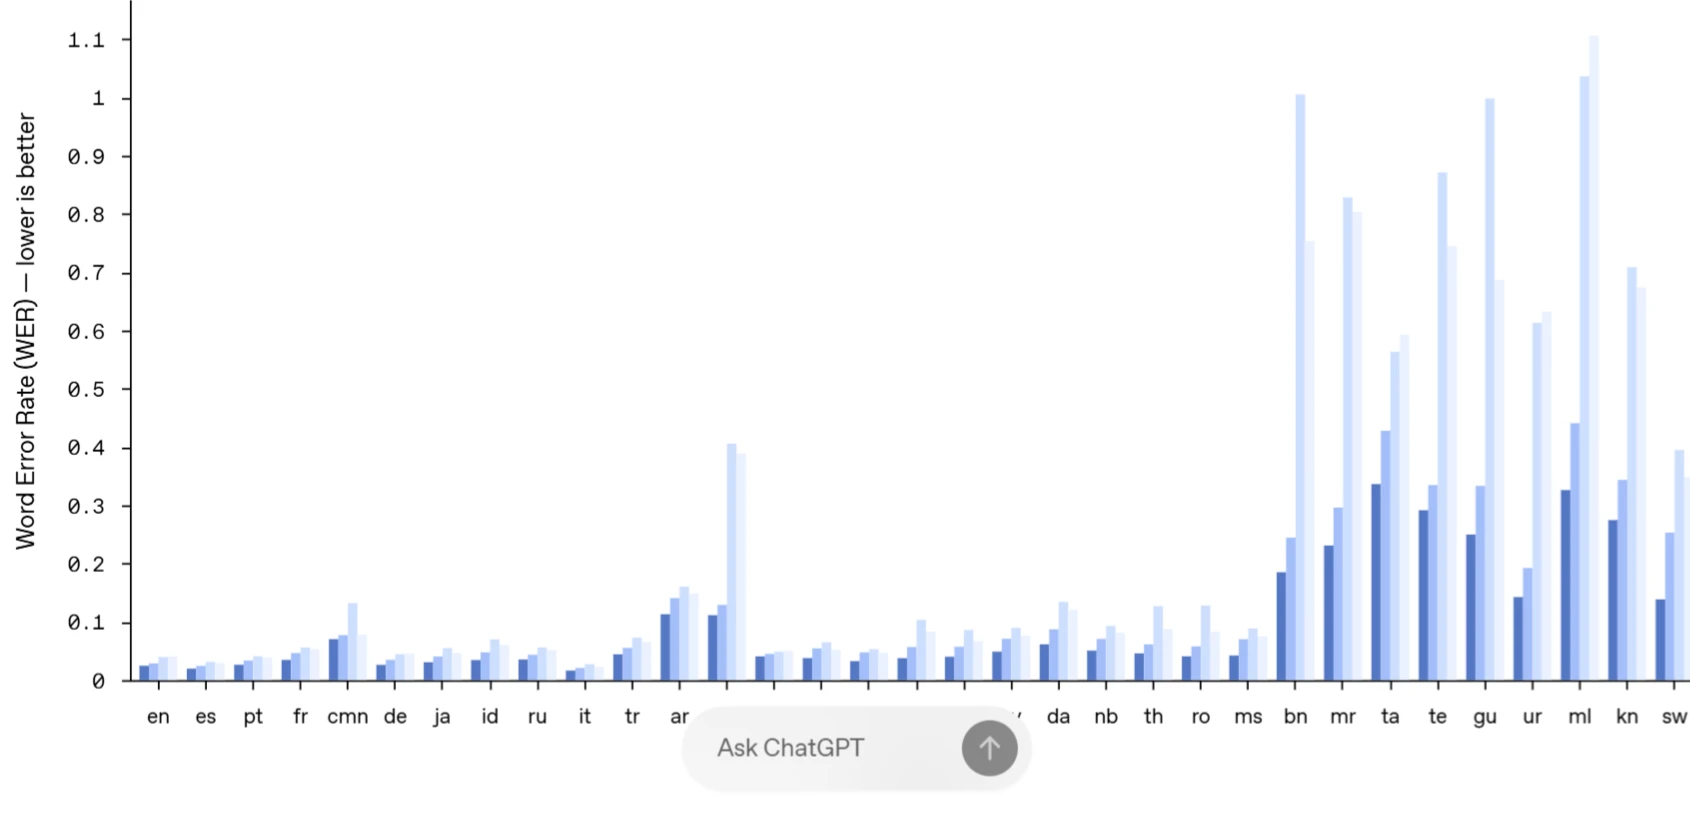
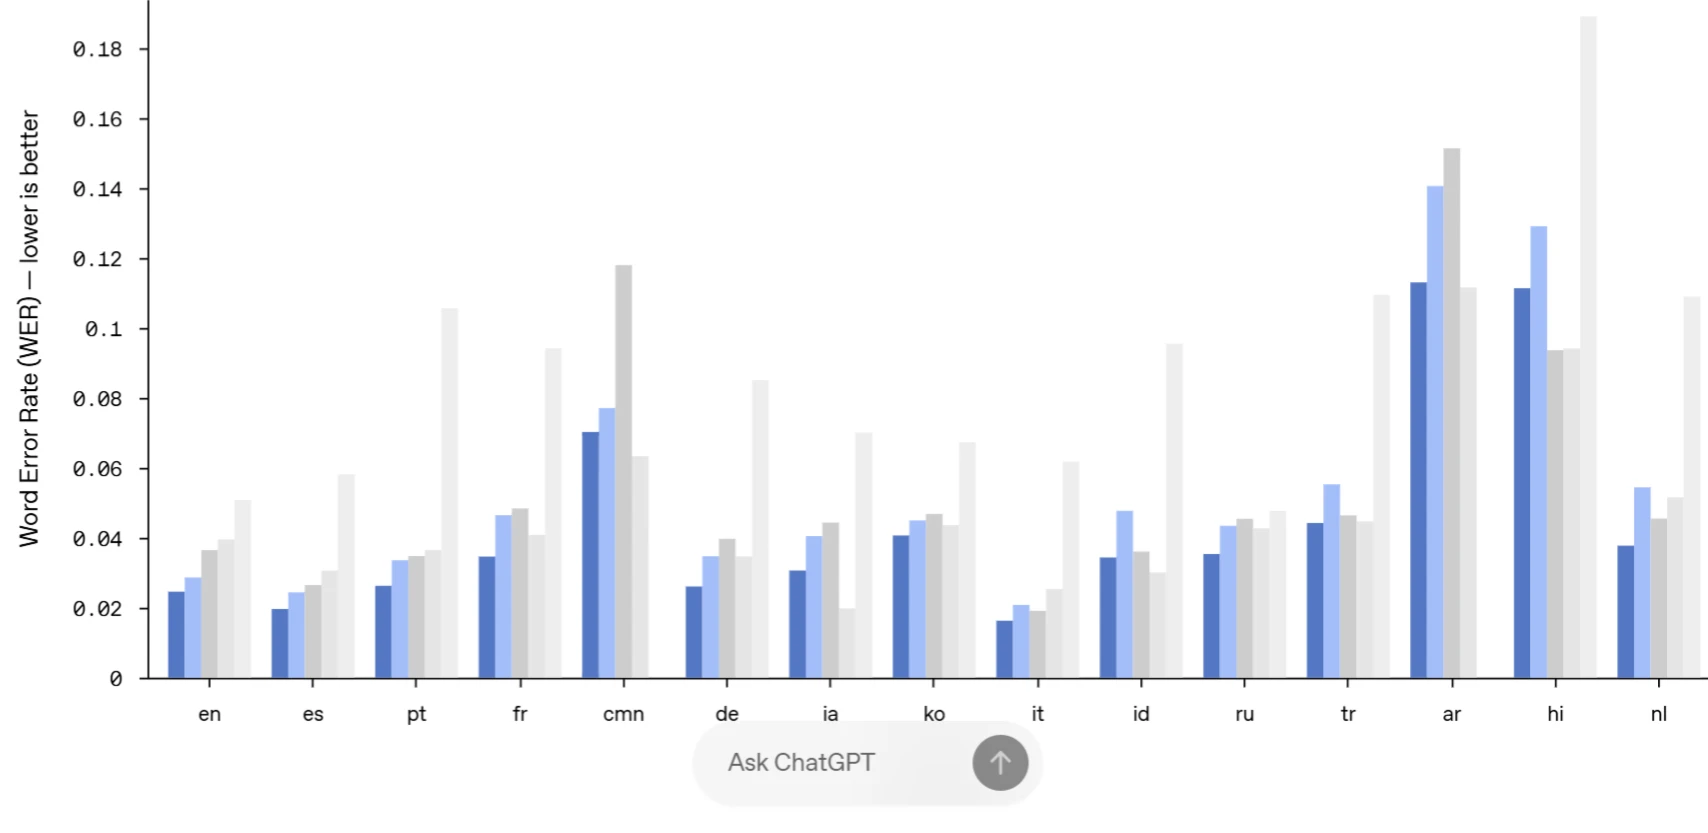
Hochpräzise Transkription: Nach umfangreichem Training mit vielfältigen, hochwertigen Audiodatensätzen kann es Feinheiten der Sprache besser erfassen, Fehlerkennungen reduzieren und die Zuverlässigkeit der Transkription deutlich verbessern.
Anpassung an komplexe Szenarien: Es passt sich stark an Akzente, Sprechgeschwindigkeit und Umgebungsgeräusche an und kann Sprache auch dann genau erkennen und transkribieren, wenn die Umgebung laut ist, der Sprecher einen starken Akzent hat oder schnell spricht.
Verarbeitung langer Spracheingaben: Es kann längere Spracheingaben verarbeiten und eignet sich für Szenarien, die eine langfristige, kontinuierliche Sprachtranskription erfordern.
Einsatzszenarien:
Besprechungsprotokolle: Sprachinhalte aus Besprechungen werden in Echtzeit oder im Nachhinein in Text transkribiert, was die Nachbereitung und das Wiederaufgreifen erleichtert und die Arbeitseffizienz steigert.
Interviewprotokolle: In Szenarien wie Nachrichteninterviews oder Personeninterviews werden die Sprachinhalte des Interviewten schnell und präzise in Text transkribiert, was die anschließende Bearbeitung und Veröffentlichung erleichtert.
Sprachnotizen: Die Sprachnotizen der Nutzer werden in Text transkribiert, sodass sie jederzeit eingesehen und geordnet werden können.
Kunden-Callcenter: Die Sprache der Kunden wird genau erkannt und in Text transkribiert, sodass das Kundendienstpersonal die Kundenbedürfnisse schnell verstehen und entsprechend bearbeiten kann.
Preisgestaltung:
Der Preis pro 1 Million Audio-Eingabe-Tokens beträgt $6,00, was ungefähr $0,006 pro Minute entspricht.
2. GPT-4o-mini-transcribe (abgespeckte Version des Sprach-zu-Text-Modells)
Eigenschaften:
Hohe Effizienz und Schnelligkeit: Das Modell ist kleiner und die Verarbeitungsgeschwindigkeit höher, sodass Sprachtranskriptionsaufgaben in kurzer Zeit abgeschlossen werden können.
Geringer Ressourcenverbrauch: Die Anforderungen an die Hardware-Ressourcen sind relativ niedrig, wodurch es für den Betrieb auf Geräten mit begrenzten Ressourcen geeignet ist.
Hervorragendes Preis-Leistungs-Verhältnis: Obwohl die Wortfehlerrate (WER) etwas höher als beim vollständigen Modell ist, ist sie dennoch besser als beim ursprünglichen Whisper-Modell.
Einsatzszenarien:
Spracheingabe auf mobilen Geräten: Auf Smartphones, Tablets und anderen mobilen Geräten bietet es den Nutzern eine schnelle Spracheingabe-Transkriptionsfunktion, z. B. das Diktieren von Textnachrichten.
Kleine Sprachanwendungen: Es eignet sich für kleinere Sprachanwendungen, bei denen die Transkriptionsgenauigkeit nicht allzu hoch sein muss, aber eine schnelle Reaktion erforderlich ist, wie z. B. Sprachbefehlserkennung oder einfache Sprachnotizen.
Ressourcenbeschränkte Umgebungen: In Szenarien mit begrenzten Rechenressourcen, etwa in Projekten kleiner Unternehmen oder einzelner Entwickler, bietet es eine effiziente und kostengünstige Lösung für die Sprachtranskription.
Preisgestaltung:
Der Preis pro 1 Million Audio-Eingabe-Tokens beträgt $3,00, was ungefähr $0,003 pro Minute entspricht.
3. GPT-4o-mini-tts (Text-zu-Sprache-Modell)
Eigenschaften:
Steuerbarkeit: Erstmals wird „Steuerbarkeit“ unterstützt. Entwickler können nicht nur festlegen, was das Modell „sagt“, sondern auch, „wie“ es spricht. So lässt sich beispielsweise der Sprachstil im Voraus auf „ruhig“, „Surfer“, „professionell“ oder „mittelalterlicher Ritter“ festlegen, und der Sprachstil kann per Anweisung angepasst werden, etwa „sprich wie ein einfühlsamer Kundenservice-Agent“.
Natürlich fließende Sprache: Die erzeugte Sprache klingt natürlich fließend und ausdrucksstark und kann entsprechend dem Textinhalt und dem voreingestellten Stil die passende Sprachausgabe liefern.
Mehrsprachige Unterstützung: Es unterstützt die Text-zu-Sprache-Umwandlung in mehreren Sprachen und erfüllt damit die Anforderungen von Nutzern unterschiedlicher Sprachen.
Einsatzszenarien:
Hörbücher: Bücher, Artikel und andere Textinhalte werden in Audioinhalte umgewandelt, um den Nutzern ein anschaulicheres und unterhaltsameres Leseerlebnis zu bieten.
Intelligenter Kundenservice: Es stellt Sprachsynthesefunktionen für intelligente Kundenservicesysteme bereit, sodass die Service-Roboter mit einer natürlichen, ausdrucksstarken Stimme mit den Nutzern kommunizieren können, was das Nutzererlebnis verbessert.
Sprachdurchsagen: In Szenarien wie Nachrichtensendungen, Wettervorhersagen oder Verkehrsmeldungen werden Textinhalte in Sprache umgewandelt und vorgelesen.
Kreative Content-Produktion: In Bereichen wie kreatives Storytelling, Werbe-produktion, Videosynchronisation usw. wird je nach kreativer Anforderung eine Stimme mit bestimmtem Stil und Emotion erzeugt.
Preisgestaltung:
Der Preis pro 1 Million Text-Eingabe-Tokens beträgt $0,60 und pro 1 Million Audio-Ausgabe-Tokens $12,00, was ungefähr $0,015 pro Minute entspricht.
Modelle wie GPT-4o-transcribe stehen Entwicklern über die API-Schnittstelle von OpenAI zur Verfügung und lassen sich mit nur wenig Code bequem in Anwendungen integrieren. Entwickler können je nach Funktions- und Umgebungsanforderungen das passende Modell auswählen und es auch auf der offiziellen Website testen.
Offizielle Website:http://open ai.fm/
Blog:https://openai.com/index/introducing-our-next-generation-audio-models/









