
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
OpenAI veröffentlicht drei neue Sprachmodelle: zwei Speech-to-Text und ein Text-to-Speech
小编 ·

OpenAI veröffentlicht drei neue Sprachmodelle: zwei Speech-to-Text und ein Text-to-Speech
Am 20. März 2025 hat OpenAI drei völlig neue Sprachmodelle veröffentlicht, darunter zwei Modelle zur Spracherkennung (GPT-4o-transcribe und GPT-4o-mini-transcribe) sowie ein Modell zur Sprachsynthese (GPT-4o-mini-tts).
Spracherkennungsmodelle
GPT-4o-transcribe: Dieses Modell wurde über einen langen Zeitraum mit vielfältigen, qualitativ hochwertigen Audiodatensätzen trainiert. Es erfasst feine Nuancen der Sprache besser, reduziert Fehlerkennungen und verbessert die Zuverlässigkeit der Transkription erheblich. Es eignet sich für den Umgang mit komplexen Szenarien wie unterschiedlichen Akzenten, lauten Umgebungen und variierenden Sprechgeschwindigkeiten, beispielsweise in Callcentern oder bei der Transkription von Besprechungsaufzeichnungen.
GPT-4o-mini-transcribe: Dies ist eine abgespeckte Version von GPT-4o-transcribe, die schneller und effizienter ist. Obwohl die Wortfehlerrate (WER) etwas höher ist als bei der Vollversion, übertrifft sie dennoch das bisherige Whisper-Modell und eignet sich besser für Anwendungsszenarien mit begrenzten Ressourcen, die dennoch eine hochwertige Spracherkennung benötigen.
Sprachsynthesemodell
GPT-4o-mini-tts: Dieses Modell unterstützt erstmals „Steuerbarkeit" (steerability). Entwickler können nicht nur festlegen, was das Modell sagt, sondern auch steuern, wie es etwas sagt. Beispielsweise können voreingestellte Sprachstile wie „ruhig", „Surfer", „professionell" oder „mittelalterlicher Ritter" ausgewählt werden. Zudem lässt sich der Sprachstil durch Anweisungen anpassen, etwa „Sprich wie ein einfühlsamer Kundenservice-Agent".
Technologische Innovationen
Vortraining mit realen Audiodatensätzen zur Optimierung der Modellleistung.
Verbesserte Destillationsmethoden zur Übertragung von Wissen vom großen Modell auf kleinere Modelle.
Verstärkungslernen zur Steigerung der Transkriptionsgenauigkeit und Reduzierung von „Halluzinationen".
Anwendungsszenarien
Callcenter: Bereitstellung einer genaueren Spracherkennung und natürlicheren Sprachsynthese zur Verbesserung des Kundenservice-Erlebnisses.
Besprechungsaufzeichnungen: Schnelle und genaue Transkription von Besprechungsinhalten in Text.
Personalisierter Kundenservice: Individuell anpassbare Sprachstile ermöglichen ein wärmeres und ausdrucksstärkeres Spracherlebnis.
Kreatives Geschichtenerzählen: Hinzufügen lebendiger Soundeffekte zu Geschichten.
Preise
Der Preis für GPT-4o-transcribe entspricht dem des vorherigen Whisper-Modells und liegt bei 0,006 US-Dollar pro Minute.
GPT-4o-mini-transcribe kostet 0,003 US-Dollar pro Minute.
GPT-4o-mini-tts wird mit 1 Cent pro Minute berechnet.
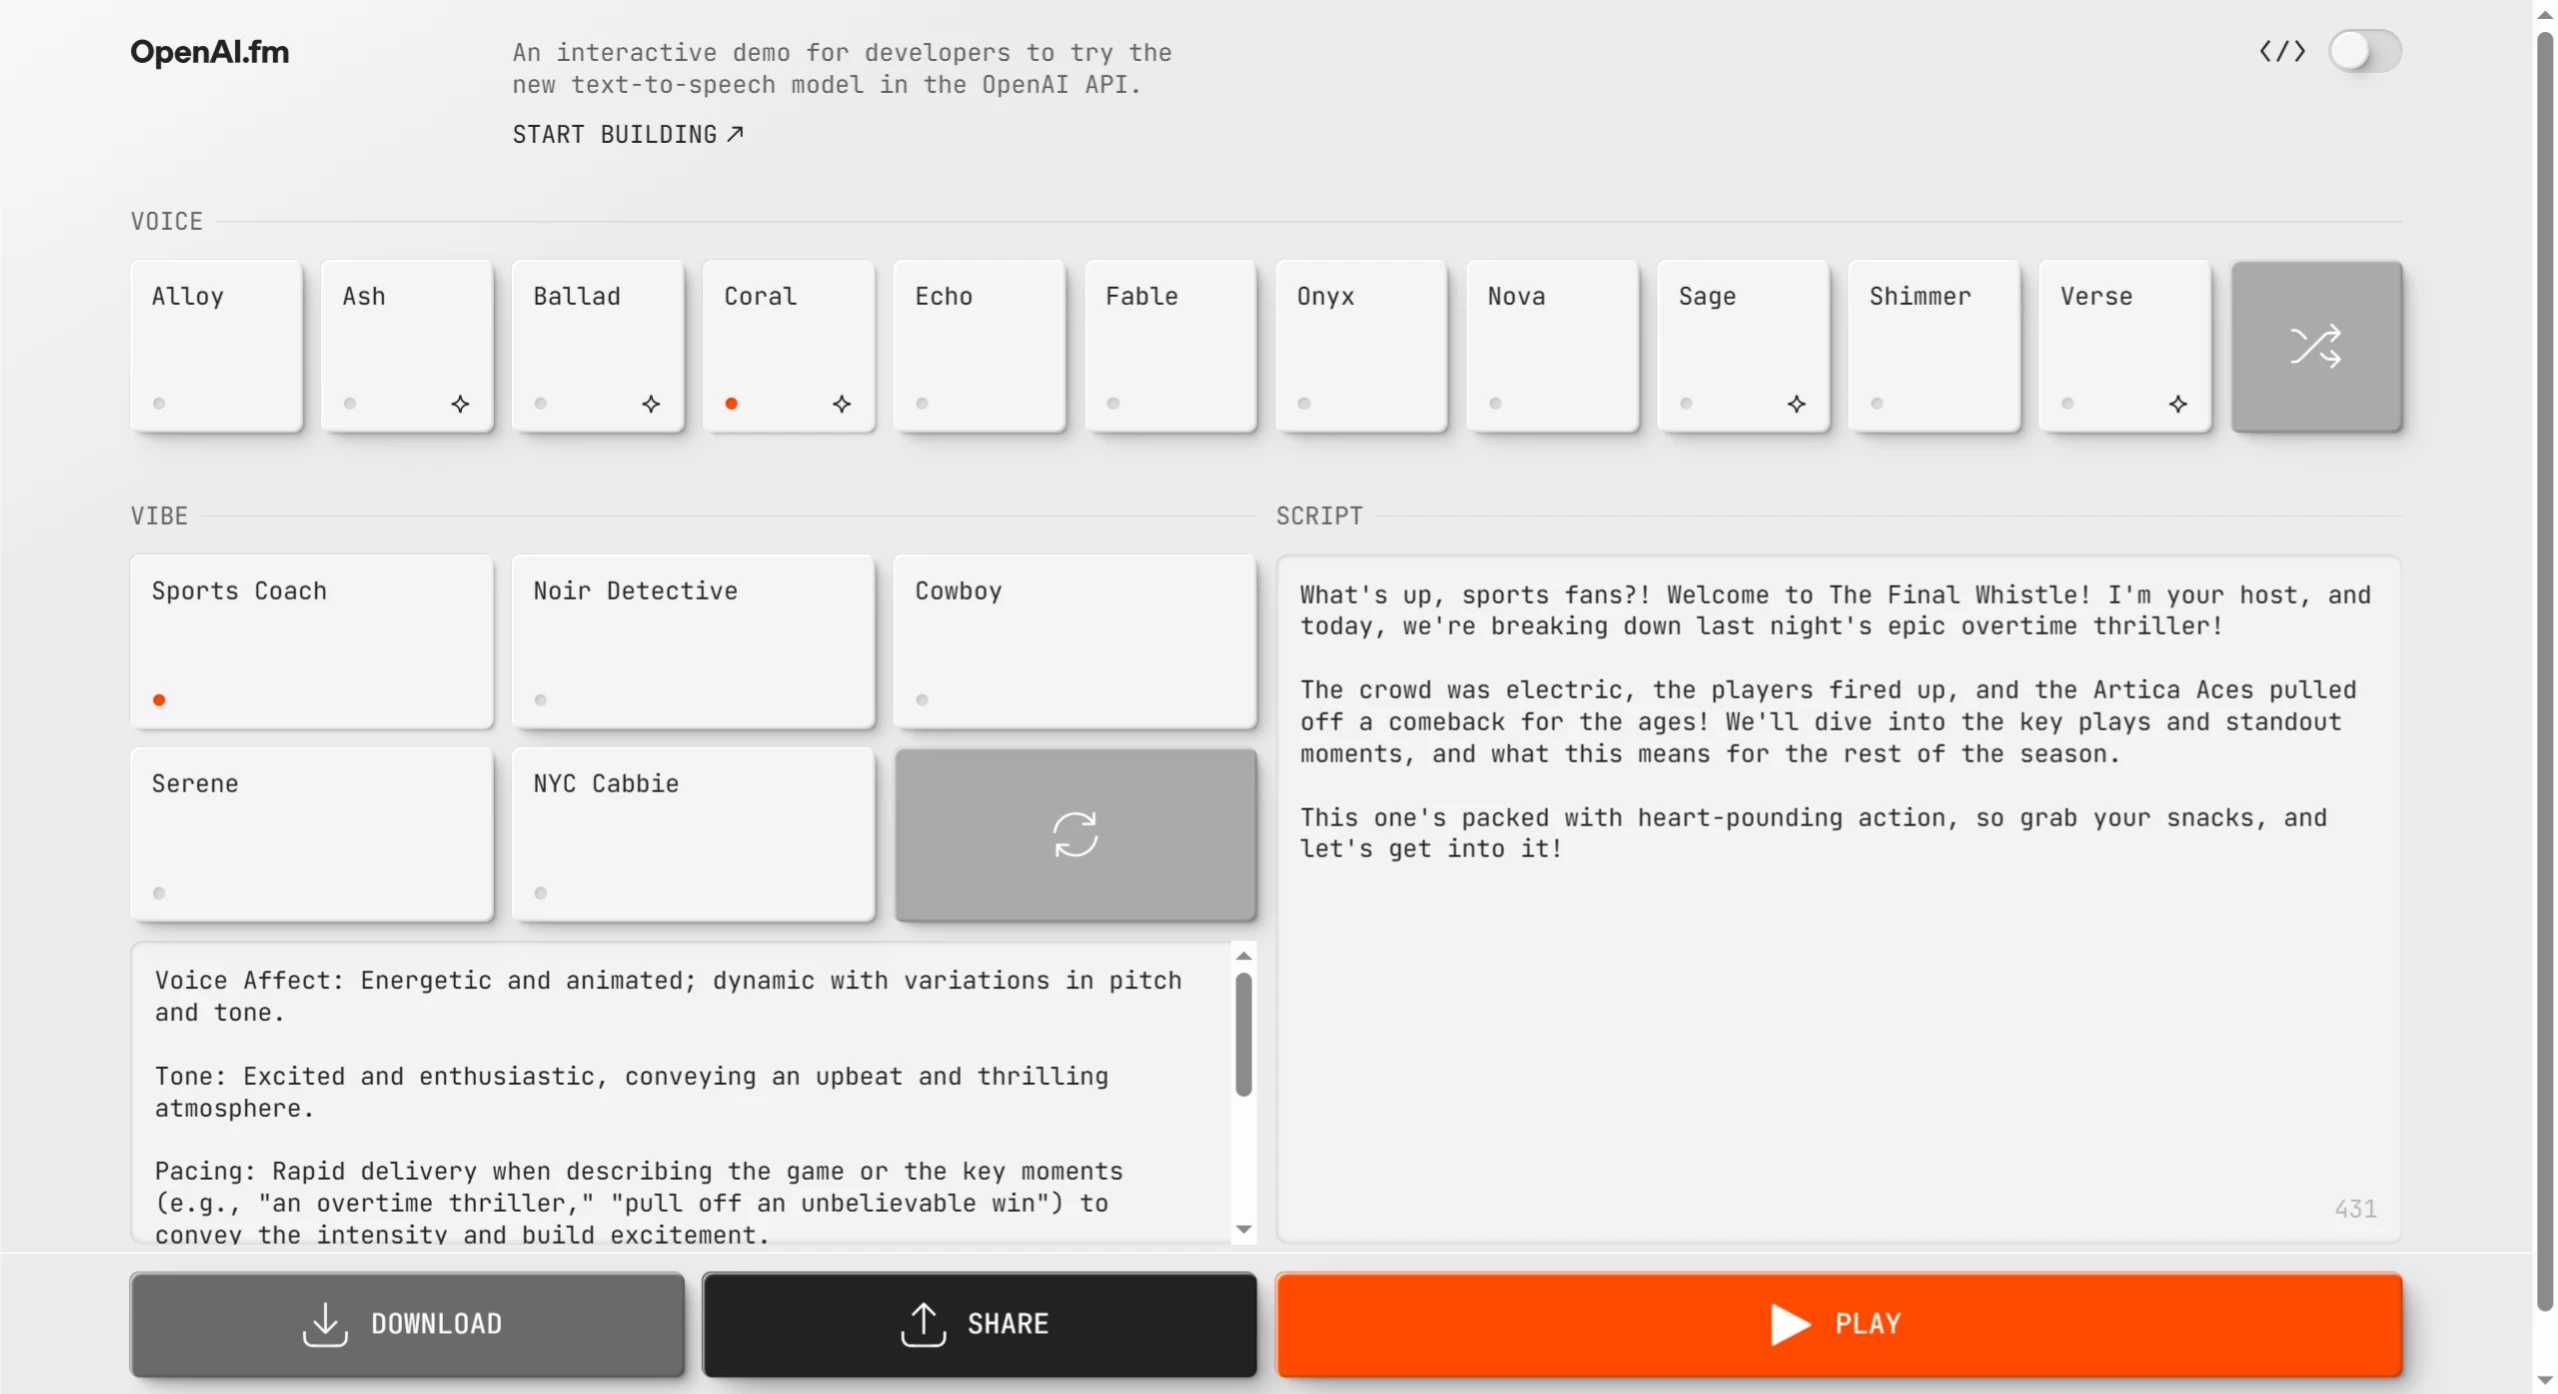
Die Website der OpenAI-Sprachmodelle: OpenAI.fm. Die Seite bietet eine Vielzahl voreingestellter Vorlagen, einschließlich Einstellungen für Persona, Tonfall, Dialekt und Aussprache. Nutzer können hier entsprechende Audiodateien mit GPT-4o-mini-tts erleben und erstellen. Darüber hinaus stellt OpenAI ein aktualisiertes Agent SDK bereit, das Entwicklern den komfortableren Aufbau von Sprachagenten ermöglicht.
Offizielle Website: http://openai.fm/
Offizieller Blog: https://openai.com/index/introducing-our-next-generation-audio-models/









