
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Chitu: ein hochleistungsfähiges Open-Source-LLM-Inferenz-Framework des Tsinghua-Teams
小编 ·

Chitu: ein hochleistungsfähiges Open-Source-LLM-Inferenz-Framework des Tsinghua-Teams
Was ist Chitu(赤兔)?
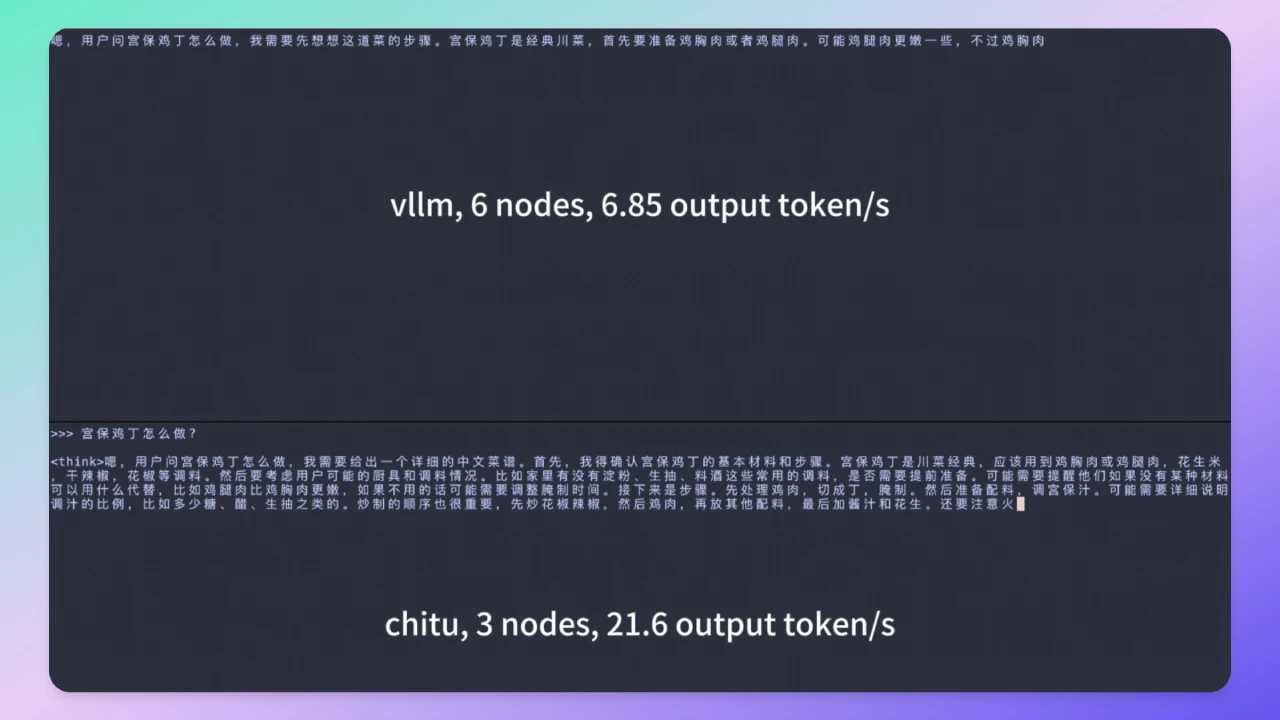
Chitu(赤兔)ist ein von einem Team der Tsinghua-Universität Open-Source veröffentlichtes Hochleistungs-Inferenz-Framework für große Sprachmodelle. Es konzentriert sich darauf, die Inferenz-Effizienz zu verbessern, die Kosten zu senken und unterstützt verschiedene Hardware-Plattformen sowie Deploy-Szenarien. Es kann die Inferenz-Kosten für DeepSeek halbieren und die Leistung verdoppeln. Das Ziel von Chitu(赤兔)ist es, Unternehmen und Entwicklern eine effiziente, flexible und leicht zu deployende Inferenz-Engine bereitzustellen und so den praktischen Einsatz von großen Sprachmodellen (LLM) zu beschleunigen.
Funktionsmerkmale von Chitu(赤兔)
Vielseitige Rechenleistungsanpassung: Unterstützt eine breite Palette von NVIDIA-Produkten, von den neuesten Flaggschiffen bis hin zu älteren Modellen, und bietet optimierte Unterstützung für inländische Chips.
Skalierbarkeit für alle Szenarien: Bietet flexible, skalierbare Lösungen, von reiner CPU-Bereitstellung über Single-GPU-Deploy bis hin zu groß angelegten Cluster-Bereitstellungen.
Langfristig stabiler Betrieb: Geeignet für reale Produktionsumgebungen und stabil bei der Bewältigung von gleichzeitigem Geschäfts-Traffic.
Hohe Inferenz-Leistung: In A800-Cluster-Tests wird die Inferenz-Geschwindigkeit im Vergleich zu einigen ausländischen Open-Source-Frameworks um das 3,15-fache gesteigert, während die GPU-Nutzung um 50 % reduziert wird.
Kostensenkung: Durch die optimierte Nutzung der Hardware-Ressourcen werden die Einstiegshürden und Kosten für Unternehmen beim Deploy von KI-Modellen gesenkt.
Anwendungsszenarien für Chitu(赤兔)
Enterprise-KI-Anwendungen: Erfordern Inferenz-Services mit hoher Leistung, geringer Latenz und hohem Durchsatz.
Groß angelegte Cluster-Bereitstellungen: Szenarien, die einen effizienten Betrieb in Multi-GPU- oder Multi-Knoten-Umgebungen erfordern.
Ressourcenbeschränkte Umgebungen: Szenarien, in denen eine effiziente Inferenz mit begrenzten Hardware-Ressourcen erreicht werden muss.
Anpassung an inländische Chips: Szenarien, in denen große Sprachmodelle auf inländischen Hardware-Plattformen betrieben werden müssen.
Verwendung von Chitu(赤兔)
1. Installation aus dem Quellcode
git clone --recursive https://github.com/thu-pacman/chitu && cd chitu
pip install -r requirements-build.txt
pip install -U torch --index-url https://download.pytorch.org/whl/cu124  # 根据 CUDA 版本调整
TORCH_CUDA_ARCH_LIST=8.6 CHITU_SETUP_JOBS=4 MAX_JOBS=4 pip install --no-build-isolation
2. Single-GPU-Inferenz
torchrun --nproc_per_node 8 test/single_req_test.py request.max_new_tokens=64 models=DeepSeek-R1 models.ckpt_dir=/data/DeepSeek-R1 infer.pp_size=1 infer.tp_size=8
3. Hybride Parallelität (TP+PP)
torchrun --nnodes 2 --nproc_per_node 8 test/single_req_test.py request.max_new_tokens=64 infer.pp_size=2 infer.tp_size=8 models=DeepSeek-R1 models.ckpt_dir=/data/DeepSeek-R1
4. Service starten
export WORLD_SIZE=8
torchrun --nnodes 1 \
--nproc_per_node 8 \
--master_port=22525 \
example/serve.py \
serve.port=21002 \
infer.stop_with_eos=False \
infer.cache_type=paged \
infer.pp_size=1 \
infer.tp_size=8 \
models=DeepSeek-R1 \
models.ckpt_dir=/data/DeepSeek-R1 \
keep_dtype_in_checkpoint=True \
infer.mla_absorb=absorb-without-precomp \
infer.soft_fp8=True \
infer.do_load=True \
infer.max_reqs=1 \
scheduler.prefill_first.num_tasks=100 \
infer.max_seq_len=4096 \
request.max_new_tokens=100 \
infer.use_cuda_graph=True
5. Leistungstest
python benchmarks/benchmark_serving.py \
--model "deepseek-r1" \
--iterations 10 \
--seq-len 10 \
--warmup 3 \
--base-url http://localhost:21002
GitHub-Repository:https://github.com/thu-pacman/chitu









