
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
OpenManus-RL: Open-Source-Projekt zur Steigerung von Schlussfolgerung und Entscheidungsfindung bei LLM-Agenten
小编 ·

OpenManus-RL: Open-Source-Projekt zur Steigerung von Schlussfolgerung und Entscheidungsfindung bei LLM-Agenten
Was ist OpenManus-RL?
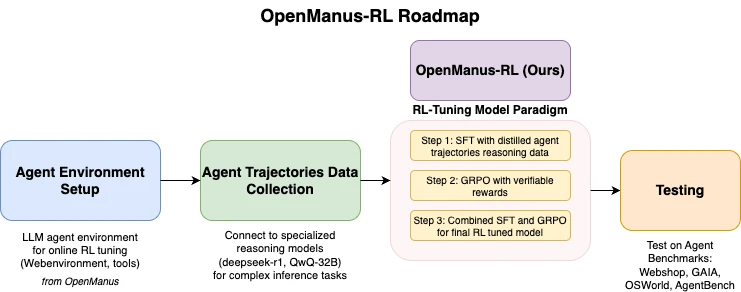
OpenManus-RL ist ein Open-Source-Projekt, das gemeinsam vom UIUC-Ulab und dem MetaGPT-Community-Team von OpenManus entwickelt wurde. Es kann die Denk- und Entscheidungsfähigkeiten von Large Language Model (LLM)-Agenten durch Reinforcement Learning (RL)-Techniken verbessern. Das Projekt basiert auf den Erfahrungen fortschrittlicher Modelle wie Deepseek-R1 und QwQ-32B und erforscht neue Feintuning-Methoden, um die Leistung der Agenten bei komplexen Aufgaben zu steigern. Zu den Kernfunktionen von OpenManus-RL gehören der Aufbau von Agentenumgebungen, das Sammeln von Trajektoriendaten, die Unterstützung von Reinforcement-Learning-Feintuning sowie die Integration von Benchmark-Tests. Es integriert zudem verschiedene Reinforcement-Learning-Strategien wie Tree-of-Thoughts und Monte Carlo Tree Search, um die Denkfähigkeit der Agenten zu verbessern.
Funktionsmerkmale von OpenManus-RL
Aufbau von Agentenumgebungen: Bietet Werkzeuge zur Konfiguration von Agentenumgebungen für Online-Reinforcement-Learning (RL)-Feintuning, sodass Benutzer die Agentenumgebung für bestimmte Aufgaben anpassen können.
Trajektoriendatensammlung: Ermöglicht die Anbindung an Modelle wie Deepseek-R1 und QwQ-32B, um Verhaltensdaten für komplexe Aufgaben zu sammeln und damit eine Datengrundlage für das anschließende Feintuning bereitzustellen.
Unterstützung für RL-Feintuning: Unterstützt Reinforcement-Learning-Methoden zur individuellen Anpassung des Agentenverhaltens, wobei Benutzer die Agenten durch Angabe von Belohnungsfunktionen und Ähnlichem optimieren können.
Benchmark-Test-Integration: Integrierte Testumgebungen wie WebShop, GaiA, OSWorld und AgentBench ermöglichen eine quantitative Leistungsbewertung der Agenten.
Vielseitige Strategien: Integriert Reinforcement-Learning-Strategien wie Tree-of-Thoughts und Monte Carlo Tree Search, um die Denkfähigkeit der Agenten bei Langzeitplanungsaufgaben zu verbessern.
Community-Zusammenarbeit: Ermöglicht es Benutzern, Code und Datensätze einzureichen; wichtige Mitwirkende können als Co-Autoren in Veröffentlichungen aufgenommen werden, um die gemeinschaftliche Entwicklung zu fördern.
Echtzeit-Fortschrittsberichte: Bietet dynamische Updates zum RL-Feintuning-Prozess und zu den Ergebnissen, sodass Benutzer stets über die neuesten Fortschritte des Projekts informiert sind.
Anwendungsszenarien von OpenManus-RL
Einkaufsentscheidungen: Durch die Anpassung der Agentenumgebung kann die Leistung der Agenten bei Einkaufsentscheidungsaufgaben optimiert werden, beispielsweise durch eine höhere Erfolgsquote beim Kauf in WebShop.
Analyse komplexer Aufgaben: Analyse der Leistung von Agenten bei komplexen Aufgaben anhand von Kennzahlen wie Erfolgsquote und Reaktionszeit in Benchmark-Tests wie GAIA und OSWorld, um Entwicklern den Vergleich der Modelle zu ermöglichen.
Optimierung multimodaler Aufgaben: Optimierung des Agentenverhaltens in multimodalen Aufgabenumgebungen wie OSWorld, um die Leistung bei multimodalen Aufgaben zu verbessern.
Langzeitplanungsaufgaben: Mithilfe der integrierten vielseitigen Strategien wird die Denkfähigkeit der Agenten bei Langzeitplanungsaufgaben verbessert, etwa durch die Tree-of-Thoughts-Strategie zur Optimierung des Agentenverhaltens.
OpenManus-RLInstallation
1. Conda-Umgebung erstellen: Um Abhängigkeitskonflikte zu vermeiden, empfiehlt es sich, eine Umgebung mit Conda zu erstellen. Die Befehle lauten wie folgt:
conda create -n openmanus-rl python=3.10
conda activate openmanus-rl
2. Projekt klonen: Stellen Sie sicher, dass Git installiert ist, klonen Sie anschließend das Projekt und wechseln Sie in das Projektverzeichnis. Die Befehle lauten wie folgt:
git clone https://github.com/OpenManus/OpenManus-RL.git
cd OpenManus-RL
3. Abhängigkeiten installieren: Führen Sie im Projektstammverzeichnis den folgenden Befehl aus, um die Abhängigkeiten zu installieren. Bei langsamer Downloadgeschwindigkeit können Sie einen chinesischen Mirror verwenden:
pip install -r requirements.txt
oder
pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple
Für die Visualisierungswerkzeuge ist eine zusätzliche Installation erforderlich:
pip install matplotlib numpy
4. Modelle und Datensätze konfigurieren:
Supervised Fine-Tuning (SFT): Geben Sie das Modell und den Datensatz an. Der Befehl lautet wie folgt:
python -m openmanus_rl.sft --model_name_or_path Qwen/Qwen2.5-1.5B-Instruct --dataset_name CharlieDreemur/OpenManus-RL
Reinforcement-Learning-Feintuning (GRPO): Konfigurieren Sie die Belohnungsfunktion. Der Befehl lautet wie folgt:
python -m openmanus_rl.grpo --model_name_or_path Qwen/Qwen2.5-1.5B-Instruct --dataset_name CharlieDreemur/OpenManus-RL-GRPO --reward_funcs accuracy format tag_count
Die Datensätze sind auf Huggingface verfügbar.
5. Projekt ausführen:
SFT auf einer einzelnen GPU ausführen:
python -m openmanus_rl.sft --output_dir data/sft-output
GRPO auf mehreren GPUs ausführen (zero3.yaml muss konfiguriert sein):
accelerate launch --config_file=configs/accelerate_configs/zero3.yaml openmanus_rl/grpo.py --output_dir data/grpo-output
Verwendung von OpenManus-RL
1. Aufbau der Agentenumgebung:
Führen Sie python -m openmanus_rl.sft aus, um die Basisumgebung zu erzeugen.
Ändern Sie die Konfigurationsdateien (z. B. Aufgabenziel oder Belohnungsfunktion).
Führen Sie python -m openmanus_rl.grpo aus, um das Feintuning zu starten.
2. Datensammlung und Tests:
Modell konfigurieren (z. B. Deepseek-R1): python -m openmanus_rl.grpo --model_name_or_path Deepseek-R1
Test ausführen: --benchmark GAIA. Die Ergebnisse werden im data/-Verzeichnis gespeichert.
3. RL-Feintuning-Vorgänge:
GRPO-Modus ausführen: python -m openmanus_rl.grpo --reward_funcs accuracy
Trainingsprotokolle einsehen; das Modell wird in data/grpo-output gespeichert.
GitHub-Repository-Adresse: https://github.com/OpenManus/OpenManus-RL









