
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
SpeakerKit: Schnelle und präzise Erkennung verschiedener Sprecher in Audiodateien
小编 ·

SpeakerKit: Schnelle und präzise Erkennung verschiedener Sprecher in Audiodateien
Was ist SpeakerKit?
SpeakerKit ist ein von Argmax entwickeltes Tool zur On-Device-Sprechererkennung (Diarisierung), das verschiedene Sprecher in Audiodateien schnell und effizient identifiziert. Es arbeitet mit WhisperKit (einem Audio-Transkriptionstool) zusammen und erzeugt Transkriptionen mit Sprecherlabels. Es eignet sich für Anwendungsfälle, in denen eine schnelle und genaue Identifizierung von Sprechern in Audiodateien erforderlich ist.
Hauptmerkmale von SpeakerKit
Geschwindigkeit:
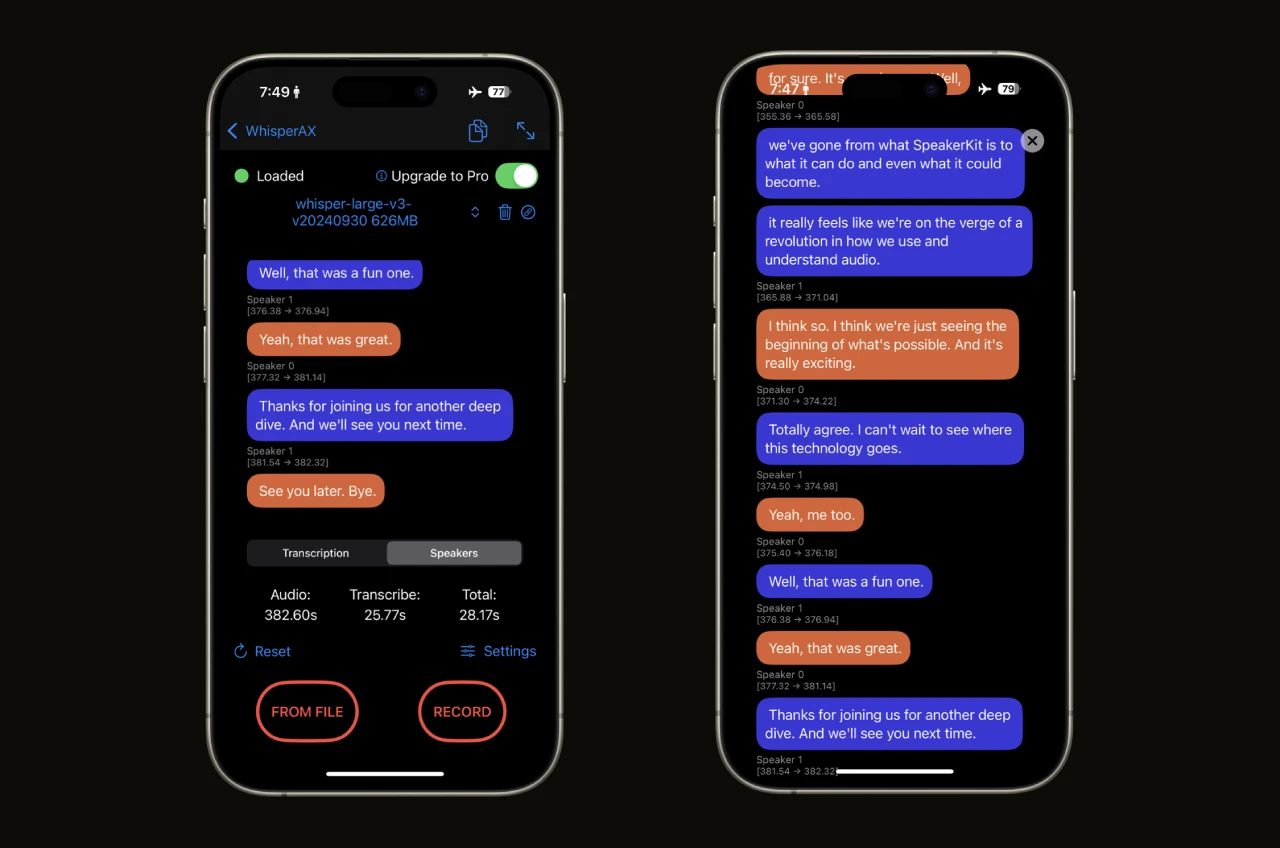
Bei der Verarbeitung von 4 Minuten Audio auf einem iPhone benötigt SpeakerKit nur etwa 1 Sekunde für die Sprechererkennung und ist damit wesentlich schneller als andere vergleichbare Systeme.
In Kombination mit WhisperKit beträgt die Gesamtzeit für Transkription und Erkennung nur 25 Sekunden.
Qualität:
Die Fehlerrate von SpeakerKit ist vergleichbar mit branchenführenden Systemen (wie Pyannote), obwohl es um ein Vielfaches schneller ist.
Größe:
Die Gesamtgröße beträgt etwa 10 MB, was die Integration in Anwendungen oder einen schnellen Download erleichtert.
Kompatibilität:
Unterstützt Geräte mit iOS 16 und macOS 13 oder höher.
Die Android-Unterstützung befindet sich in Entwicklung.
Modularität:
SpeakerKit kann mit WhisperKit zusammenarbeiten, um Transkriptionen mit Sprecherlabels zu erzeugen, und lässt sich auch in andere Transkriptions-Engines integrieren, was mehr Spielraum bietet als serverseitige APIs.
Benchmarks
Argmax hat ein Python-Toolkit namens SDBench entwickelt, um die Leistung von Sprechererkennungssystemen standardisiert auf 13 weit verbreiteten Datensätzen zu testen. Der Code von SDBench wird als Open Source veröffentlicht, das zugehörige Paper erscheint im April 2025.
Zukünftige Pläne
Optimierung der Transkriptionsqualität:Die eigenständige Sprechererkennungsqualität von SpeakerKit erreicht bereits ein branchenführendes Niveau (gemessen am DER). Als Nächstes wird das Team die gemeinsame Nutzung mit WhisperKit optimieren, um die Qualität von Transkriptionen mit Sprecherlabels zu verbessern (gemessen am WDER).
Sprechererkennungsfunktion:SpeakerKit wird eine neue Funktion einführen, mit der Sprecher-Stimmprofile extrahiert und in neuen Kontexten wiedererkannt werden können.
Weiterlesen:https://www.argmaxinc.com/blog/speakerkit
HuggingFace:https://huggingface.co/argmaxinc/speakerkit-pro









