
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
HunyuanVideo-I2V: Tencents Open-Source-Bild-zu-Video-Framework von Hunyuan
小编 ·

HunyuanVideo-I2V: Tencents Open-Source-Bild-zu-Video-Framework von Hunyuan
Was ist HunyuanVideo-I2V?
HunyuanVideo-I2V ist ein neues, am 6. März 2025 von Tencent Hunyuan Open-Source-veröffentlichtes Framework zur Bild-zu-Video-Generierung. Das Framework basiert auf dem zuvor Open-Source-veröffentlichten HunyuanVideo und erweitert dessen Fähigkeiten um die Generierung von Bildern zu Videos. Videoersteller können aus einem einzelnen Bild hochwertige Kurzvideos generieren und profitieren von der Unterstützung für das Training individueller Spezialeffekte.
Funktionsmerkmale von HunyuanVideo-I2V
Bild-zu-Video: HunyuanVideo-I2V kann ein statisches Bild als ersten Frame eines Videos verwenden und basierend auf vom Nutzer eingegebenen Untertiteln oder Beschreibungen passende Videoinhalte erzeugen.
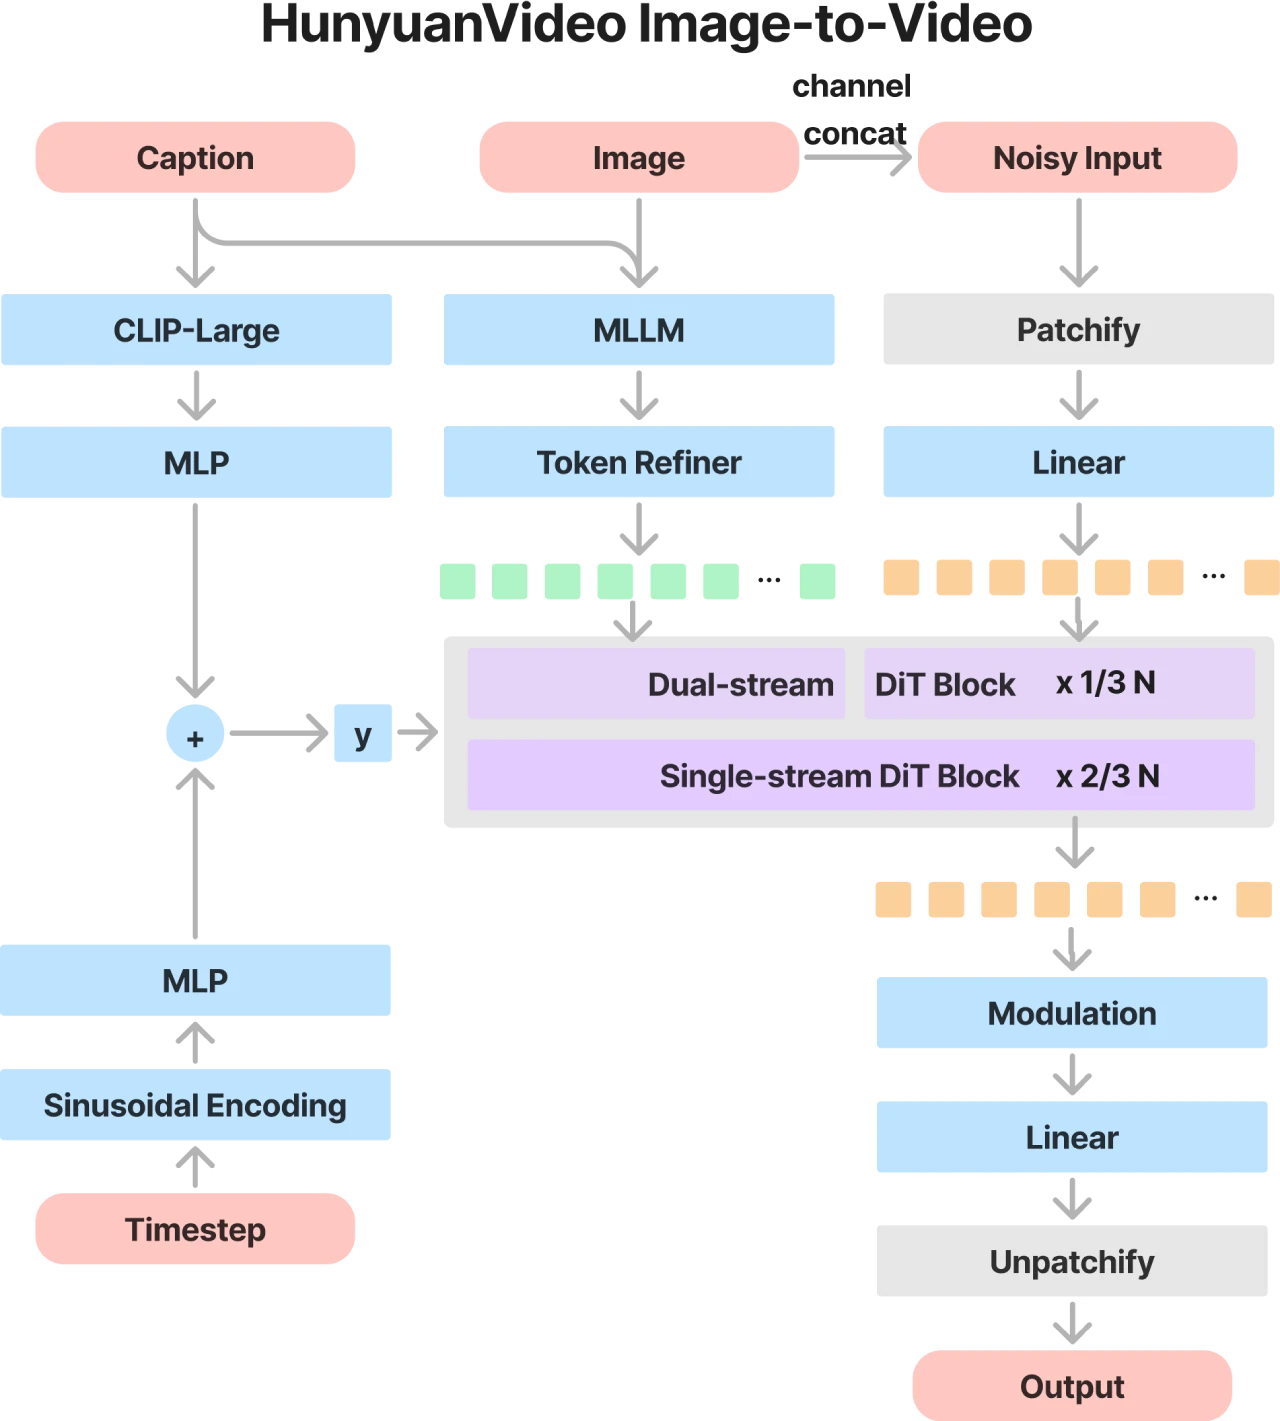
Multimodales großes Sprachmodell (MLLM): Das Modell verwendet ein vortrainiertes multimodales großes Sprachmodell als Text-Encoder und verbessert dadurch deutlich das Verständnis des semantischen Inhalts des eingegebenen Bildes.
3D-Variational-Autoencoder (3D VAE): Ein 3D-VAE, der mit der CausalConv3D-Technik trainiert wurde, komprimiert Videos und Bilder aus dem Pixelraum in einen kompakten latenten Raum und reduziert so die Anzahl der Tokens in den nachfolgenden Modellen.
Hybrides Modell-Design mit zwei- und einstufigem Aufbau: In der zweistufigen Phase werden Video- und Text-Tokens unabhängig voneinander durch mehrere Transformer-Blöcke verarbeitet; in der einstufigen Phase werden Video- und Text-Tokens zusammengeführt, um eine multimodale Informationsfusion durchzuführen.
Progressive Trainingsstrategie: Schrittweiser Übergang von niedriger Auflösung und kurzen Videos zu hoher Auflösung und langen Videos, um die Konvergenzgeschwindigkeit des Modells zu erhöhen.
Prompt-Rewriting-Modell: Löst das Problem variierender Sprachstile und Längen von Nutzer-Prompts, indem es die vom Nutzer eingegebenen Prompts in ein für das Modell leichter verständliches Format umwandelt.
Anpassbares LoRA-Training: Unterstützt das Training von Video-Generierungsmodellen mit spezifischen Effekten wie „Haarwachstum" oder „Personenbewegungen" anhand weniger Daten.
Effiziente Inferenz: Bietet Single-GPU-Inferenz und Multi-GPU-Sequenz-Parallel-Inferenz und ermöglicht so eine schnellere Inferenz.
Technische Architektur von HunyuanVideo-I2V
HunyuanVideo-I2V übernimmt in seiner Gesamtarchitektur das Designkonzept von HunyuanVideo und wurde für die Aufgabe der Bild-zu-Video-Generierung optimiert. Der Kern besteht darin, mithilfe der Bild-Latent-Space-Konkatenationstechnik die Schlüsselinformationen des Referenzbildes in den Video-Generierungsprozess einzubringen und gleichzeitig durch das MLLM eine tiefe Cross-Modal-Fusion von Text- und Bildinformationen zu erreichen.
Verwendung von HunyuanVideo-I2V
1. Installation und Abhängigkeiten
Installieren Sie PyTorch und weitere Abhängigkeiten. Eine detaillierte Installationsanleitung finden Sie auf der GitHub-Seite.
Empfohlen wird eine NVIDIA-GPU mit mindestens 80 GB Videospeicher.
2. Herunterladen der vortrainierten Modelle
Die Gewichte der vortrainierten Modelle können von der GitHub-Seite oder der Hugging-Face-Seite heruntergeladen werden.
3. Inferenz-Code
Verwenden Sie den bereitgestellten Inferenz-Code (z. B. sample_video.py), um Videos zu generieren.
4. LoRA-Training
Es wird LoRA-Trainingscode bereitgestellt, mit dem Nutzer anhand weniger Daten Video-Generierungsmodelle mit bestimmten Effekten trainieren können.
Anwendungsszenarien von HunyuanVideo-I2V
Video-Content-Erstellung: Bietet Videoerstellern ein effizientes und hochwertiges Werkzeug zur Videogenerierung.
Film- und Fernsehproduktion: Erzeugt Videoinhalte in Filmqualität.
Personalisierte Videos: Generiert personalisierte Videos auf Basis vom Nutzer hochgeladener Bilder und Beschreibungen.
Offizielle Website:https://video.hunyuan.tencent.com/
GitHub:https://github.com/Tencent/HunyuanVideo-I2V
Hugging Face: https://huggingface.co/tencent/HunyuanVideo-I2V









