
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
UniTok: ByteDance's Open-Source-Visual-Tokenizer für Generierungs- und Verstehensaufgaben
小编 ·

UniTok: ByteDance's Open-Source-Visual-Tokenizer für Generierungs- und Verstehensaufgaben
Was ist UniTok?
UniTok ist ein von ByteDance quelloffen veröffentlichtes visuelles Tokenizer-Modell, das sowohl für Generierungs- als auch für Verstehensaufgaben eingesetzt wird. Es kann visuelle Informationen effizient in Tokens umwandeln und eignet sich für verschiedene autoregressive Generierungsmodelle sowie multimodale Verstehensmodelle. Durch eine innovative visuelle Tokenisierung ermöglicht es die Erzeugung hochwertiger visueller Inhalte – wie zum Beispiel die Rekonstruktion von Bildern und Videos – mit einer äußerst geringen Anzahl von Tokens (beispielsweise 256 Tokens).
Kernfunktionen von UniTok
Effiziente visuelle Kodierung: UniTok kann komplexe visuelle Informationen (wie Bilder und Videos) in diskrete Tokens zerlegen, sodass sie vom Modell einfach verarbeitet werden können.
Multimodale Unterstützung: Es eignet sich nicht nur für Bilder, sondern auch für Videoinhalte und unterstützt sowohl kontinuierliche als auch diskrete Tokenisierung.
Geringer Ressourcenbedarf: UniTok behält auch bei einer niedrigen Token-Anzahl eine hohe Rekonstruktionsqualität bei – so beträgt der Rekonstruktionsfehler bei 256 Tokens lediglich 0,39.
Flexible Kompressionsrate: Nutzer können die Anzahl der Tokens je nach Bedarf anpassen, um ein Gleichgewicht zwischen Generierungsqualität und Rechenleistung herzustellen.
Anwendungsbereiche von UniTok
Visuelle Generierungsaufgaben: Wie Bild- und Videorekonstruktion sowie sprachmodellgestützte visuelle Synthese.
Multimodales Verstehen: Durch die Kombination von Text- und Bildinformationen wird ein effizienteres Training multimodaler Modelle ermöglicht.
Diffusionsmodelle: In Kombination mit Diffusionsmodellen wie DiT und Latte lassen sich hochwertige visuelle Inhalte erzeugen.
Technische Umsetzung von UniTok
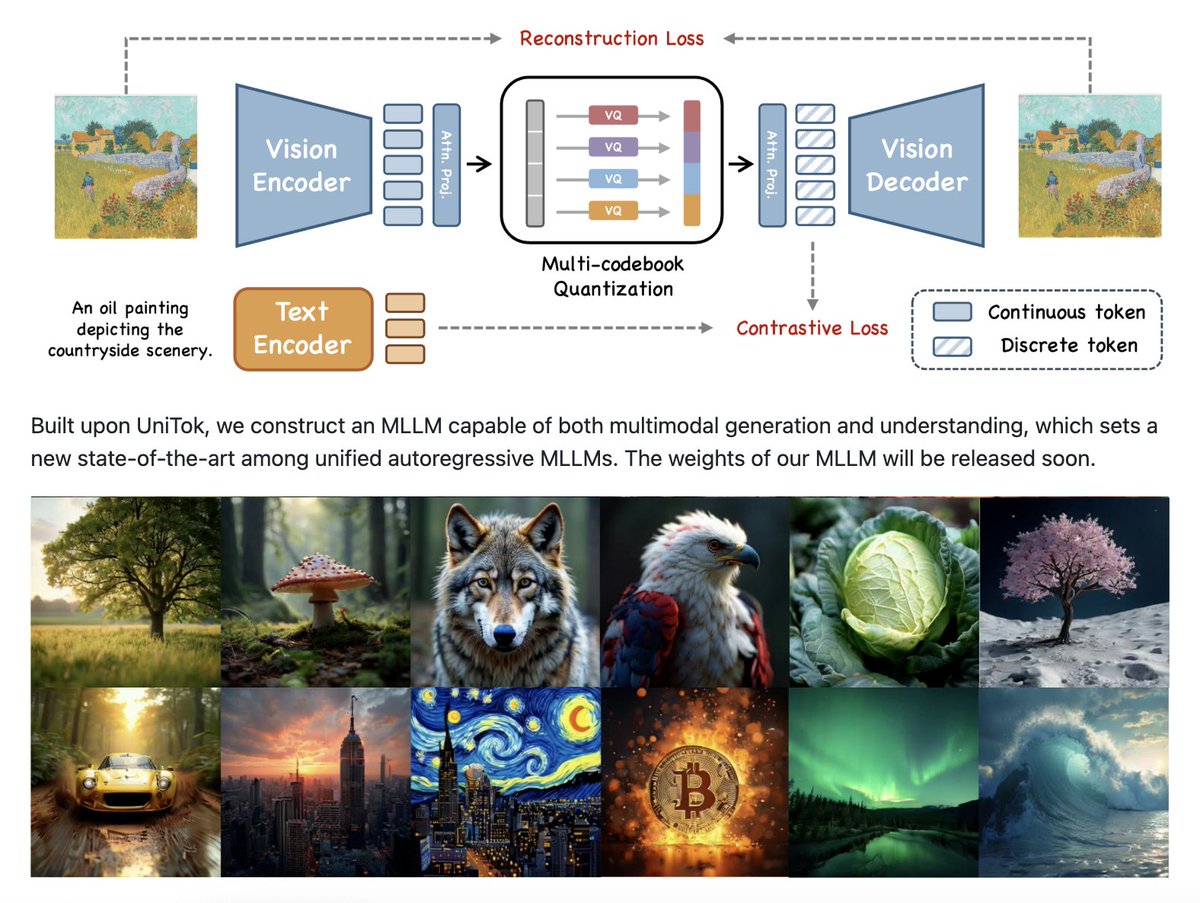
UniTok basiert auf den Technologien VQVAE (Variational Quantized Variational Autoencoder) und VAE (Variational Autoencoder) und erreicht durch ein zweistufiges Training eine effiziente visuelle Kodierung. Der Trainingsprozess umfasst:
Einfachauflösungstraining für Bilder: Training auf Bildern mit einer festen Auflösung.
Gemeinsames Multi-Resolution-Training für Bilder und Videos: Gemeinsames Training auf Bildern und Videos mit mehreren Auflösungen.
VAE-Feintuning: Feintuning des VQVAE-Modells mittels KL-Verlust, um das VAE-Modell zu erhalten.
Vorteile von UniTok
Ein einziges Modell und ein einziger Gewichtssatz: UniTok verarbeitet die Tokenisierung von Bildern und Videos mit einem einzigen Modell und einem einzigen Gewichtssatz, was die Modellverwaltung und -bereitstellung vereinfacht.
Hohe Anpassungsfähigkeit: Unterstützung für hochauflösende Eingaben und lange Videos, geeignet für vielfältige Anwendungsszenarien.
Starke Kompatibilität: Kompatibel mit Sprachmodellen und Diffusionsmodellen, um vielfältige visuelle Generierungen zu ermöglichen.
UniTok löst durch Multi-Codebuch-Quantisierung den Engpass herkömmlicher Tokenizer bei Generierungs- und Verstehensaufgaben und bietet eine effizientere Lösung für multimodale große Sprachmodelle (MLLMs).
Projekt-URL:https://foundationvision.github.io/UniTok/
GitHub-Repository:https://github.com/FoundationVision/UniTok









