
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
CSM: Sesames Sprachsynthesemodell — wie ein Gespräch mit einem echten Menschen
小编 ·

CSM: Sesames Sprachsynthesemodell — wie ein Gespräch mit einem echten Menschen
Was ist CSM?
CSM (Conversational Speech Model) ist ein von Sesame entwickeltes konversationelles Sprachsynthesemodell. Es basiert auf der Transformer-Architektur und verwendet eine Ende-zu-Ende-Multimodal-Lernmethode. Es kann Kontext und emotionale Hintergründe berücksichtigen und äußerst realistische, menschenähnliche Sprache synthetisieren, was es im Bereich der Sprachsynthese besonders leistungsstark macht.
Funktionsmerkmale von CSM
Natürliche Sprachdarstellung: Ahmt Intonation, Rhythmus und Klangfarbe echter menschlicher Stimmen nach und löst das Problem der eintönigen Intonation herkömmlicher Sprachsynthesesysteme, sodass die synthetisierte Sprache wie eine echte menschliche Stimme klingt.
Feinfühlige emotionale Ausdrucksweise: Kann emotionale Elemente, Pausen, Betonungen und mehr einbauen, um Wut, Trauer, Aufregung und verschiedene andere Emotionen zu vermitteln, wodurch Gespräche ansprechender werden.
Niedrige Latenzreaktion: Durch optimierte Berechnungsmethoden wird ein reibungsloser Dialog gewährleistet, und die ki-Antwortzeit ist äußerst kurz und kommt der sofortigen Reaktion eines Menschen nahe.
Multimodale Interaktion: Kann gleichzeitig Texteingaben und Sprachverlauf verarbeiten, verfügt über Kontextwahrnehmung, versteht den Gesprächshintergrund und die Emotionen und macht die Sprache natürlicher und interaktiver.
Persönlichkeitskonsistenz: Hält stabile Sprachmerkmale aufrecht, vermeidet Inkonsistenzen in verschiedenen Situationen und beseitigt die Roboter-artige Intonation herkömmlicher TTS-Systeme.
Dynamische Gesprächsmodellierung: Simuliert natürliche Pausen, Sprechgeschwindigkeit, Betonung und andere Faktoren in menschlichen Gesprächen und verstärkt so die Realitätsnähe und Interaktivität der Sprachinteraktion.
Technische Highlights von CSM
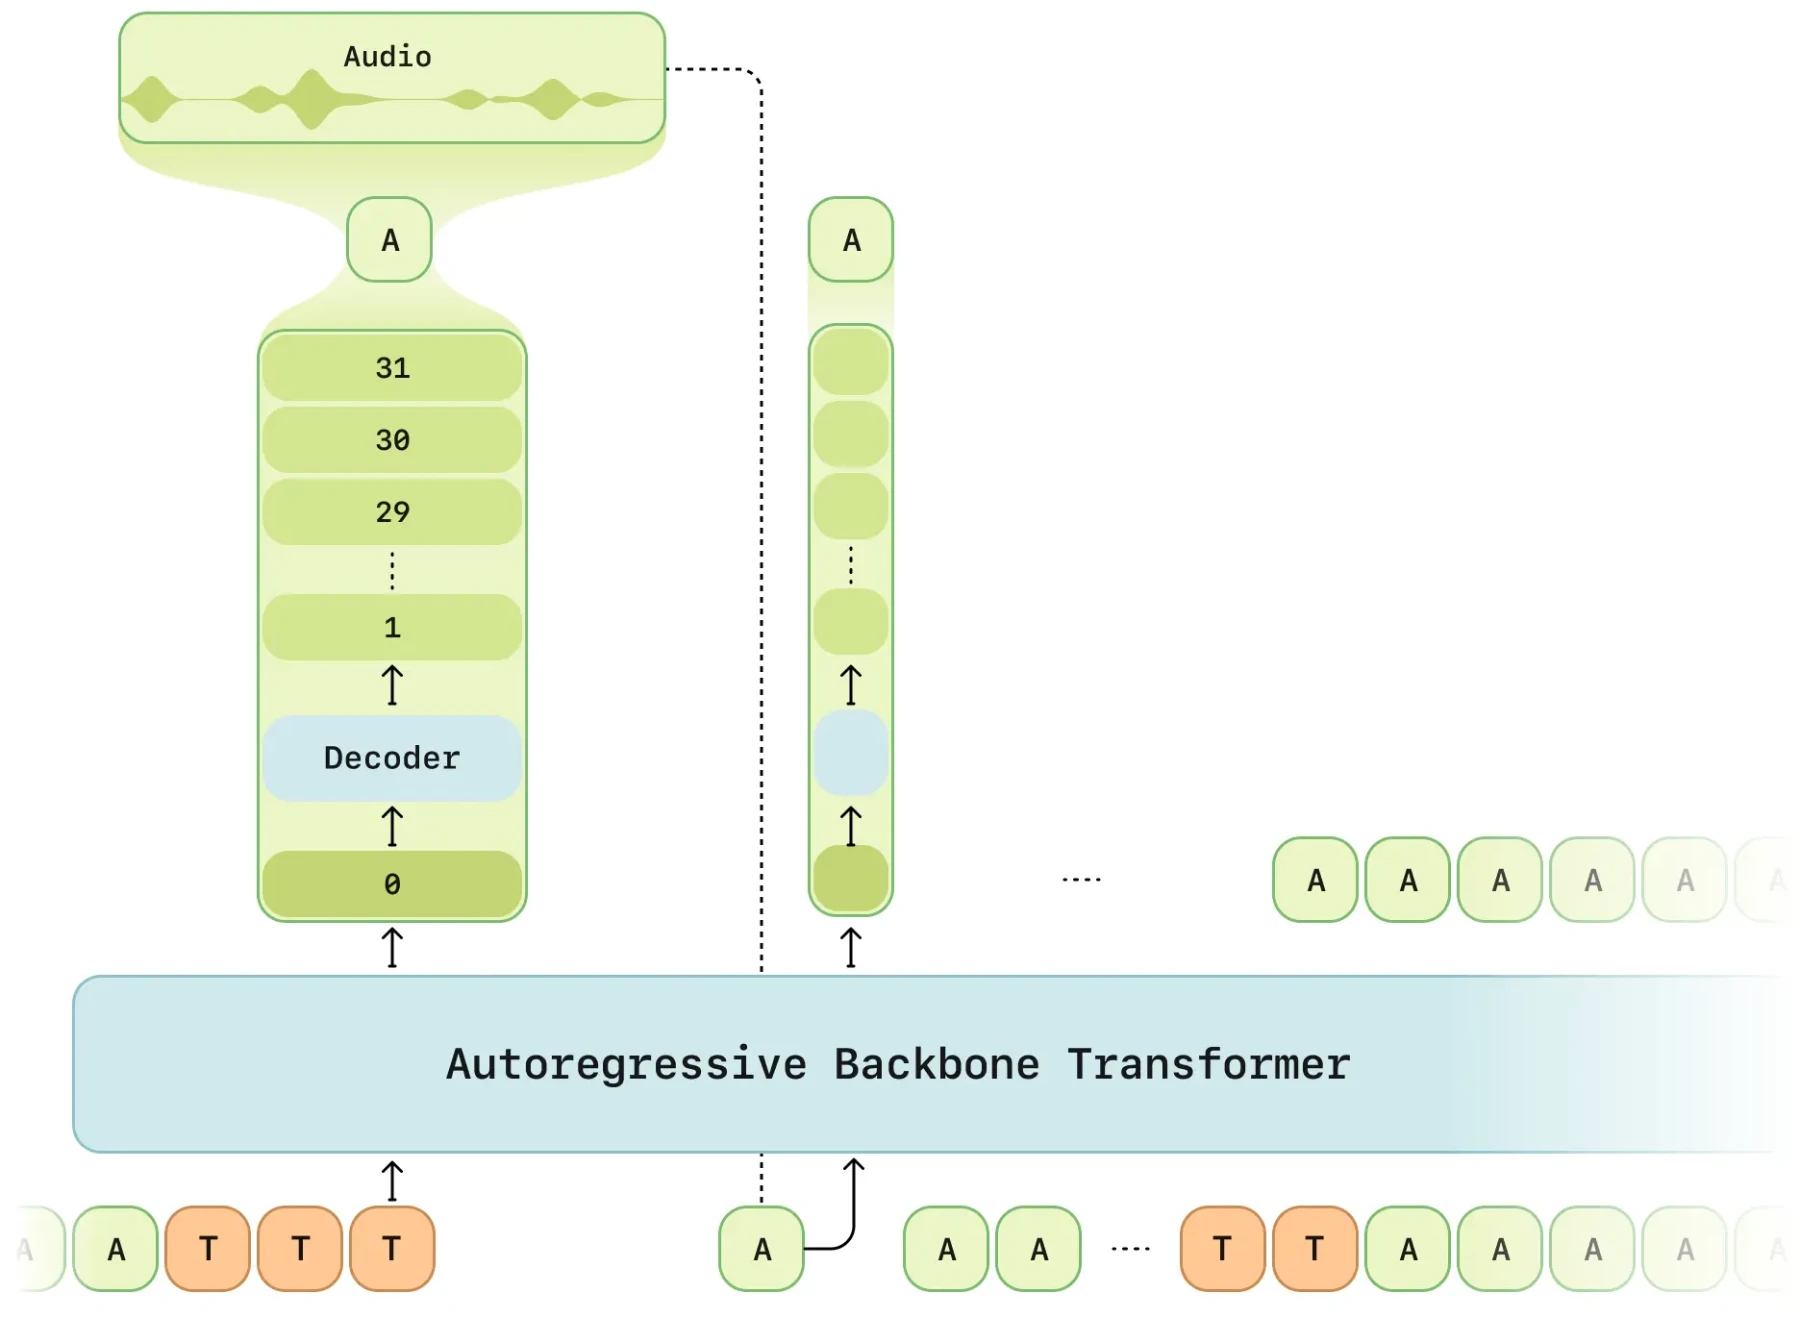
Ende-zu-Ende-Multimodal-Transformer-Architektur: Erzeugt direkt aus Text qualitativ hochwertige Sprache ohne Zwischenschritte. Mit Transformer als Kern verfügt die KI-Sprache über Kontextwahrnehmung. Text wird mit dem LLaMA-Tokenizer verarbeitet, Sprache mit dem Mimi-Tokenizer kodiert und RVQ-Quantisierungstechnologie eingesetzt.
Audio-Codierung auf Basis von Residual Vector Quantization (RVQ): Es werden zwei Arten von Audio-Tokens verwendet: semantische Tokens, die die Sprachsemantik und Ausspracheeigenschaften repräsentieren, und akustische Tokens, die Details wie Tonhöhe, Klangfarbe und Prosodie darstellen. Durch hierarchisches RVQ-Training sagen verschiedene Ebenen Kern- und Detaileigenschaften vorher, wodurch Informationsverlust vermieden und die Natürlichkeit der Sprache verbessert wird.
Rechenoptimierung und Inferenz mit niedriger Latenz
Latenzmodus-Optimierung: Zuerst werden die niedrigeren RVQ-Schichten berechnet, dann iterativ die hochstufigen Detaileigenschaften, was die Inferenzgeschwindigkeit erhöht.
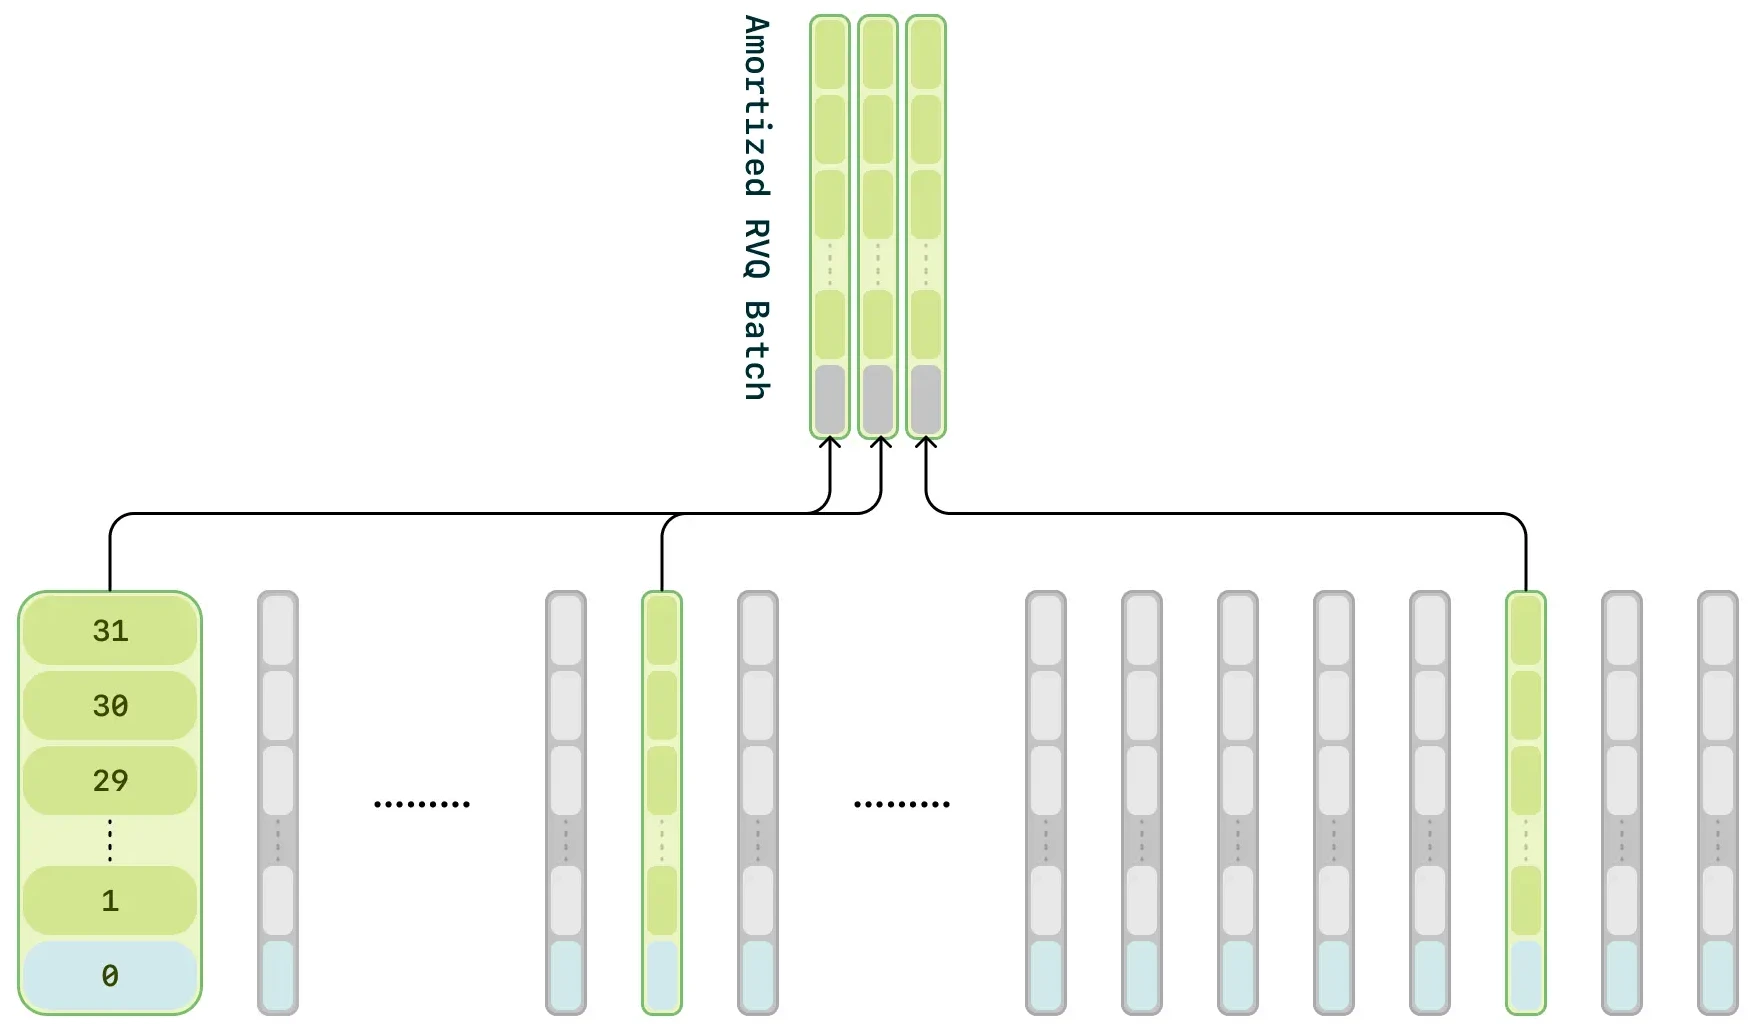
Compute-Amortisation: In der Trainingsphase wird zufällig 1/16 der Audio-Frames zur Optimierung abgetastet, wodurch der Rechenaufwand reduziert wird, ohne die Audioqualität zu beeinträchtigen.
Zweistufige Transformer-Struktur: Ein Backbone-Transformer verarbeitet Text- und Audioinformationen und sagt die Grundstruktur vorher; ein leichtgewichtiger Decoder verfeinert das Audio, reduziert den Rechenaufwand und erhöht die Inferenzgeschwindigkeit.
Breite Anwendung von CSM
Intelligente Assistenten: Macht die Sprachinteraktion von intelligenten Lautsprechern und virtuellen Assistenten natürlicher und freundlicher, wie ein Gespräch mit einem echten Menschen.
Kundenservice: Einsatz in Kundenservicesystemen, um Benutzern ein reibungsloseres Interaktionserlebnis zu bieten und die Zufriedenheit zu steigern.
Bildung und Schulung: Schafft in Sprachlernanwendungen eine realistische Gesprächsumgebung, die Lernenden hilft, Sprachkenntnisse zu verstehen und zu üben.
Unterhaltungsindustrie: Verleiht Charakteren in Spielen, Animationen und anderen Branchen lebendige und realistische Stimmen und macht Geschichten fesselnder.
Entwicklung virtueller Assistenten: Erschafft virtuelle Assistenten mit natürlicheren Stimmen, die einen persönlichen Service bieten.
Optimierung von Übersetzungstools: Erzeugt in der Echtzeit-Sprachübersetzung natürliche, fließende Dialoge und verbessert das Übersetzungserlebnis.
Interaktion auf Bildungsplattformen: Spielt eine Rolle bei interaktiven Sprachdialogen auf Bildungsplattformen und steigert den Spaß und die Effektivität des Lernens.
Nutzungsweise von CSM
Online-Erlebnis
Sie können die offizielle Website von Sesame (sesame.com/voicedemo) besuchen, um die Effekte der Sprachsynthesetechnologie zu erleben.
Integration in Produkte
Entwickler können das Sesame-Sprachmodell in Sprachassistenten, intelligente Kundenservicesysteme und andere Produkte oder Dienstleistungen integrieren, um die Sprachinteraktionsfähigkeit zu verbessern.
Forschung und Entwicklung
Sesame plant, die Modellgröße zu erweitern und die Datenmenge zu erhöhen. Forscher können die offiziellen Vorstellungen und Demonstrationen (https://www.sesame.com/research/crossing_the_uncanny_valley_of_voice ) verfolgen, um die neuesten Ergebnisse und technischen Fortschritte zu erfahren.
Für ein Online-Erlebnis besuchen Sie bitte:https://www.sesame.com/research/crossing_the_uncanny_valley_of_voice#demo









