
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Migician: Multimodales Modell von Tsinghua-Universität und Partnern für Objektlokalisierung in mehreren Bildern in komplexen Szenen
小编 ·

Migician: Multimodales Modell von Tsinghua-Universität und Partnern für Objektlokalisierung in mehreren Bildern in komplexen Szenen
Was ist Migician?
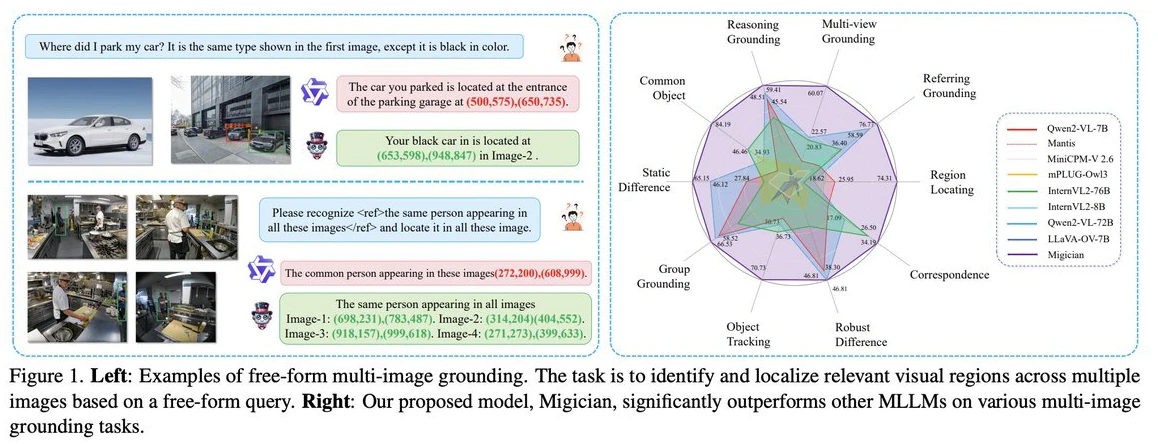
Migician ist ein multimodales großes Sprachmodell, das gemeinsam von der Tsinghua-Universität, der Beijing Jiaotong University und der Huazhong University of Science and Technology entwickelt wurde und in der Lage ist, freie (free-form) und präzise Lokalisierung in Multi-Bild-Szenarien durchzuführen. Es unterstützt die schnelle Lokalisierung von Zielbereichen in mehreren Bildern durch Textbeschreibungen, Bilder oder eine Kombination aus beidem und verbessert so die Lokalisierungsfähigkeit in Multi-Bild-Szenarien.
Hauptfunktionen von Migician
Bildübergreifende Lokalisierung: Migician unterstützt verschiedene Methoden der bildübergreifenden Lokalisierung, einschließlich „Bild-zu-Bild-Suche" und kombinierter Abfragen aus „Text + Bild". Beispielsweise kann das Modell in der Videoüberwachung anhand einer Textbeschreibung wie „ein Mann mit schwarzem Oberteil, blauer Jeans und weißer Baseballkappe" in zahlreichen Überwachungsbildern schnell die Person finden, die der Beschreibung entspricht.
Multimodale Fusion: Durch eine fortschrittliche neuronale Netzwerkarchitektur integriert Migician visuelle und sprachliche Informationen effektiv und erschließt tiefgreifend semantische Zusammenhänge zwischen Bildern. Bei der Aufgabe „in einer Reihe von Stadtansichten das Bild mit einem roten Auto finden" extrahiert das Modell beispielsweise visuelle Merkmale wie Farben und Formen aus den Bildern, analysiert gleichzeitig die semantischen Informationen des Textes „rotes Auto" und führt beide zusammen, um das Ziel genauer zu lokalisieren.
CoT (Chain-of-Thought) Reasoning-Optimierung: Migician führt eine CoT-Reasoning-Optimierung ein, die komplexe Probleme in mehrere einfache Teilprobleme zerlegt und schrittweise zur endgültigen Antwort gelangt. Bei der Lokalisierung eines bestimmten Gegenstands in einem Raum beurteilt das Modell beispielsweise zunächst anhand der Textbeschreibung, in welchem Bereich sich der Raum befinden könnte, und lokalisiert den Gegenstand dann in den Bildern dieses Bereichs präzise.
End-to-End-Framework: Migician verwendet ein End-to-End-Framework, das mehrere Bildeingaben direkt verarbeitet und die in herkömmlichen schrittweisen Inferenzmethoden auftretenden Fehlerakkumulationen und Effizienzprobleme vermeidet.
Modellleistung
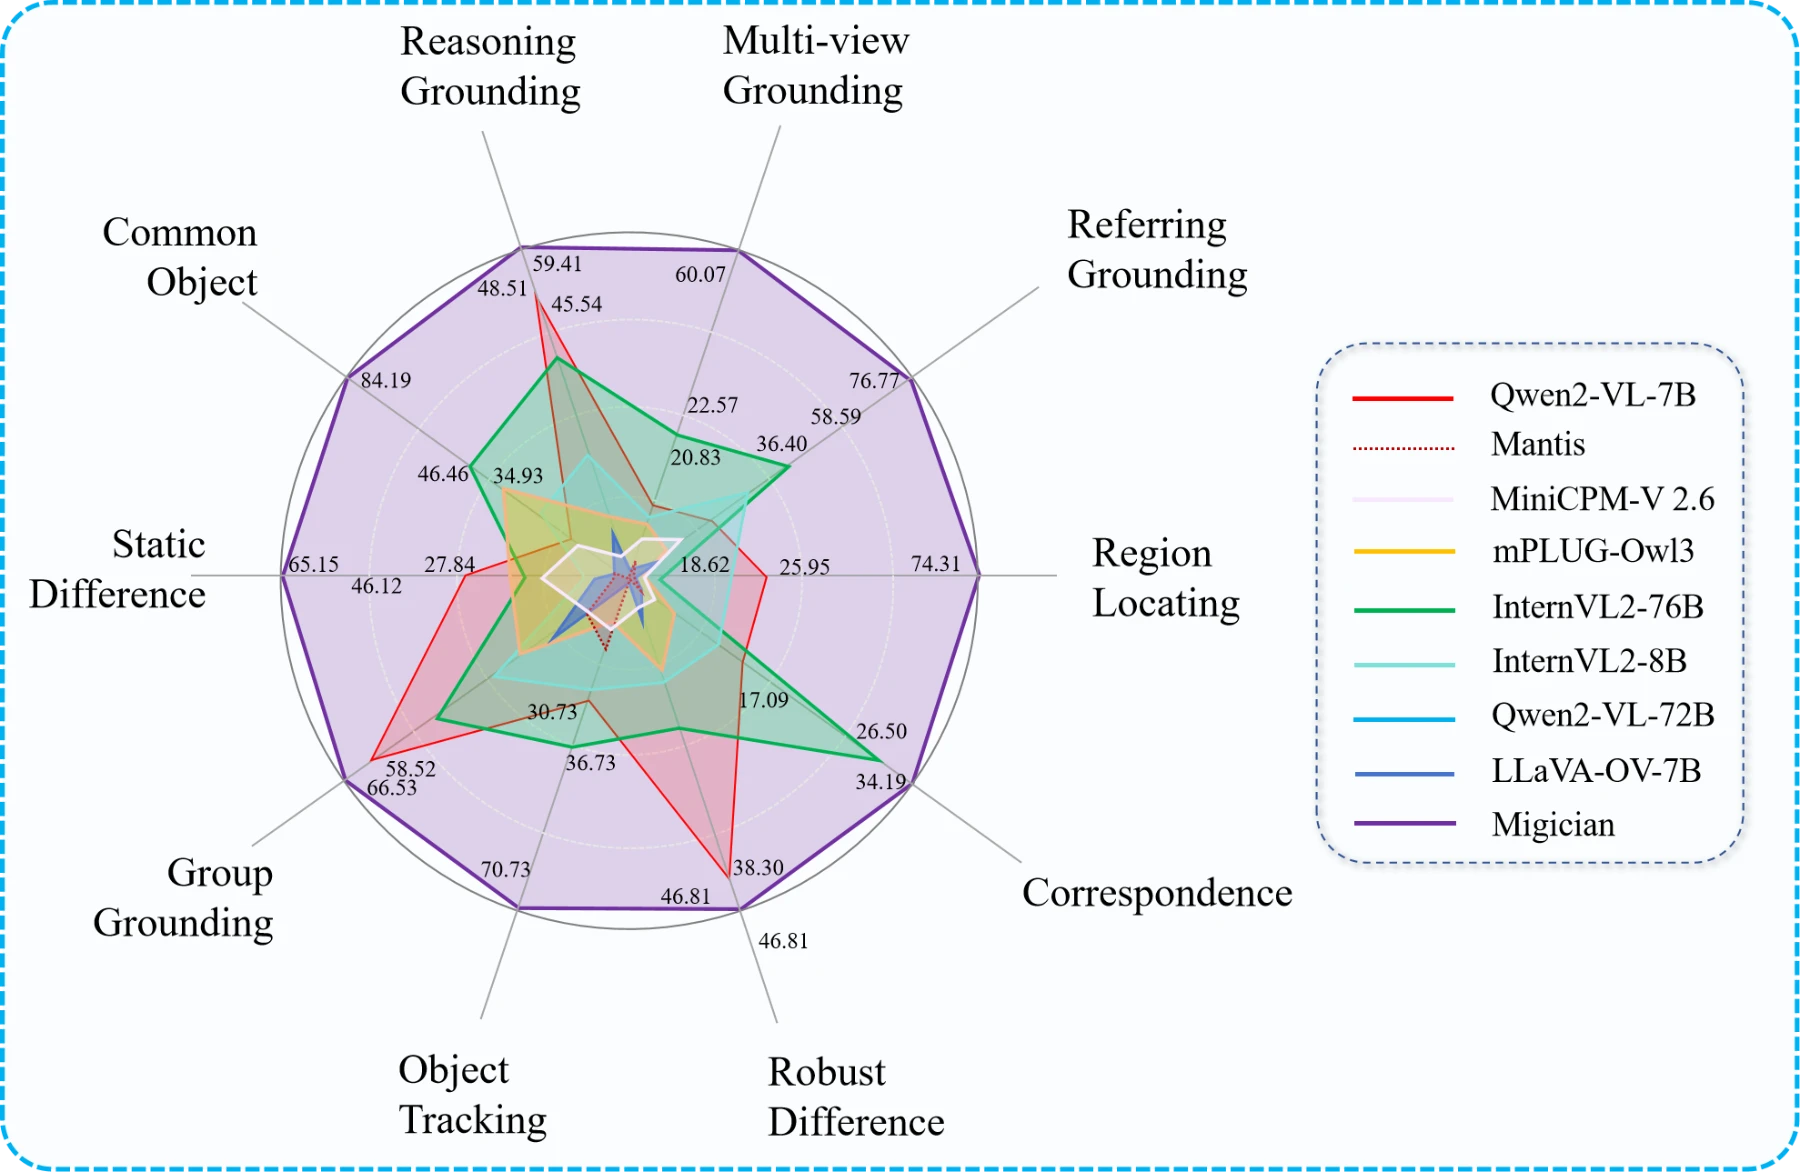
Leistung: Migician schneidet bei Multi-Bild-Lokalisierungsaufgaben hervorragend ab, übertrifft bestehende MLLMs deutlich und übertrifft sogar in mehreren Aufgaben größere 70B-Modelle. Konkret übertrifft Migician auf MIG-Bench die Leistung des derzeit besten MLLM um 21,61 %.
Bewertungsmetriken: MIG-Bench stellt Bewertungsmetriken wie [email protected], [email protected], [email protected] und den durchschnittlichen IOU bereit. Benutzer können das Skript MIG_bench_eval.py ausführen, um eine One-Click-Bewertung durchzuführen.
Anwendungsszenarien von Migician
Videoüberwachung und Sicherheit: Echtzeitanalyse der Bilder mehrerer Überwachungskameras zur schnellen Lokalisierung verdächtiger Personen, Fahrzeuge oder ungewöhnlicher Ereignisse.
Autonomes Fahren: Fusion der Bildinformationen aus mehreren Fahrzeugsensoren in Kombination mit Textbeschreibungen von Straßen, Hindernissen, Verkehrszeichen usw., um dem Fahrzeug eine genauere Wahrnehmung seiner Umgebung zu ermöglichen.
Medizinische Bildgebung: Schnelle Lokalisierung von Läsionsbereichen in mehreren medizinischen Bildern zur Unterstützung der Krankheitsdiagnose.
Robotik und embodied AI: Unterstützung von Robotern bei der schnellen Lokalisierung von Zielobjekten in komplexen Umgebungen, um Aufgaben wie Greifen und Transportieren auszuführen.
Projektressourcen zu Migician
GitHub-Repository:https://github.com/thunlp/Migician
Paper-Adresse:https://arxiv.org/pdf/2501.05767
Migician ist ein leistungsstarkes Werkzeug, das speziell für Multi-Bild-Lokalisierungsaufgaben entwickelt wurde. Mit Hilfe des umfangreichen Datensatzes MGrounding-630k und des umfassenden Test-Benchmarks MIG-Bench wurde seine Lokalisierungsfähigkeit in Multi-Bild-Szenarien deutlich verbessert.









