
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Octave: Kontextbewusstes und emotional anpassungsfähiges TTS-Modell von Hume AI
小编 ·

Octave: Kontextbewusstes und emotional anpassungsfähiges TTS-Modell von Hume AI
Was ist Octave?
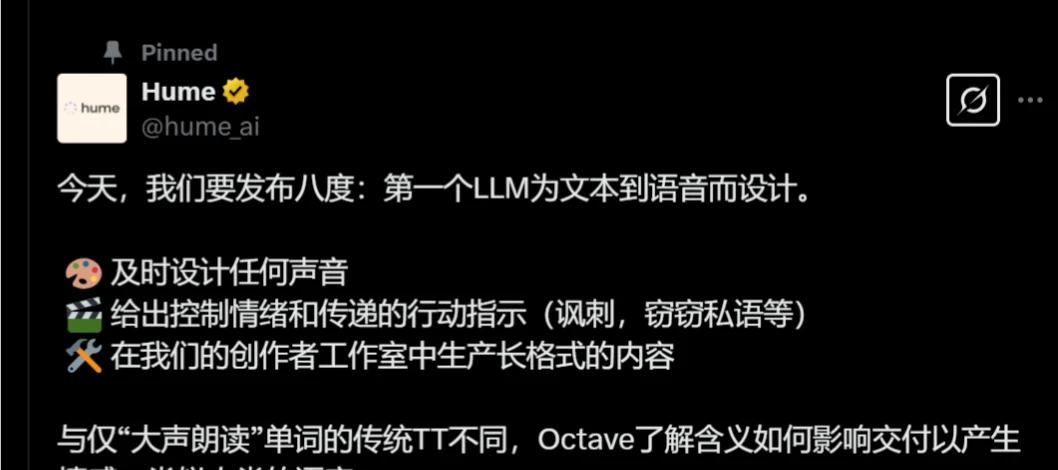
Octave ist ein brandneues Text-zu-Sprache-Modell, das von Hume ai veröffentlicht wurde. Es kann anhand von Textbeschreibungen gleichzeitig Klang und dazu passende Persönlichkeitsmerkmale erzeugen, einschließlich Sprachstil, Akzent und Ausdrucksweise – beispielsweise lässt sich eine sarkastische Aussage in einen verächtlichen Tonfall umwandeln. Octave unterstützt Echtzeit-Interaktionen sowie die Erzeugung von Dialogen mit mehreren Rollen, kann komplexe Dialogszenarien simulieren und ermöglicht es, frei zwischen verschiedenen Sprechstilen zu wechseln.
Funktionsmerkmale von Octave
Hohe Natürlichkeit und emotionaler Ausdruck: Octave kann äußerst natürliche Sprache erzeugen, die nicht nur menschliche Stimmmerkmale imitiert, sondern auch in der Lage ist, je nach Textinhalt feine Emotionen wie Freude, Trauer oder Ironie auszudrücken.
Personalisierter Stimmklon: Schon mit einem kurzen Stimm-Sample (z. B. einer 5-Sekunden-Aufnahme) kann Octave die einzigartige Stimme und die Persönlichkeitsmerkmale eines Sprechers klonen und so virtuelle Assistenten, Spielcharaktere und mehr mit einem individuellen Spracherlebnis ausstatten.
Kontextbewusstsein und emotionale Anpassung: Im Gegensatz zu herkömmlichen Systemen legt Octave Wert auf kontextuelle Kohärenz, erfasst emotionale Veränderungen zwischen Sätzen und sorgt so für realistischere und flüssigere Dialoge.
Multimodalität und Emotionstraining: Durch die Integration von Text- und Sprachmodi kann Octave kontextbasierte Antworten liefern und sich an den emotionalen Ton eines Gesprächs anpassen – möglich wird dies durch Millionen annotierter Sprachsamples, mit denen das Modell trainiert wurde.
Technische Merkmale von Octave
Zero-Shot- und Few-Shot-Lernen: Octave nutzt fortschrittliche Techniken des maschinellen Lernens und kann mit wenigen oder ohne direkte Samples neue Stimmen erlernen und erzeugen, was den Individualisierungsprozess erheblich vereinfacht.
Leichtgewichtige Bereitstellung und Edge-Computing: Das Design ermöglicht den Einsatz auf Edge-Geräten, reduziert Latenzzeiten und gewährleistet flüssige Echtzeit-Interaktionen. Damit eignet es sich für zahlreiche Anwendungsszenarien – vom Kundenservice bis zur Smart-Home-Steuerung.
Mehrsprachigkeit und Akzentunterstützung: Octave beschränkt sich nicht auf eine einzige Sprache, sondern unterstützt die Umwandlung in mehrere Sprachen und Akzente, was seinen weltweiten Einsatzbereich deutlich erweitert.
Leistung von Octave
In Bezug auf Audioqualität, Natürlichkeit sowie die Übereinstimmung zwischen der erzeugten Stimme und der gewünschten Stimmbeschreibung schneidet Octave in Benchmark-Tests hervorragend ab.
Die Version OCTAVE 3B zeigt zudem bei ARC (einfache Aufgaben) eine bemerkenswert starke Leistung und übertrifft dabei sogar zahlreiche andere führende Modelle.
Anwendungsszenarien von Octave
Hörbücher und Podcasts: Für jedes Hörbuch wird eine durchgängig einzigartige Stimme für die jeweilige Figur erzeugt.
Spiele und Film/TV: Anhand des Drehbuchs werden die Merkmale und Stile der Charaktere interpretiert und der Tonfall an die jeweilige Emotion angepasst – ganz ohne ausdrückliche Anweisungen.
Kundenservice: Bei der Bearbeitung von Kundenanfragen wird der emotionale Zustand des Kunden präzise erkannt und die Reaktion dynamisch an die jeweilige Emotion angepasst.









