
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
VLM-R1: R1-Style Vision-Language-Modell mit höherer Stabilität und Generalisierungsfähigkeit
小编 ·

VLM-R1: R1-Style Vision-Language-Modell mit höherer Stabilität und Generalisierungsfähigkeit
Was ist VLM-R1?
VLM-R1 (Visual Language Model - R1) ist ein neuartiges Open-Source-Visuell-Sprach-Modell, das vom Team des Om ai Lab entwickelt wurde. Im Kern überträgt es die DeepSeek-R1-Methode erfolgreich in den Bereich der visuellen Sprachmodelle und erreicht dadurch eine höhere Stabilität und Generalisierungsfähigkeit.
VLM-R1 basiert auf Qwen2.5-VL und verbessert die visuelle Verständnisfähigkeit durch verstärktes Lernen. Bei visuellen Aufgaben, insbesondere beim Verstehen domänenübergreifender Daten, übertrifft es herkömmliche SFT-Modelle und zeigt eine starke Leistung beim Verstehen visueller Inhalte – ein wichtiger Durchbruch in der Entwicklung multimodaler KI.
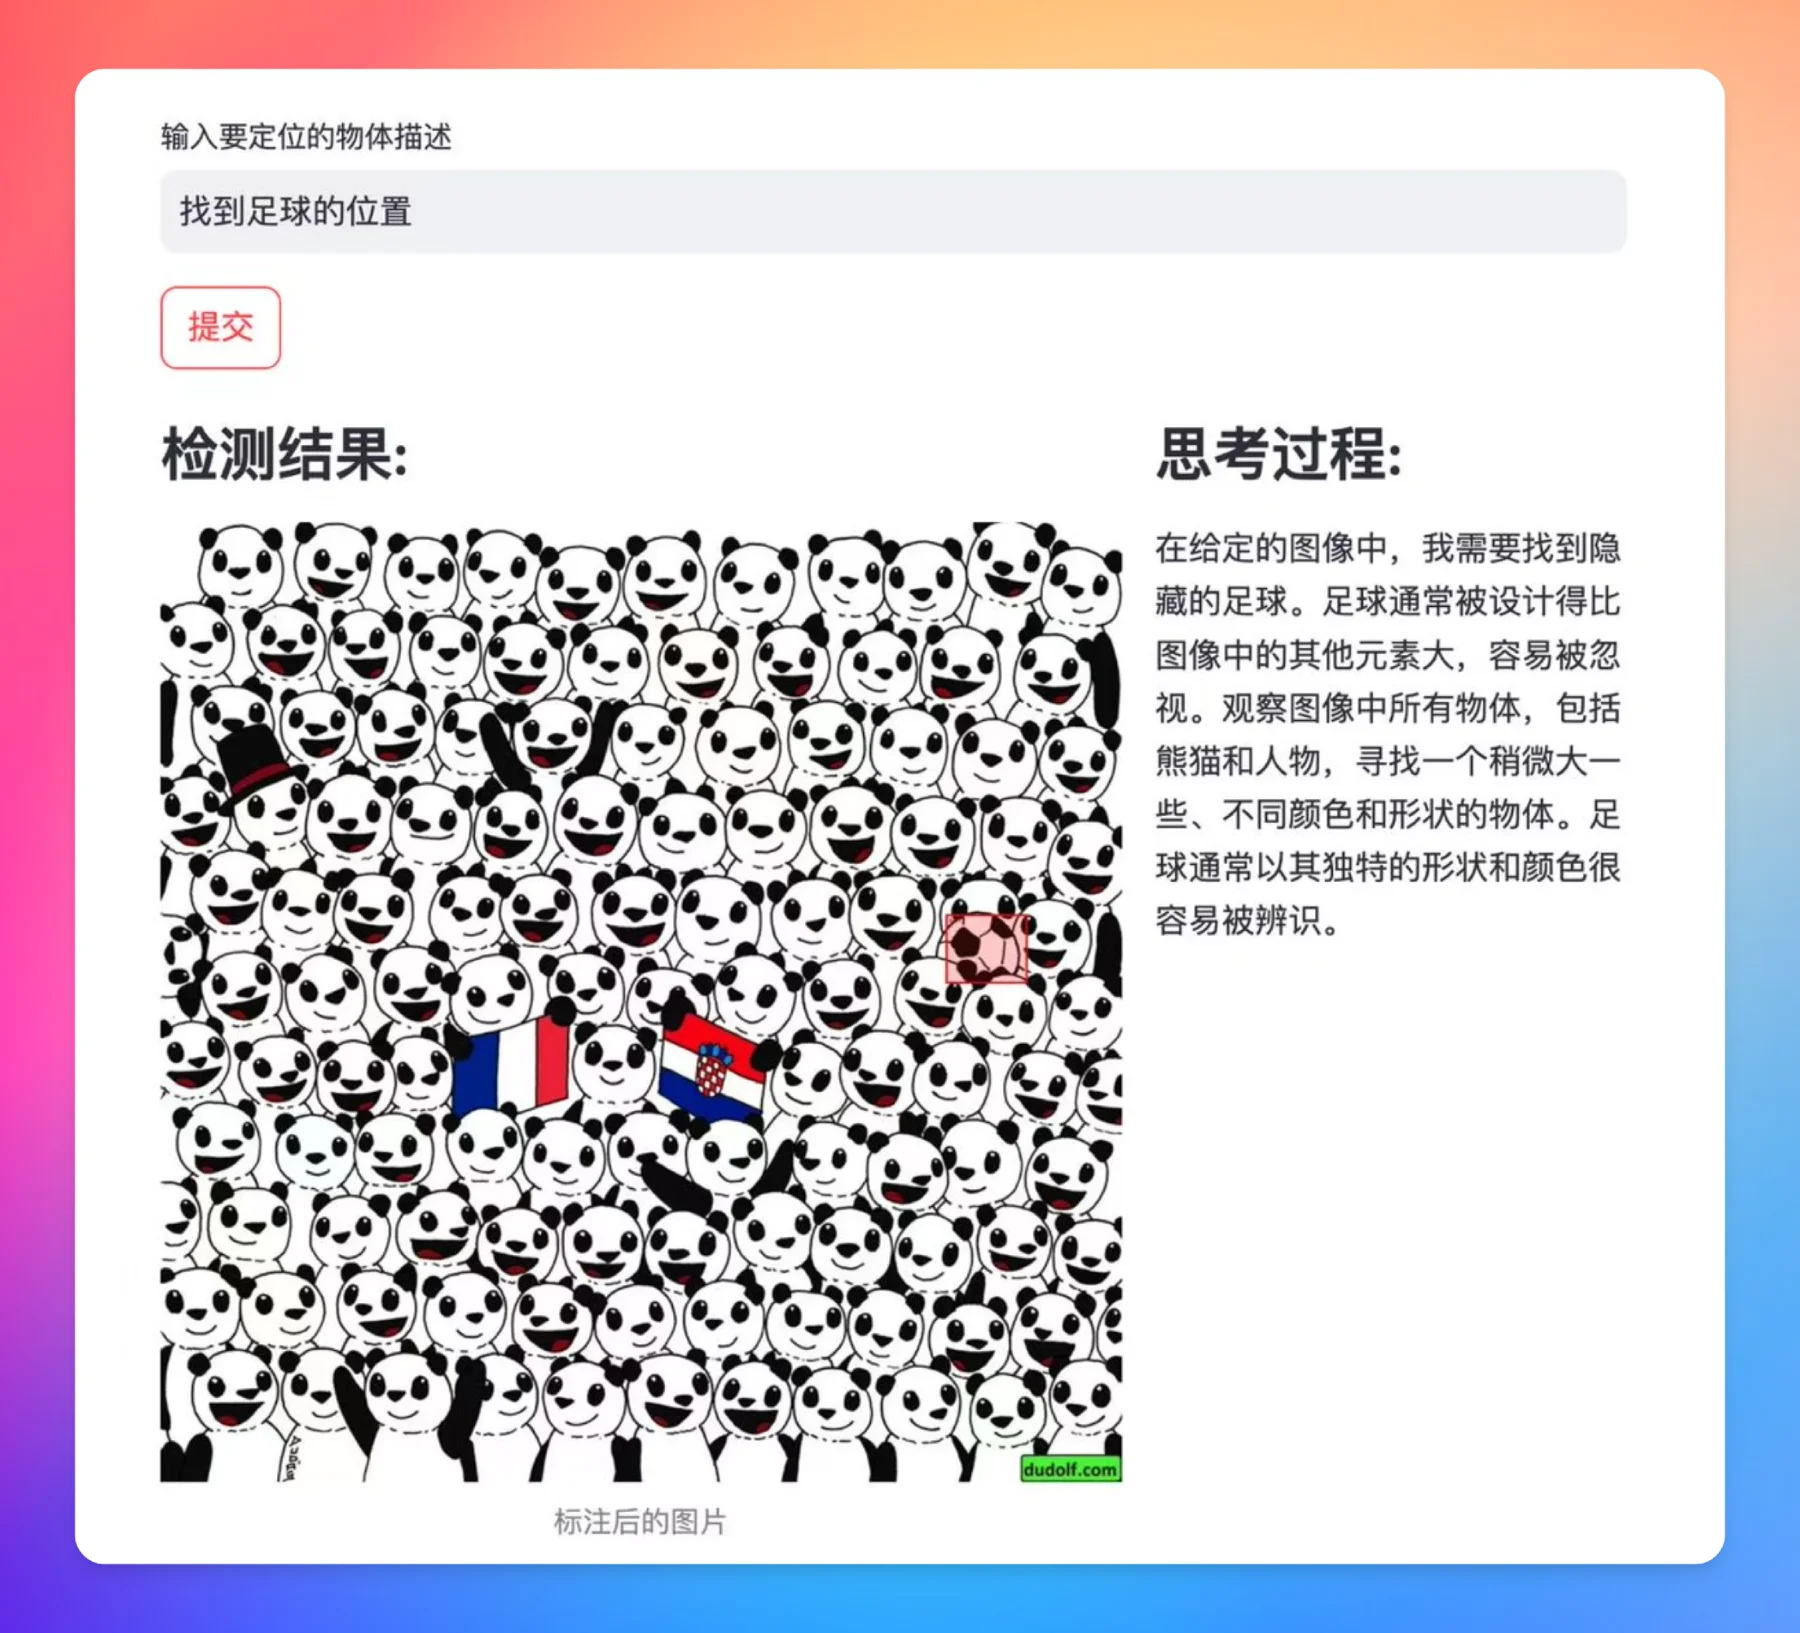
Technischer Hintergrund von VLM-R1:
VLM-R1 wurde durch die R1-Methode inspiriert, die das DeepSeek-Team im vergangenen Jahr als Open Source veröffentlicht hat. Diese Methode nutzt GRPO (Group Relative Policy Optimization), eine Technik des verstärkten Lernens, und erzielte bei reinen Text-Großmodellen beeindruckende Ergebnisse. Das VLM-R1-Team wandte diese Methode auf visuelle Sprachmodelle an und eröffnete damit erfolgreich neue Möglichkeiten im multimodalen Bereich.
Hauptmerkmale von VLM-R1:
Domänenübergreifende Robustheit: Auch in komplexen und sich ständig verändernden Anwendungsumgebungen hält VLM-R1 ein hohes Leistungsniveau aufrecht.
Hervorragende Generalisierungsfähigkeit: Anders als beim herkömmlichen überwachten Feintuning (SFT) verbessert sich die Leistung von VLM-R1 bei bisher unbekannten Aufgaben oder Datenverteilungen mit der Zeit kontinuierlich weiter und zeigt so eine starke Anpassungsfähigkeit und Flexibilität.
Hohe Benutzerfreundlichkeit: Der vollständige Trainings- und Evaluierungsprozess ermöglicht es den Nutzern, mit nur wenigen Schritten schnell einzusteigen und Experimente durchzuführen – ein großer Vorteil für Forscher und Ingenieure, die fortschrittliche KI-Technologien nutzen möchten.
Effiziente Ressourcennutzung: Durch dynamische Optimierungstechniken können Modelle mit großen Parametern (bis zu mehreren Milliarden) auf einer einzelnen GPU trainiert werden, wodurch die Hardwarekosten gesenkt und gleichzeitig die Effizienz gesteigert wird.
Technische Umsetzung von VLM-R1:
VLM-R1 baut auf Qwen2.5-VL auf und vergleicht die R1-Methode mit dem herkömmlichen SFT-Ansatz. Die Ergebnisse zeigen, dass das R1-Modell herkömmlichen SFT-Modellen in Bezug auf Stabilität, Generalisierungsfähigkeit und Tiefe des Verständnisses überlegen ist. Darüber hinaus demonstriert VLM-R1 anhand eines praktischen Beispiels seine Fachkompetenz in den Bereichen visuelle Erkennung, Wissensinferenz und Textausdruck.
Anwendungsszenarien von VLM-R1:
VLM-R1 zeigt in zahlreichen praktischen Anwendungen eine hervorragende Leistung. Beispielsweise in intelligenten Assistenten, autonomem Fahren und Virtual Reality – seine starke Verarbeitungsfähigkeit und Flexibilität machen es für den Einsatz in multimodalen Interaktionen äußerst vielseitig. In einem konkreten Demonstrationsbeispiel erkannte VLM-R1 anhand eines Fotos mit verschiedenen Zutaten zuverlässig das proteinreiche Lebensmittel – ein Omelett – und erklärte zusätzlich den Grund dafür. Darüber hinaus kann es die Position markierter Objekte im Bild präzise lokalisieren und zeigt damit seine herausragenden Fähigkeiten in Textgenerierung, logischem Denken und visueller Wahrnehmung.
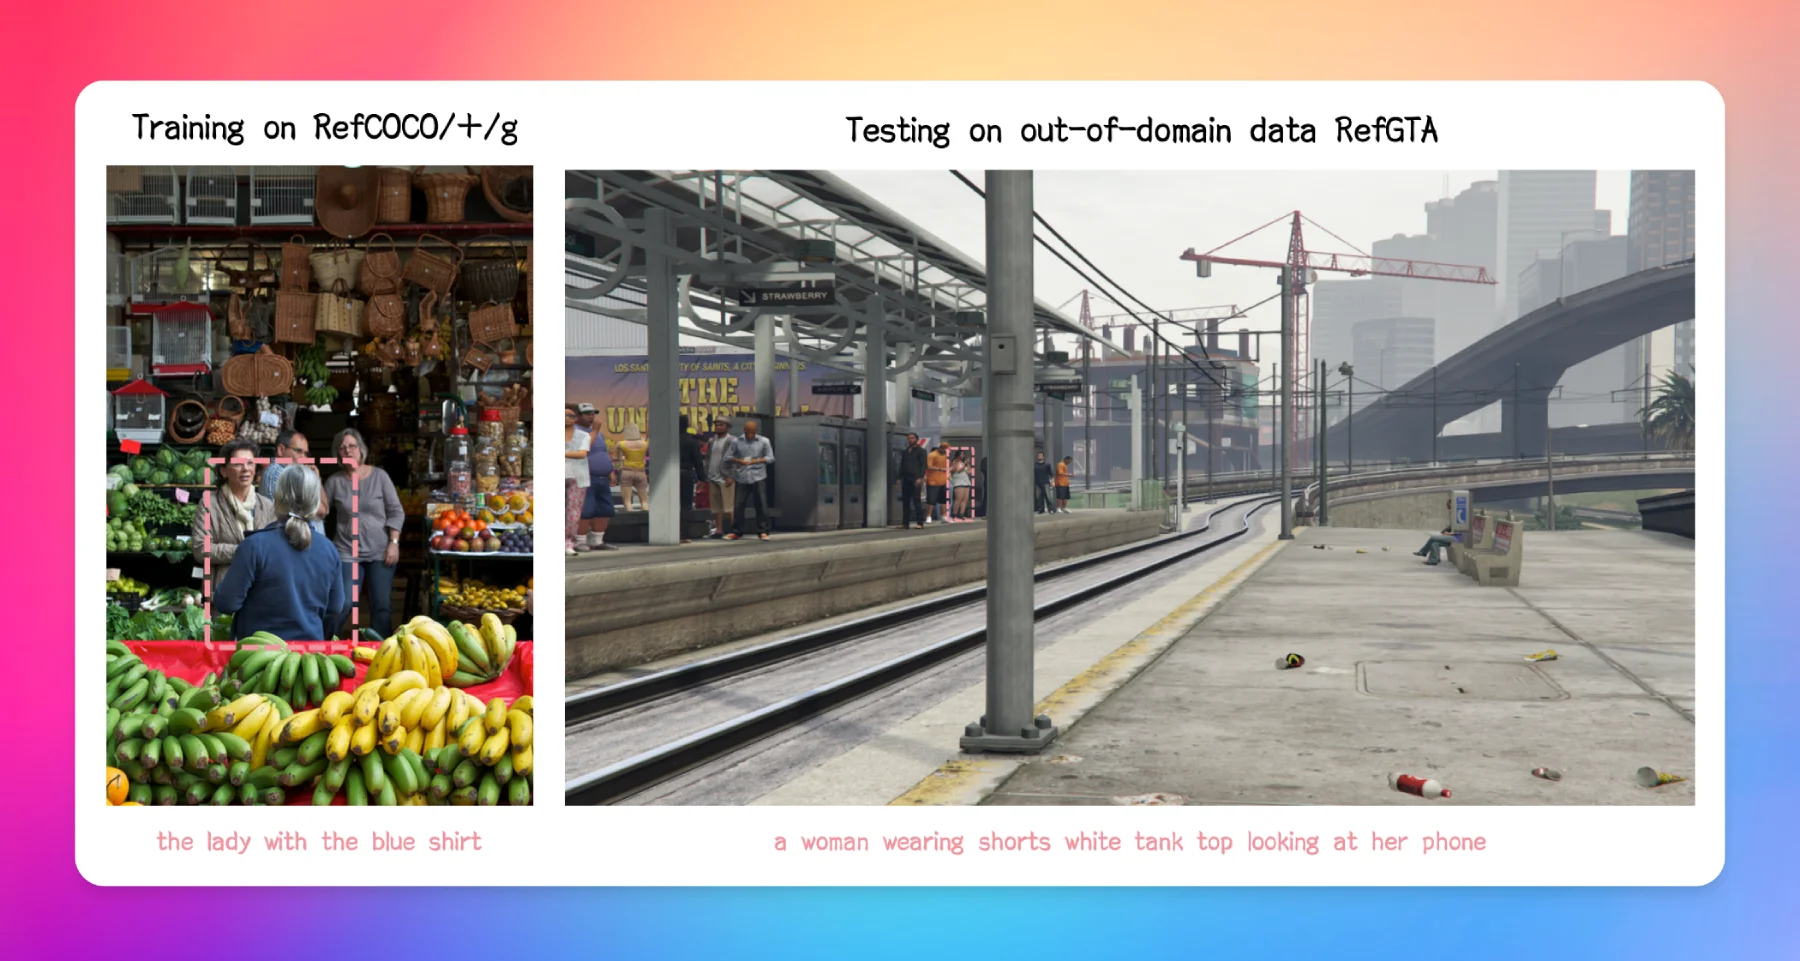
Zugehörige Links zu VLM-R1:
GitHub-Repository:https://github.com/om-ai-lab/VLM-R1
Demo:https://huggingface.co/spaces/omlab/VLM-R1-Referral-Expression









