
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Der ultimative LLM-Trainingsleitfaden: Training großer Sprachmodelle auf massiven GPU-Clustern (chinesische Ausgabe)
小编 ·

Der ultimative LLM-Trainingsleitfaden: Training großer Sprachmodelle auf massiven GPU-Clustern (chinesische Ausgabe)
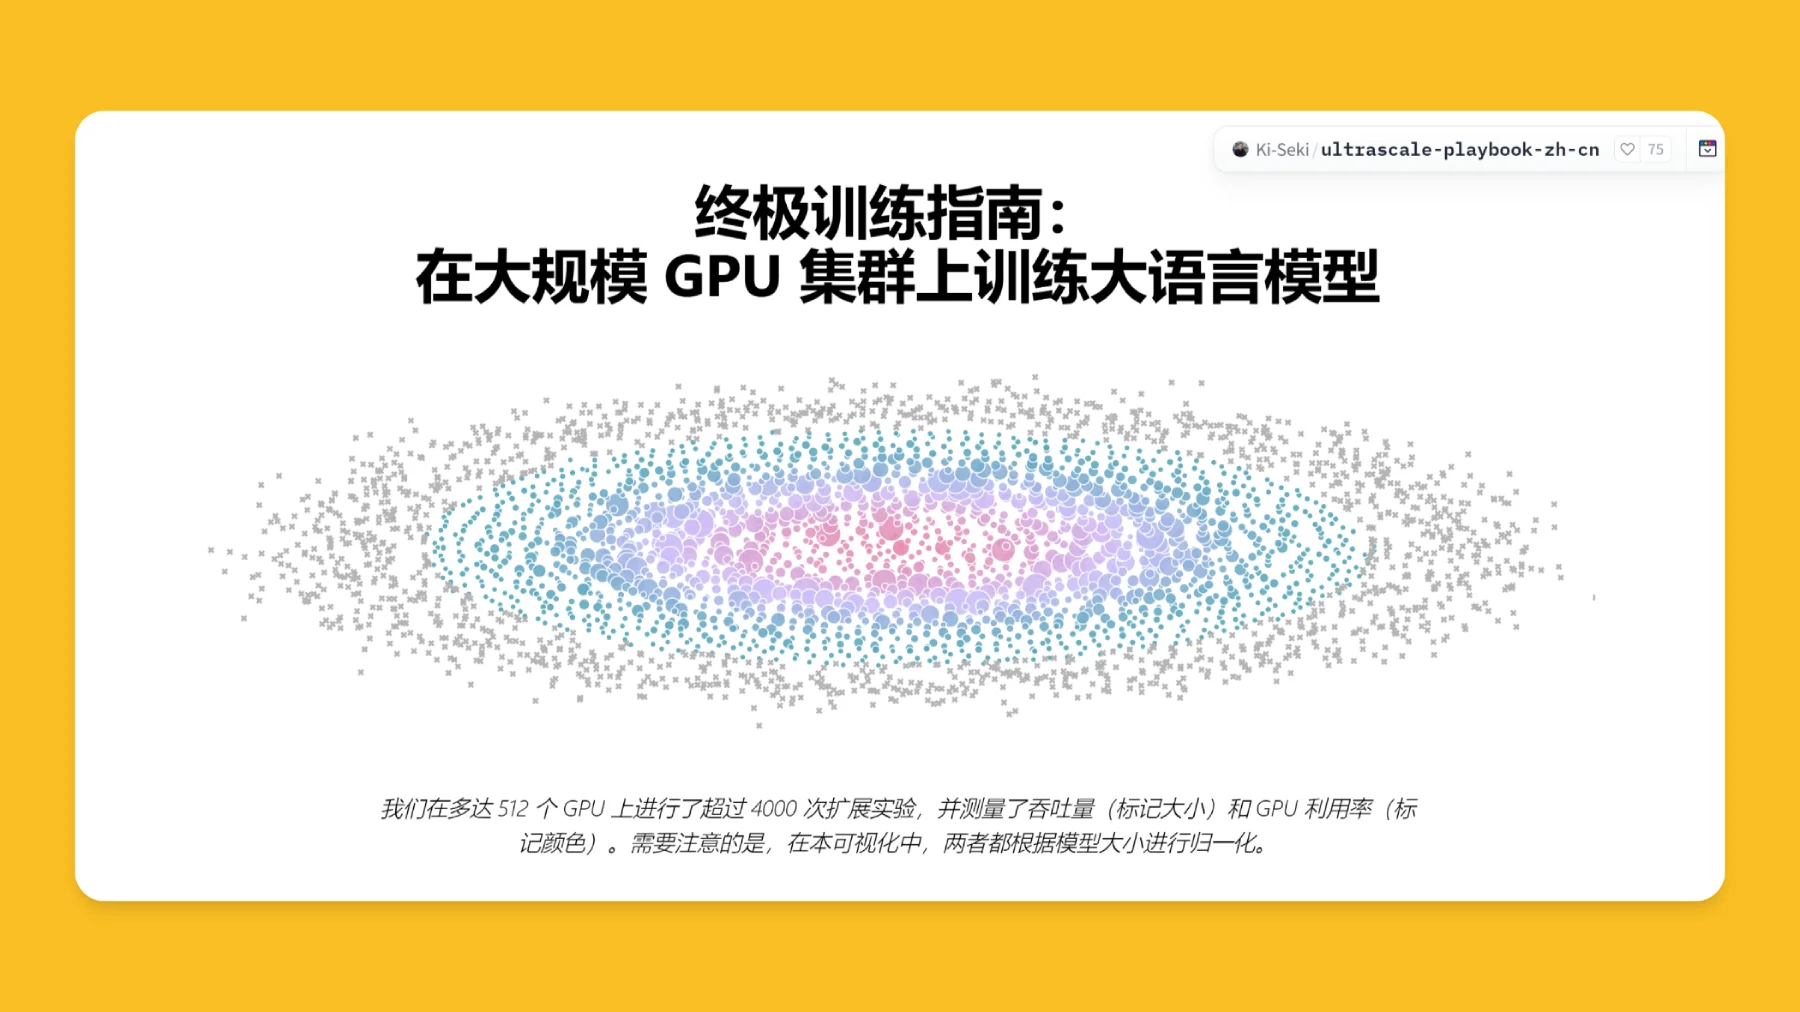
Hugging Face hat den Ultra - Scale Playbook veröffentlicht, einen Leitfaden, dessen chinesischer Name LLM终极训练指南 (Ultimativer Trainingsleitfaden für LLMs) lautet: Training von AI-Großsprachmodellen auf大规模GPU-Clustern. Er beginnt bei den Grundlagen und weist den Nutzern den Weg, das Training von Großsprachmodellen (LLMs) auf大规模GPU-Clustern zu skalieren. Dieser Leitfaden bietet umfassende Anleitungen für das Training auf Clustern mit 1 bis über 1000 GPUs und zeigt die Ergebnisse von Skalierungsexperimenten mit bis zu 512 GPUs, wobei Daten wie Durchsatz und GPU-Auslastung detailliert analysiert werden.
Originaltitel: The Ultra-Scale Playbook: Training LLMs on GPU Clusters
Übersetzungs-werkzeug: o1, o3-mini
Korrektor: @Ki_Seki_here
URL der chinesischen Version des LLM终极训练指南:https://huggingface.co/spaces/Ki-Seki/ultrascale-playbook-zh-cn
Wird noch korigiert...
Hintergrund der Studie
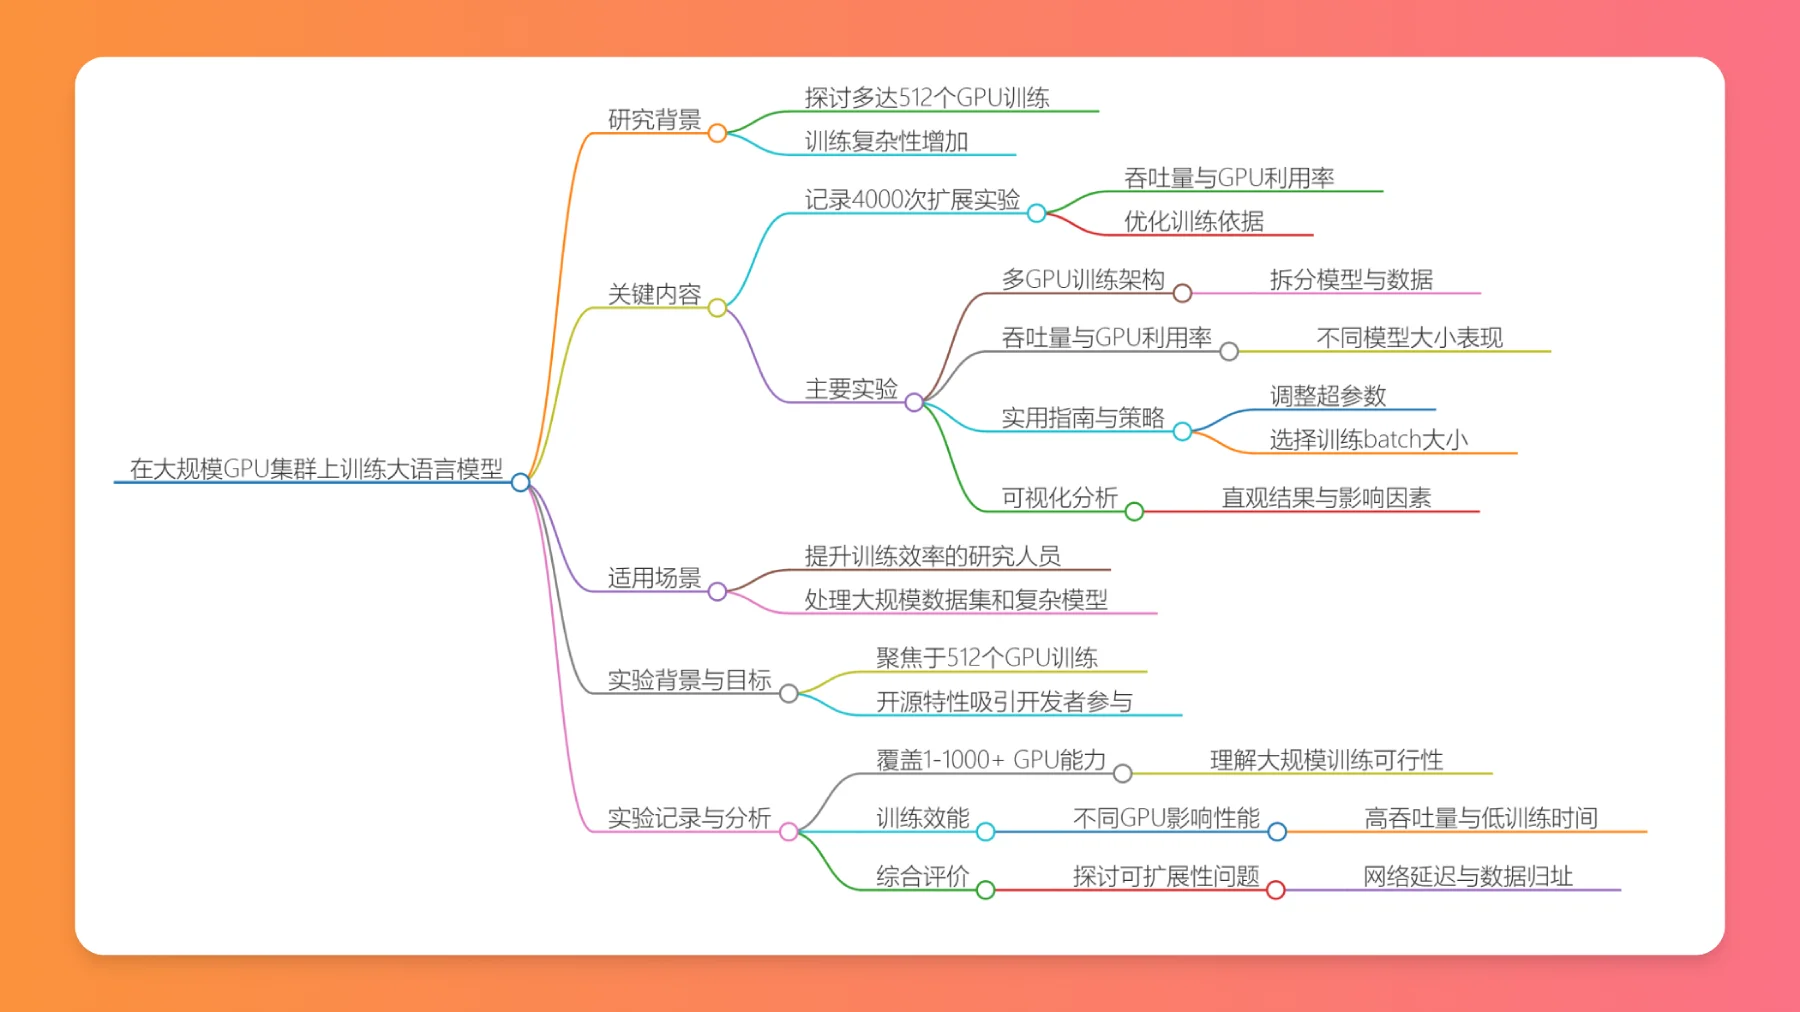
Da die Größe von Sprachmodellen ständig zunimmt, steigt auch der Bedarf an Rechenressourcen während des Trainings, und die Strategien werden immer komplexer. Daher konzentriert sich dieses Dokument darauf, wie man das Training von大规模Sprachmodellen (LLMs) auf Clustern mit bis zu 512 GPUs durchführt.
Schwerpunktinhalte
Umfangreiche experimentelle Aufzeichnungen
Im Dokument sind 4000 Skalierungsexperimente detailliert festgehalten. In diesen Experimenten sind Durchsatz (Token-Größe) und GPU-Auslastung (Token-Farbe) die zentralen Messgrößen. Diese Daten können eine zuverlässige Grundlage für die Optimierung des Trainingsprozesses bieten.
Hauptinhalt der Experimente
Multi-GPU-Trainingsarchitektur: Die verwendete Architektur kann Modelle und Daten effektiv aufteilen, sodass mehrere GPUs parallel zusammenhängende Aufgaben bearbeiten können, was die architektonische Grundlage für effizientes Training bildet.
Analyse von Durchsatz und GPU-Auslastung
Durch tatsächliche experimentelle Datenanalyse variiert die Leistung bei unterschiedlichen Modellgrößen. Eine solche Analyse hilft Entwicklern zu verstehen, wie sie die Ressourcen optimal nutzen können, um so die für sie geeignete Trainingsmethode zu finden.
Praktische Anleitungen und Strategien
Es werden praktische Trainingsstrategien zusammengefasst, etwa wie man Hyperparameter anpasst und die geeignete Trainings-Batch-Größe auswählt – all dies sind wichtige Faktoren, um optimale Leistung zu erzielen.
Visualisierungsanalyse
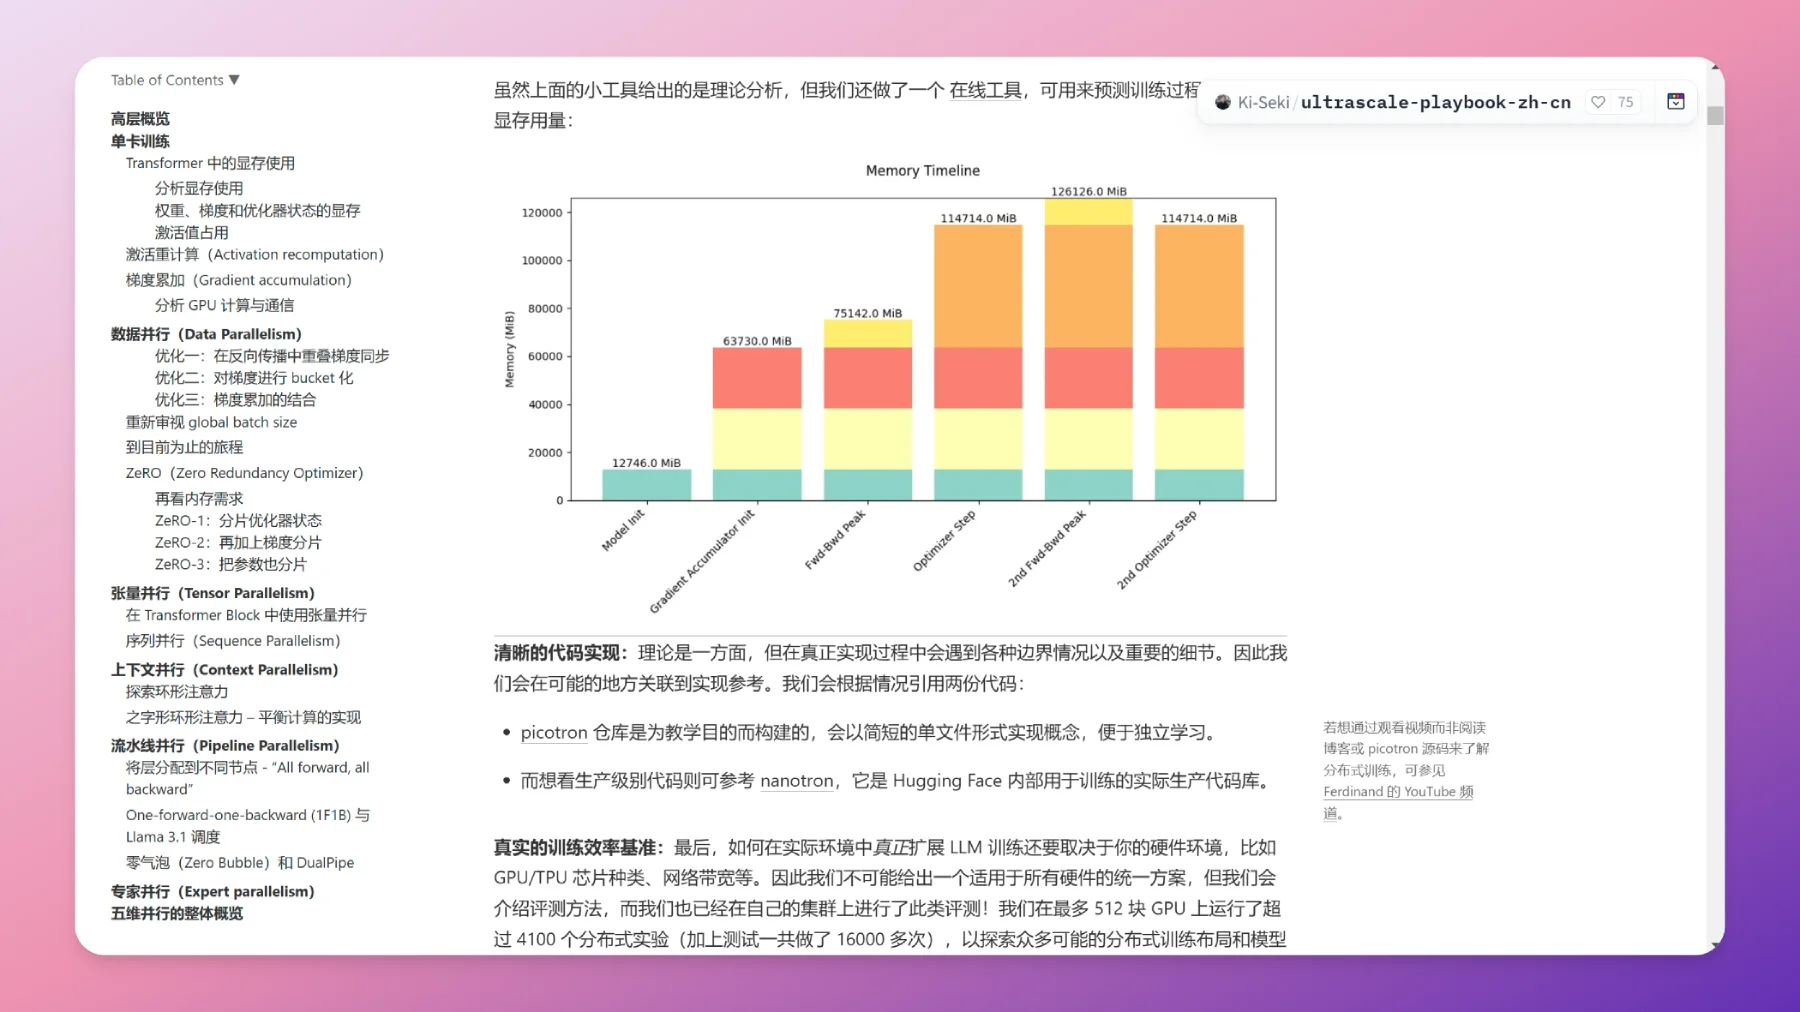
Das Dokument enthält zahlreiche Visualisierungsergebnisse. Diese ermöglichen es den Nutzern, die Ergebnisse der Skalierungsexperimente und die zugrunde liegenden Einflussfaktoren intuitiv zu erfassen, sodass komplexe Versuchsergebnisse leicht zu interpretieren sind.
Zielgruppe
Dieser Leitfaden ist besonders für Forscher und Ingenieure geeignet, die die Trainingseffizienz von Großsprachmodellen verbessern möchten, insbesondere wenn sie mit大规模Datenmengen und komplexen Modellen arbeiten.
Überlegungen zu den Experimenten
Merkmale und Ziele des Dokuments
Dieses Dokument behandelt nicht nur, wie man auf 512 GPUs trainiert, sondern hebt auch dessen Open-Source-Charakter hervor. Dadurch können mehr Entwickler teilhaben und diese Trainingsmethoden anwenden.
Umfang der experimentellen Aufzeichnungen
Der Umfang der experimentellen Aufzeichnungen reicht von 1 GPU bis hin zu Skalierungsfähigkeiten mit über 1000 GPUs. Dies bildet einen umfassenden Rahmen, der hilft zu verstehen, ob und wie effizient das Training von LLMs auf大规模Clustern möglich ist.
Analyse der Trainingseffizienz
Bei der Untersuchung, wie sich unterschiedliche GPU-Anzahlen auf die Trainingsleistung auswirken, stellten die Autoren fest, dass einige Modelle während der Skalierung einen höheren Durchsatz und kürzere Trainingszeiten erreichen können. Diese Erkenntnis kann Entwicklern gezieltere Empfehlungen bei der Wahl der GPU-Anzahl und -Konfiguration geben.
Umfassende Berücksichtigung
Über die Betrachtung von Leistungsmetriken hinaus werden in diesem Experiment auch Skalierbarkeitsfragen in realen Anwendungen intensiv erörtert. Ebenso werden einige Herausforderungen untersucht, die in realen Umgebungen auftreten können, wie Netzwerklatenz, Datenlokalisierung und andere komplexe Faktoren – Aspekte, die bei der Durchführung von大规模Trainings nicht vernachlässigt werden dürfen.









