
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
OSUM: Open-Source-Sprachmodell der Northwestern Polytechnical University für vielfältige Sprachverarbeitungsaufgaben
小编 ·

OSUM: Open-Source-Sprachmodell der Northwestern Polytechnical University für vielfältige Sprachverarbeitungsaufgaben
OSUM (Open Speech Understanding Model) ist ein Sprachmodell, das von der Forschungsgruppe für Audio-, Sprach- und Sprachverarbeitung (ASLP@NPU) des Instituts für Informatik und Technologie der Northwestern Polytechnical University entwickelt und als Open Source veröffentlicht wurde. Es dient der Unterstützung verschiedener Sprachverarbeitungsaufgaben.
Funktionsmerkmale von OSUM:
Multitasking-Unterstützung:
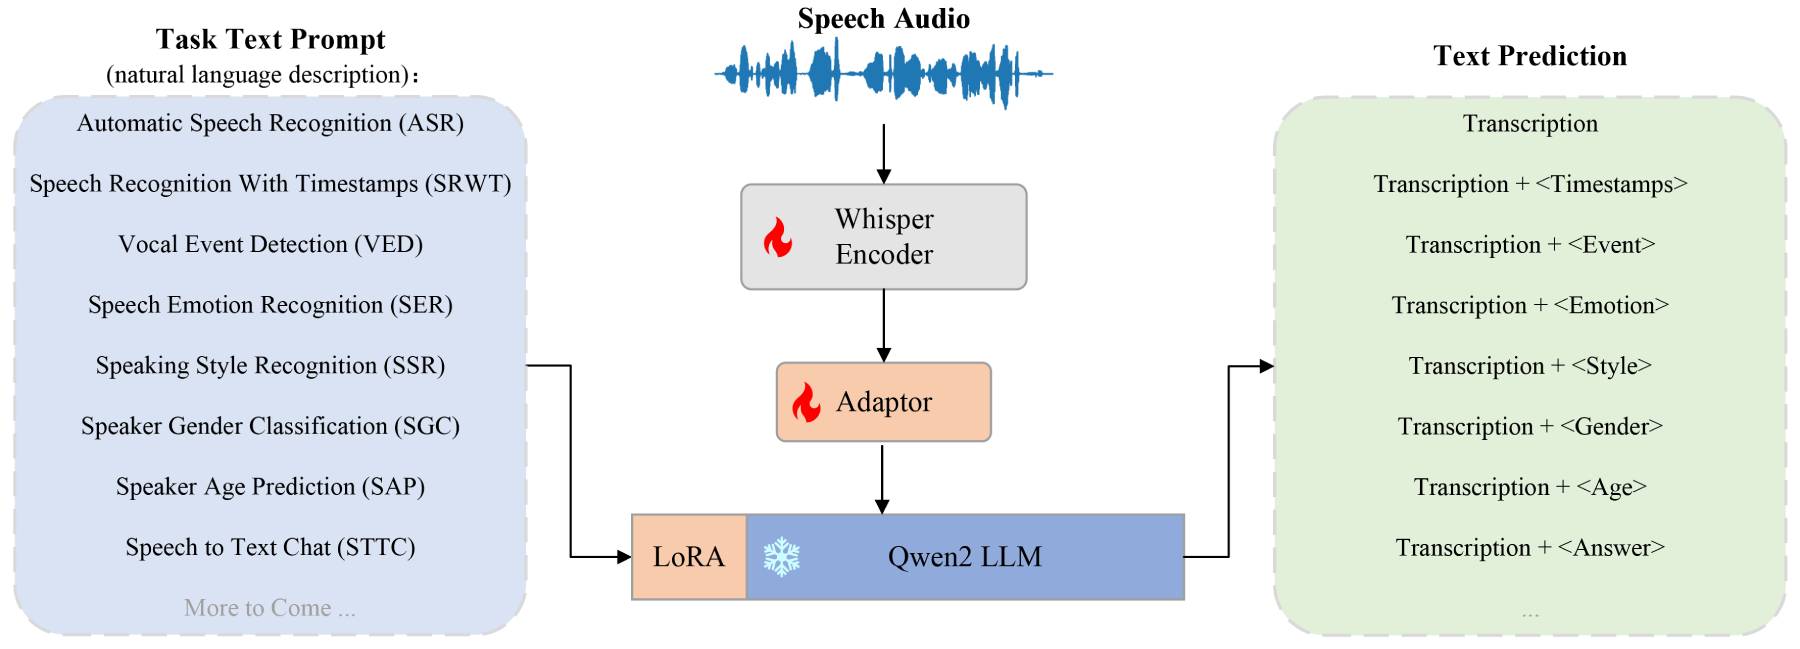
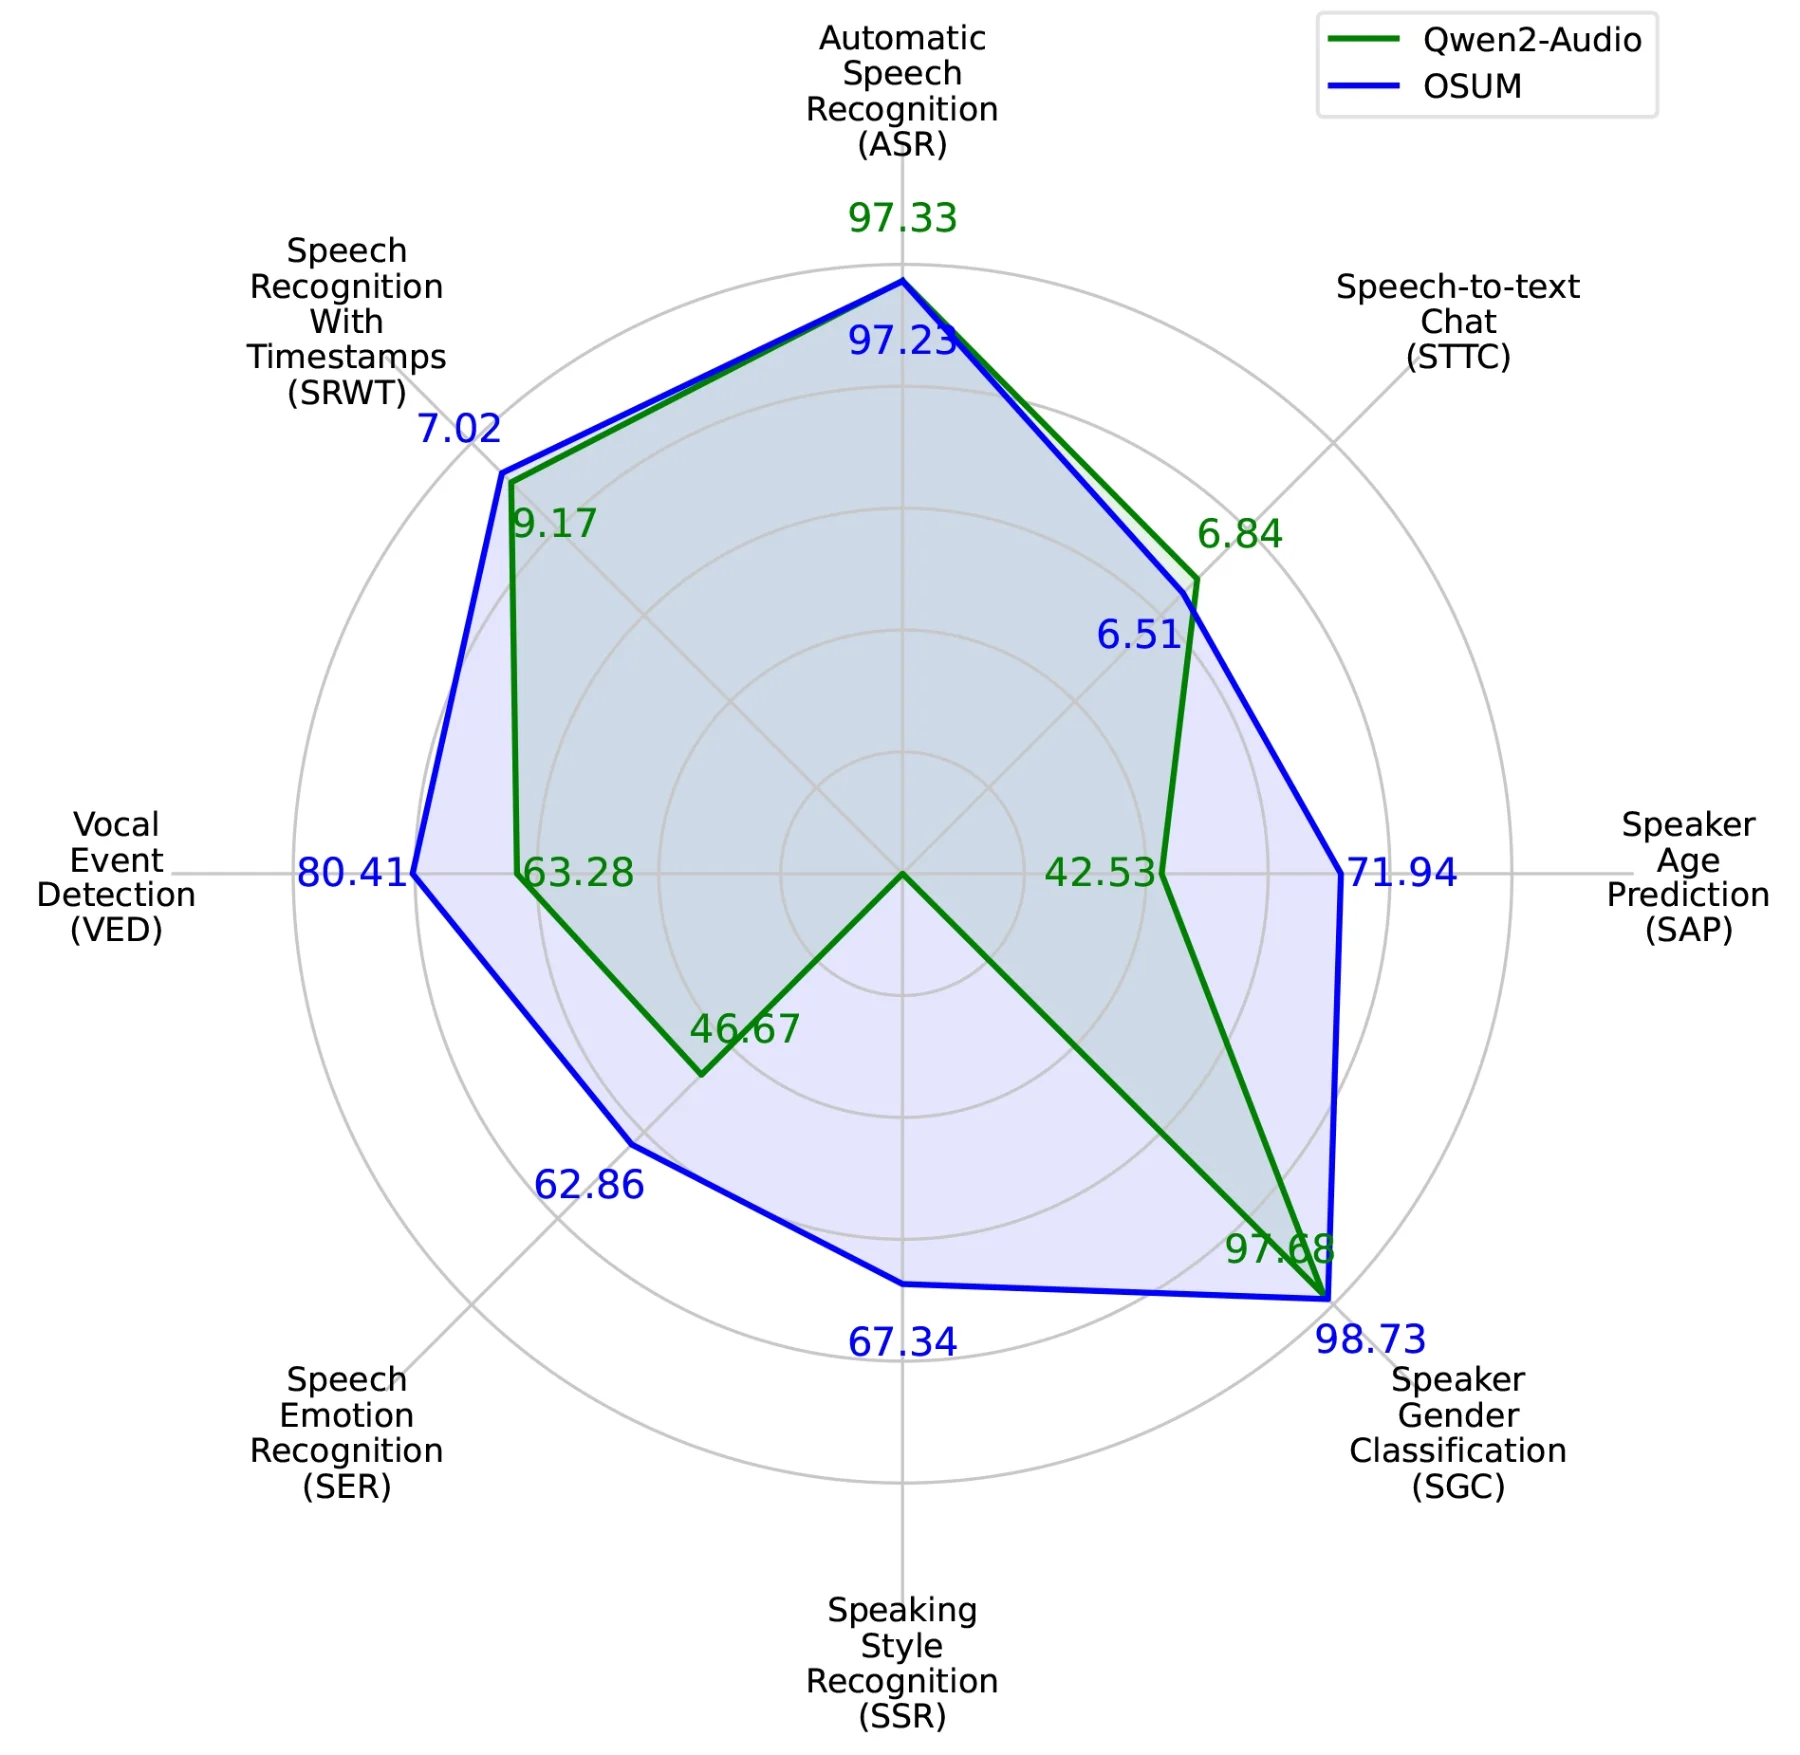
Automatische Spracherkennung (ASR): Umwandlung von Sprache in Text.
Spracherkennung mit Zeitstempeln (SRWT): Erkennung von Sprachinhalten mit Zeitinformationen.
Sprachereigniserkennung (VED): Erkennung bestimmter Ereignisse oder Aktionen in der Sprache.
Sprachemotionserkennung (SER): Analyse des emotionalen Zustands in der Sprache.
Sprechstilerkennung (SSR): Erkennung der Sprechweise oder des Tons des Sprechers.
Sprechergeschlechtsklassifikation (SGC): Bestimmung des Geschlechts des Sprechers anhand der Stimme.
Sprecheraltersvorhersage (SAP): Schätzung des Alters des Sprechers.
Sprache-zu-Text-Chat (STTC): Umwandlung von Sprachdialogen in lesbaren Text.
Modellarchitektur: OSUM kombiniert den Whisper-Encoder mit dem Qwen2-Sprachmodell (LLM) und nutzt die LoRA-Technik zur Feinabstimmung des LLM, um ein effizientes Multitasking-Training zu ermöglichen.
Trainingsstrategie: Es wird die ASR+X-Trainingsstrategie verwendet, bei der automatische Spracherkennung (ASR) und Nebentasks (X) gleichzeitig optimiert werden. Dies ermöglicht ein effizientes und stabiles Multitasking-Training und reduziert den Ressourcenverbrauch.
Tiefes Verständnis: Das OSUM-Modell kann Sprachinformationen in Text umwandeln und unterstützt gleichzeitig die Emotionserkennung in der Sprache, um den Benutzern ein intelligenteres interaktives Erlebnis zu bieten.
Zeitstempel-Unterstützung: Bei der Spracherkennung bietet OSUM Ausgaben mit Zeitstempeln, was die weitere Verarbeitung und Analyse erleichtert.
Plattformübergreifende Kompatibilität: Es unterstützt den Betrieb auf verschiedenen Rechenplattformen, einschließlich Huawei Ascend 910B und Nvidia-Plattformen, was die Flexibilität der Anwendung erhöht.
Anwendungen von OSUM:
Intelligente Assistenten: In Smart Homes und virtuellen Assistenten verwendet, um Sprachbefehle der Benutzer zu verstehen und darauf zu reagieren.
Mehrsprachige Dienste: Ähnlich wie das YouTube-Dubbing-Plugin kann es für Echtzeit-Übersetzung und Synchronisation eingesetzt werden, um Sprachbarrieren zu überwinden.
Emotionsanalyse: Analyse der Benutzerstimmung in Kundenservice- und Mental-Health-Anwendungen, um personalisierte Dienste anzubieten.
Bildungsbereich: Automatische Bewertung von mündlichen Aufgaben der Schüler mit entsprechendem Feedback.
Barrierefreiheitstechnologie: Unterstützung für hörgeschädigte Personen beim Verstehen von Sprachinformationen.
Marktforschung: Analyse von Emotionen und Meinungen in Verbraucherfeedback.
Sprachtranskription: Effiziente Sprachtranskription mit OSUM in Szenarien wie Besprechungsaufzeichnungen und Diktatkonvertierung.
Verwendung von OSUM:
Installation und Import: Benutzer können den Code und die Modellgewichte von OSUM über die Hugging Face-Seite oder die GitHub-Projektseite herunterladen und die bereitgestellte Installationsanleitung befolgen. Ein Beispielcode zum Importieren des OSUM-Modells in eine Python-Umgebung ist wie folgt:
from osum import OSUM
model = OSUM.from_pretrained("ASLP-lab/OSUM")
Aufgaben ausführen: Benutzer können das OSUM-Modell für verschiedene Sprachaufgaben verwenden, z. B. Spracherkennung. Der folgende Beispielcode zeigt eine Spracherkennungsaufgabe:
result = model.transcribe("audio.wav")
print(f"识别结果:{result}")
Bei der Verwendung können Benutzer auch vortrainierte Modell-Checkpoints für eine Feinabstimmung nutzen, um die Leistung des Modells bei bestimmten Aufgaben weiter zu verbessern.
GitHub: https://github.com/ASLP-lab/OSUM
项止:https://aslp-lab.github.io/OSUM.github.io/









