
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
VideoWorld: Komplexe Aufgaben allein durch Sehen, ohne Sprachmodelle
小编 ·

VideoWorld: Komplexe Aufgaben allein durch Sehen, ohne Sprachmodelle
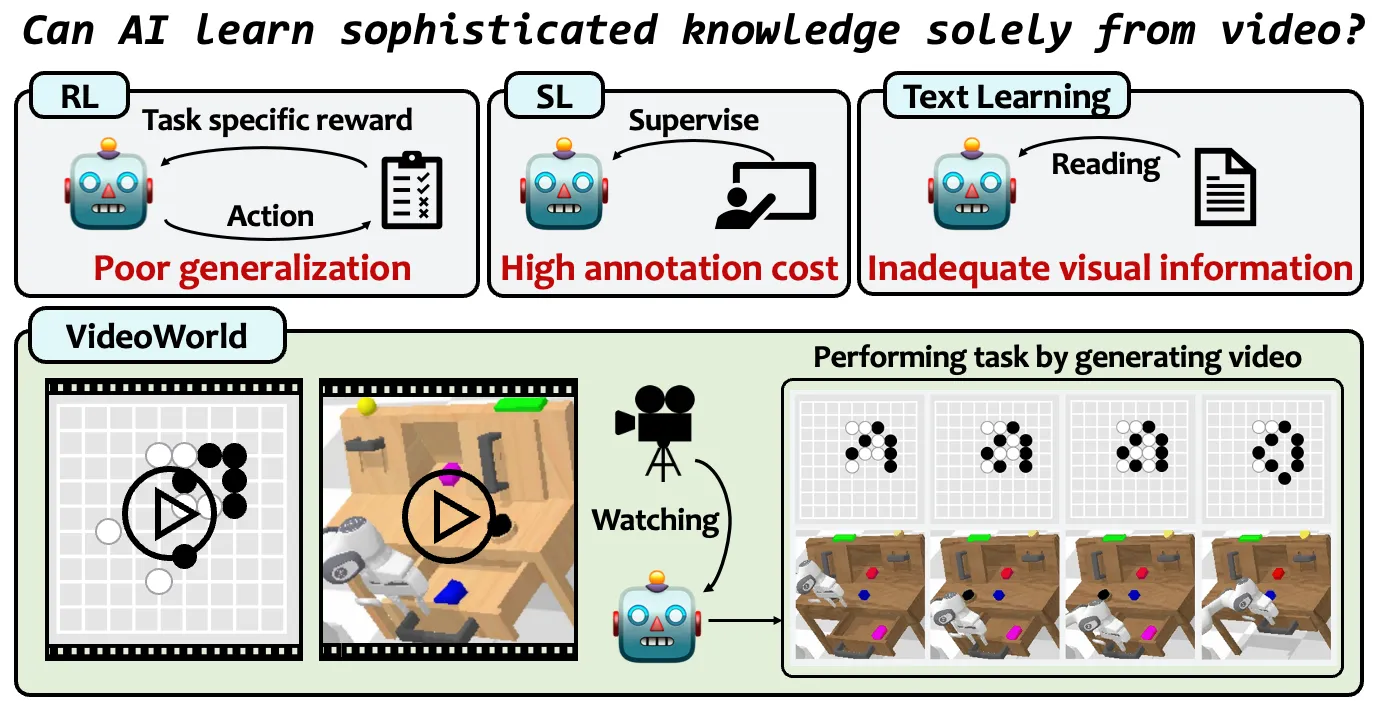
Am 10. Februar 2025 wurde das Videogenerierungsmodell „VideoWorld“ vom Doubao-Großmodell-Team in Zusammenarbeit mit der Beijing Jiaotong University und der University of Science and Technology of China gemeinsam entwickelt und offiziell als Open-Source veröffentlicht. Die zentrale Innovation des VideoWorld-Modells besteht darin, dass es keinerlei Sprachmodelle benötigt und komplexe Aufgaben ausschließlich durch visuelle Informationen erlernen und generieren kann.
1. Kernfunktionen und Merkmale
1. Reines visuelles Wissenslernen
Erlernt komplexe Regeln und Strategien eigenständig aus unannotierten Videodaten (z. B. Go-Spiellogik, Roboter-Operationssequenzen), ohne Sprachanweisungen oder Belohnungsmechanismen des bestärkenden Lernens
Unterstützt mehrstufiges Schließen und langfristige Planung, beispielsweise das Vorhersehen der nächsten 5–9 Züge des Gegners beim Go-Spiel
2. Effiziente Kompression visueller Repräsentationen
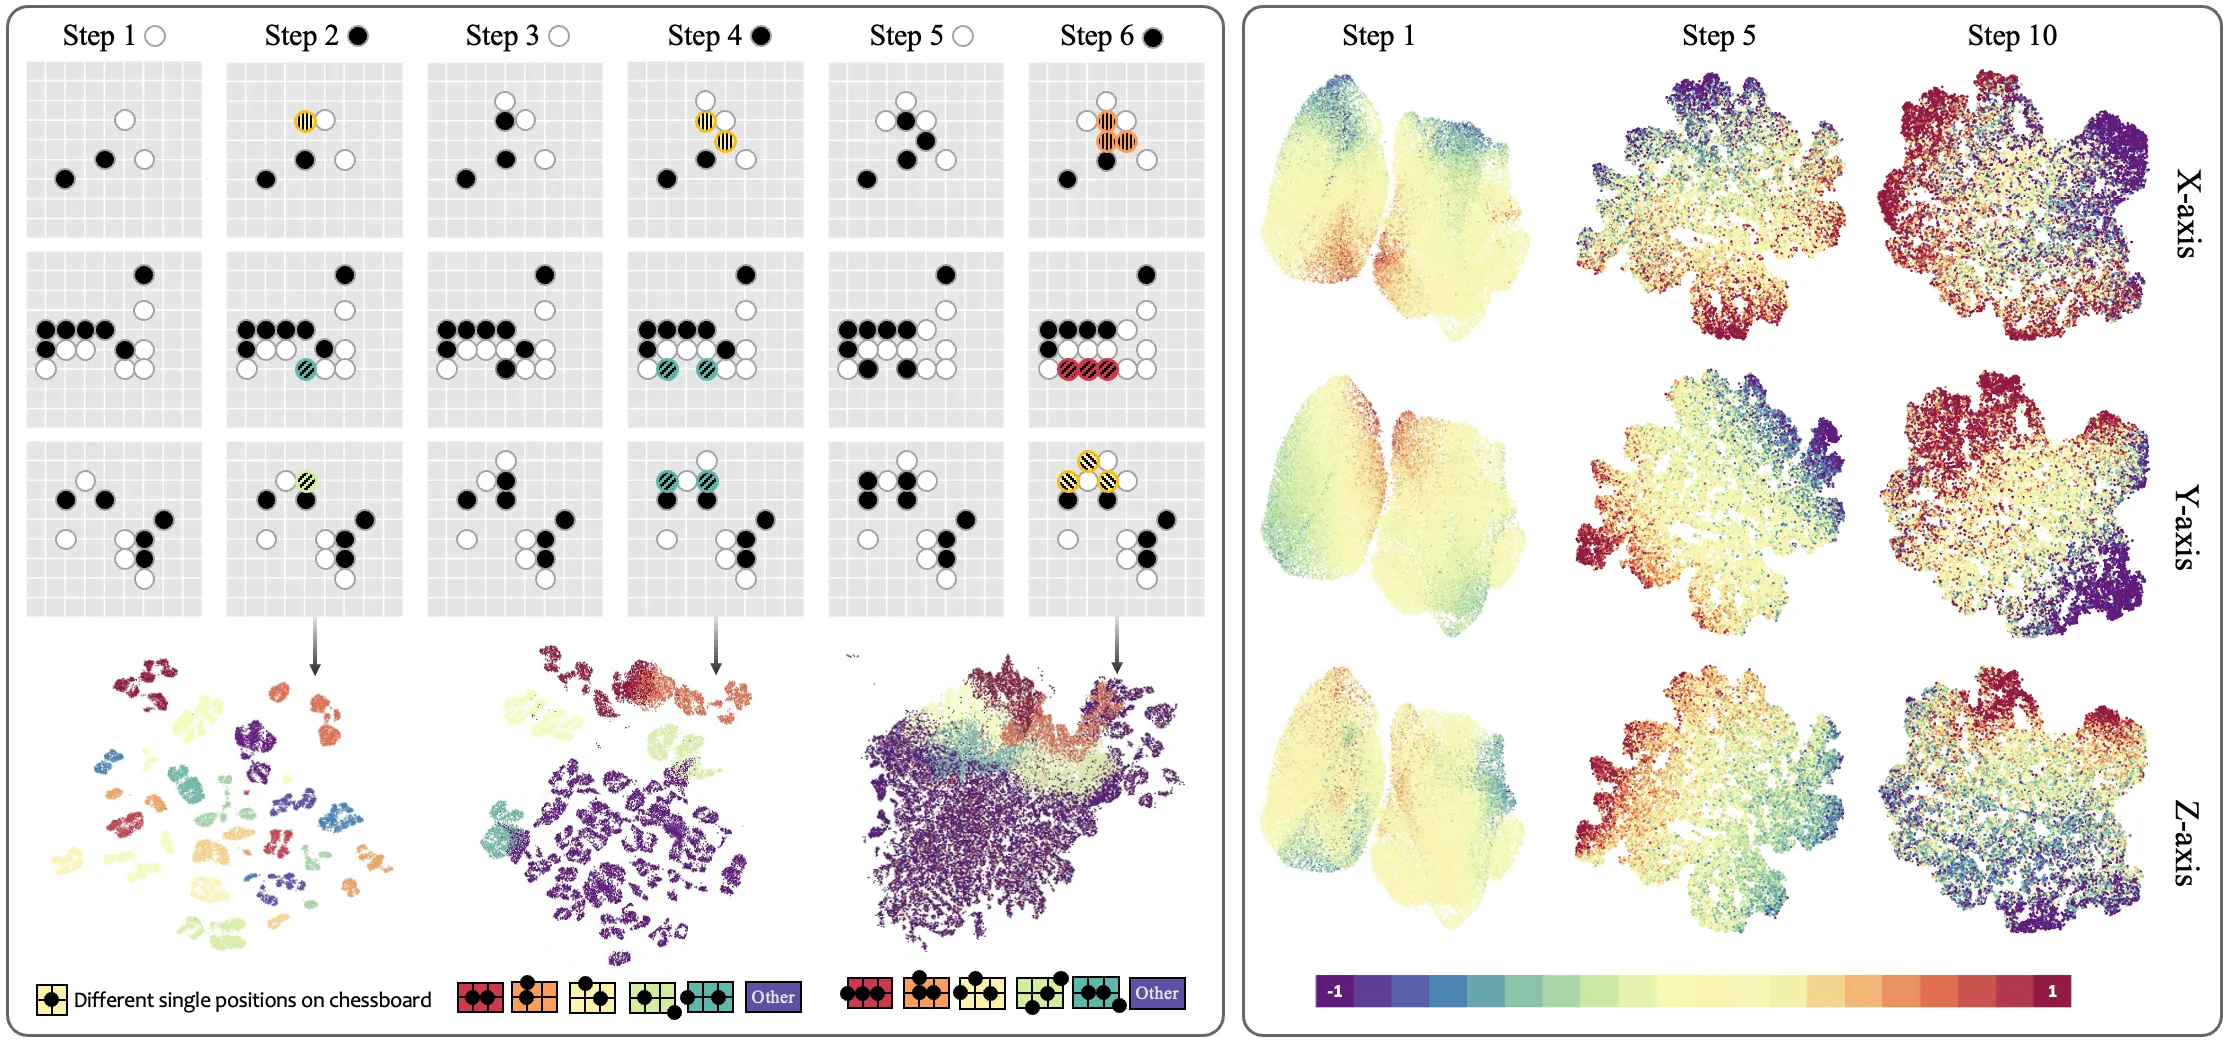
Führt ein Latent Dynamics Model (LDM) ein, das Veränderungen zwischen Videoframes in kompakte latente Sequenzen kodiert und so redundante Informationen reduziert
Ermöglicht die gemeinsame Modellierung kurz- und langfristiger dynamischer Abhängigkeiten – kurzfristig werden feine Verschiebungen (z. B. Feinabstimmung eines Roboterarms) erfasst, langfristig werden aufgabenbezogene Muster (z. B. taktische Kombinationen beim Go) modelliert
3. Fähigkeit zur domänenübergreifenden Generalisierung
Erreicht auf den Robotertestsätzen CALVIN und RLBench eine Leistung nahe am Oracle-Modell und kann sich an unterschiedliche Umgebungsparameter (wie Beleuchtung, Objektposition) anpassen
Erreicht beim Go-Spiel das Niveau eines Berufsspielers der 5. Dan-Stufe (Video-GoBench-Benchmark) und übertrifft damit herkömmliche bestärkende Lernagenten.
2. Technische Architektur von VideoWorld:
Basisarchitektur
Basierend auf VQ-VAE werden Videoframes in Token-Sequenzen diskretisiert; ein autoregressiver Transformer realisiert die Vorhersage auf Frame-Ebene
Die Trainingsdaten enthalten ausschließlich Videos von Aufgabenausführungen (z. B. Verlauf von Go-Partien, Aufzeichnungen von Roboterarm-Operationen)
Latent Dynamics Model (LDM)
Kodierungsmechanismus: Komprimiert die visuellen Veränderungen der nächsten H-Frames in kontinuierliche latente Codes, die nach der Quantisierung als Vorhersageziel dienen
Doppelstrom-Vorhersage: Optimiert gemeinsam die Generierung von Videoframes und die Vorhersage latenter Codes, um die Modellierung kritischer Entscheidungsknoten zu verbessern
Interpretierbare Analyse: UMAP-Visualisierungen zeigen, dass das Clustering im latenten Raum stark mit der Aufgabendynamik korreliert.
Effizienzoptimiertes Design
Die Modellparameteranzahl ist auf etwa 300 Millionen begrenzt, was den Rechenaufwand im Vergleich zu herkömmlichen Videomodellen um 80 % reduziert
Trainingsdatenumfang: Video-GoBench enthält zehntausende Go-Partien-Videoframes
3. Anwendungsszenarien von VideoWorld
Inhaltserstellung: Bietet leistungsstarke Unterstützung für die Erstellung von Kurzfilmen, die Konzeption von Filmszenen und die Generierung visueller Inhalte in Spielen.
Bildung: Hilft Schülern durch die Erstellung dynamischer Videos, komplexes Wissen anschaulicher zu verstehen.
Werbung: Generiert individuelle Werbevideos basierend auf den Nutzerpräferenzen und steigert so die Marketingeffektivität.
4. Download und Installation von VideoWorld:
1. Repository klonen:
git clone https://github.com/bytedance/VideoWorld.git
cd VideoWorld
2. Abhängigkeiten installieren:
pip install -r requirements.txt
3. Beispiele ausführen: Der Beispielcode befindet sich normalerweise im examples- oder scripts-Verzeichnis. Passen Sie die Konfigurationsdatei nach Bedarf an und führen Sie das entsprechende Skript aus.
5. VideoWorld Projektseite:
Projekt-Hauptseite: https://maverickren.github.io/VideoWorld.github.io
GitHub-Adresse: https://github.com/bytedance/VideoWorld
Paper-Link: https://arxiv.org/abs/2501.09781









