
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
MILS: Metas trainingsfreie Methode, die LLMs multimodale Fähigkeiten verleiht
小编 ·

MILS: Metas trainingsfreie Methode, die LLMs multimodale Fähigkeiten verleiht
MILS (Meta Interpretive Learning System) ist ein von Meta veröffentlichtes Open-Source-KI-Modell, das LLMs ohne Training multimodale Fähigkeiten verleiht. Im Gegensatz zu herkömmlichen Trainingsmethoden zielt MILS darauf ab, großen Sprachmodellen (LLMs) die Fähigkeit zu geben, visuelle und auditive Aufgaben zu verarbeiten, ohne zusätzliches aufgabenspezifisches Training. Es kann Bilder und Videos erkennen, Töne verstehen und Zero-Shot-Lernen durchführen.
MILS kombiniert die Vorteile von Deep Learning und interpretativem Lernen und kann in einer Vielzahl von Aufgaben hervorragende Leistungen erbringen, insbesondere in komplexen Szenarien, die Verständnis und Schlussfolgerung erfordern.
MILS besteht hauptsächlich aus zwei Modulen: einem Generator, der für die Erstellung von Kandidatenlösungen zuständig ist, und einem Bewerter, der die Qualität der vom Generator erstellten Kandidatenlösungen bewertet. Durch einen iterativen Prozess werden multimodale Aufgaben ohne zusätzliches Training gelöst.
Zu den Merkmalen von MILS gehören die Unterstützung mehrerer Sprachen und multimodaler Eingaben sowie die Fähigkeit, Text-, Bild- und Audiodaten zu verarbeiten. MILS kann für verschiedene multimodale Aufgaben eingesetzt werden, wie Bild-/Video-/Audio-Beschreibung, Bildgenerierungsverbesserung, Stiltransfer usw.
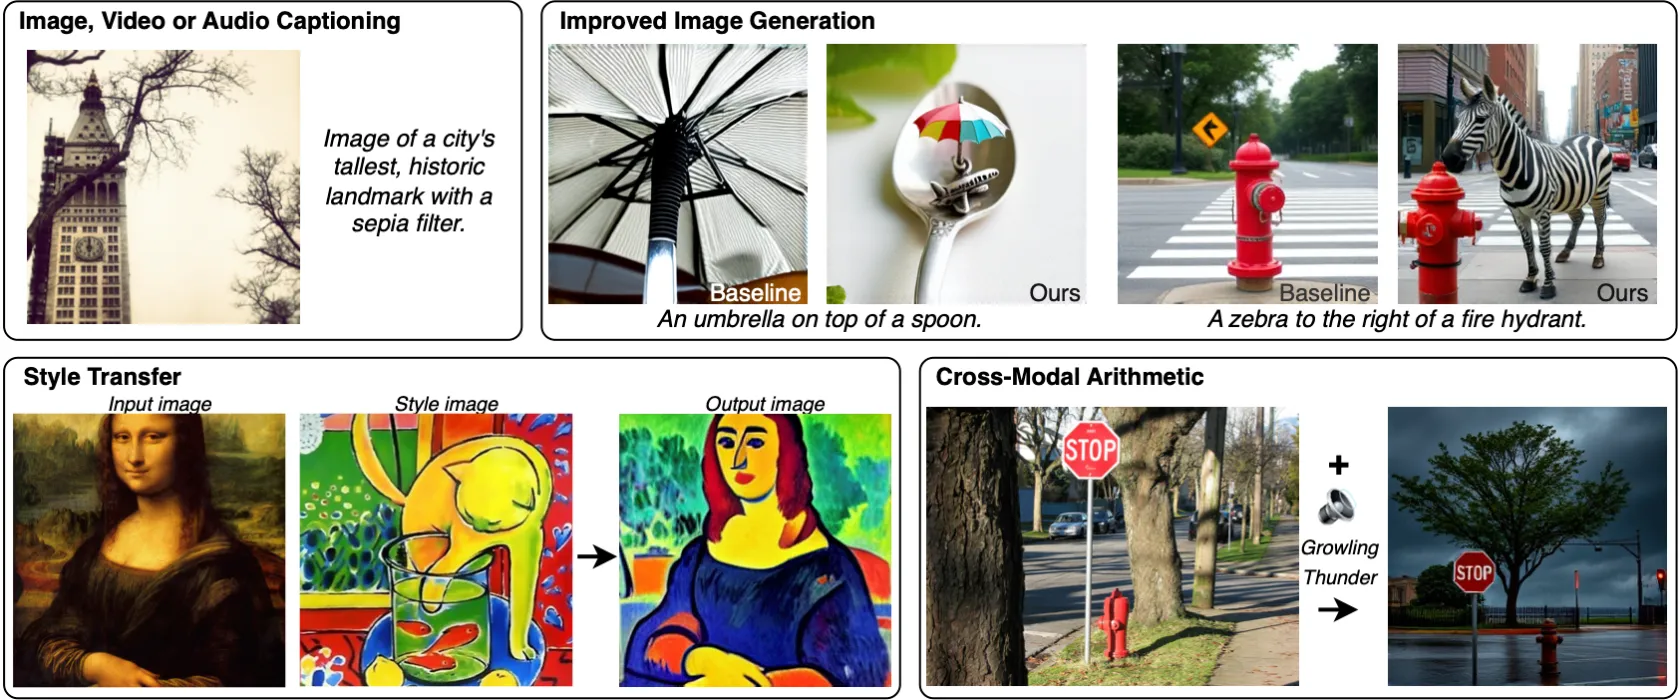
Schlüsselmerkmale und Arbeitsprinzipien von MILS
Zero-Shot-Generierung: Der Kern von MILS liegt in seiner Zero-Shot-Lernfähigkeit, was bedeutet, dass das Modell multimodale Probleme lösen kann, ohne direkt auf eine bestimmte modale Aufgabe trainiert worden zu sein. Durch einen iterativen Feedback-Mechanismus werden die erzeugten Ausgaben schrittweise verbessert, um hochwertige multimodale Beschreibungen oder Generierungen zu erreichen.
Iterative Feedback-Schleife: Während des Generierungsprozesses lässt MILS zunächst das Sprachmodell basierend auf einer Textaufforderung eine erste multimodale Ausgabe (z. B. eine Bildbeschreibung) erzeugen. Diese Ausgabe wird dann als Eingabe verwendet, und das Modell versucht erneut, zu generieren oder zu optimieren. Durch kontinuierliches Selbst-Feedback und Korrekturen wird schließlich eine zufriedenstellende Lösung erreicht.
Nutzung des Potenzials vortrainierter Modelle: MILS stützt sich auf das vortrainierte Wissen großer Sprachmodelle, die bereits große Mengen an Textdaten gelernt haben und dadurch komplexe Semantik und Kontexte verstehen können. Auf diese Weise kann MILS die innewohnenden Fähigkeiten dieser Modelle nutzen, um auf das Verständnis und die Generierung nicht-textueller Daten wie Bilder und Klänge zu wechseln.
Paper: https://arxiv.org/pdf/2501.18096
Github: https://github.com/facebookresearch/MILS









