
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
OmniHuman: End-to-End-Multimodal-Framework zur Generierung von Digital-Human-Videos
小编 ·

OmniHuman: End-to-End-Multimodal-Framework zur Generierung von Digital-Human-Videos
OmniHuman ist ein auf einem Diffusion-Transformer basierendes multimodales Framework zur Generierung von ByteDance-digitalen Video-Personen. Es genügt ein Foto und eine Audiodatei, um ein Video zu erzeugen – und die Bewegungen, Lippensynchronisation und Mimik sind nahezu perfekt.
Das OmniHuman-Framework erweitert den Datenumfang, indem es während der Trainingsphase bewegungsbezogene Bedingungen mischt. Der Kern dieses Frameworks liegt in seiner Fähigkeit, mehrere Eingabemodalitäten zu verarbeiten und so realere und natürlichere Videos digitaler Personen zu erzeugen.
OmniHuman – Kernfunktionen
Multimodale Eingabe: OmniHuman unterstützt verschiedene Eingabeformen, darunter Text, Audio und Video, sodass die generierten digitalen Personen in unterschiedlichen Szenarien reichhaltigere Emotionen und Bewegungen zeigen können. Durch die Verschmelzung modalitätsübergreifender Daten wird der Engpass bei der Knappheit hochwertiger Daten überwunden.
Erweiterung des Datenumfangs: Durch die Einführung bewegungsbezogener Bedingungen kann OmniHuman den Datensatz während des Trainings effektiv vergrößern und dadurch die Generalisierungsfähigkeit und Ausdruckskraft des Generierungsmodells verbessern.
Hochwertige Ausgabe: Das Framework nutzt fortschrittliche Deep-Learning-Techniken, um hochwertige Videos digitaler Personen zu erzeugen. Es unterstützt nicht nur echte Personen, sondern auch 3D-Figuren sowie Anime-Charaktere und eignet sich damit für Livestreaming, Unterhaltung, Bildung und viele weitere Bereiche.
Echtzeitgenerierung: OmniHuman verfügt zudem über die Fähigkeit zur Echtzeitgenerierung, sodass Nutzer in interaktiven Szenarien sofort Rückmeldungen und Darstellungen der digitalen Person erhalten.
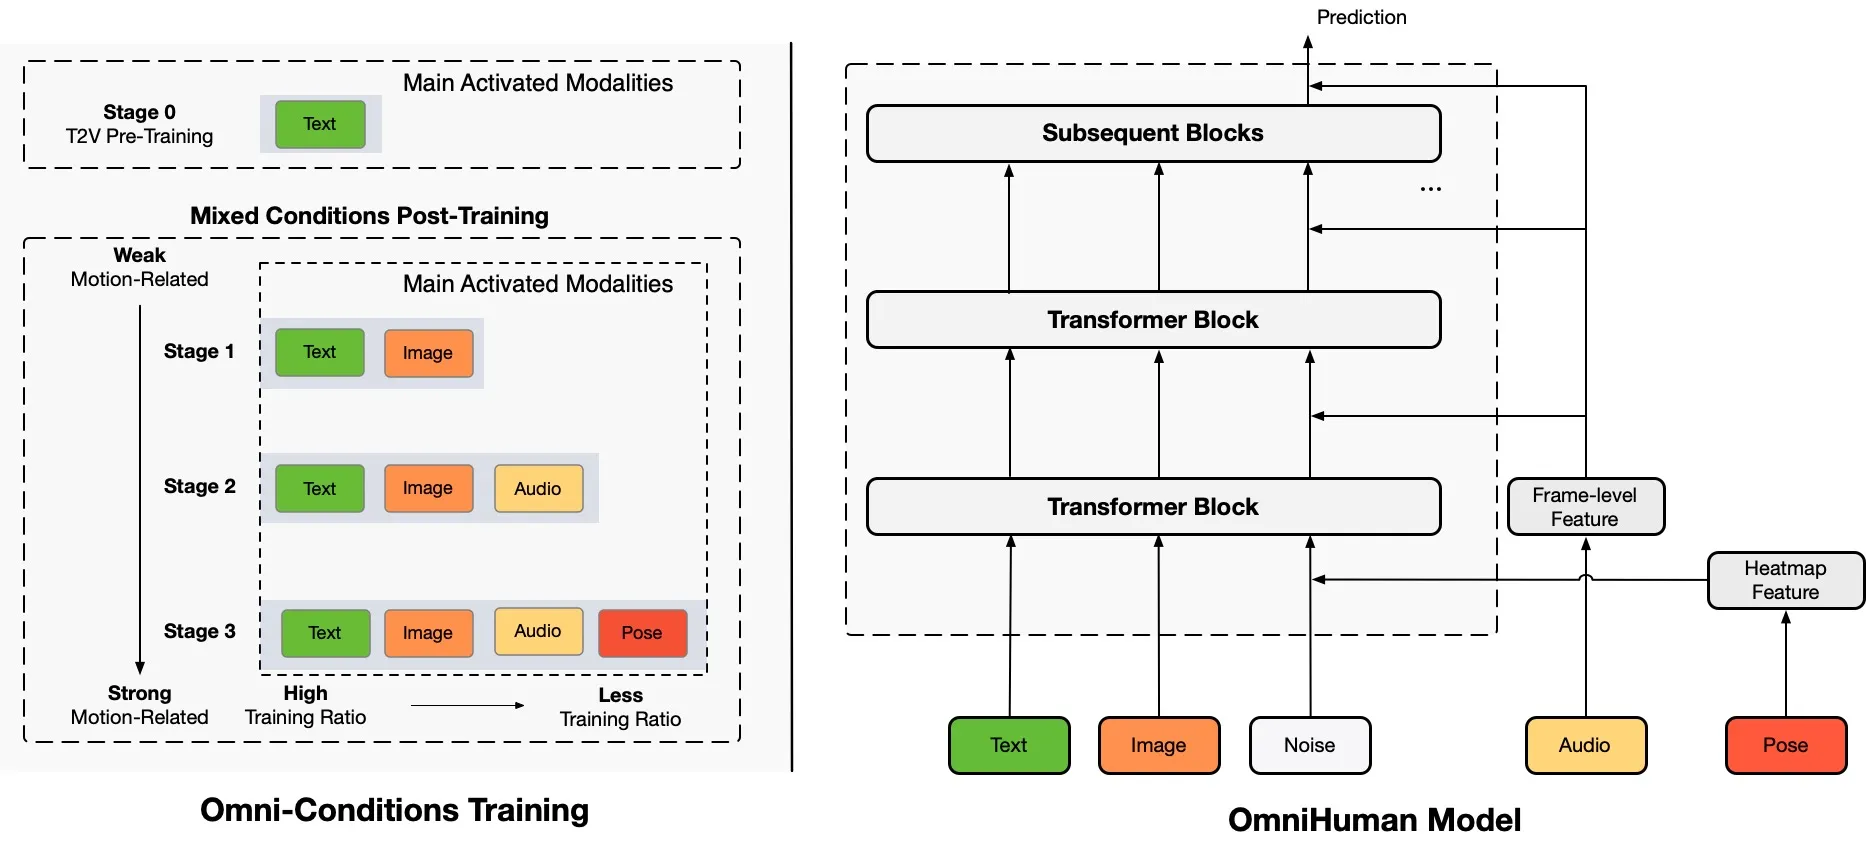
OmniHuman unterstützt außerdem mehrere Steuermodi, darunter Audio-Steuerung, Video-Steuerung und kombinierte Steuersignale, was den Nutzern eine größere Flexibilität bei den Eingaben bietet. Darüber hinaus kann OmniHuman Interaktionen zwischen Mensch und Objekt sowie anspruchsvolle Körperhaltungen verarbeiten, was den Realismus und die Ausdruckskraft der erzeugten Videos weiter erhöht. Die Designphilosophie des OmniHuman-Frameworks besteht darin, die datengetriebene Bewegungsgenerierung umfassend zu nutzen, um letztlich eine höchst realistische Videogenerierung von Menschen zu erreichen. Im Vergleich zu bestehenden End-to-End-Audiogesteuerten Methoden erzeugt OmniHuman nicht nur realistischere Videos, sondern bietet auch eine deutlich größere Flexibilität bei den Eingaben. Videoproben sind auf der ttfamily-Projektseite verfügbar und zeigen die Anwendung in verschiedenen Szenarien.
OmniHuman – Anwendungsszenarien
Virtuelle Streamer: Auf Livestreaming-Plattformen kann OmniHuman virtuelle Streamer erzeugen, die Echtzeit-Interaktion und Unterhaltungsinhalte bieten.
Bildung und Training: Durch die Erzeugung virtueller Lehrkräfte kann OmniHuman in der Online-Bildung personalisierte Lernerfahrungen ermöglichen.
Spieleentwicklung: In Spielen können virtuelle Charaktere mit OmniHuman erzeugt werden, um die Immersion und Interaktivität zu steigern.
OmniHuman Projektadresse: https://omnihuman-lab.github.io









