
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Open R1: ein vollständig Open-Source-Reproduktionsprojekt von DeepSeek-R1
小编 ·

Open R1: ein vollständig Open-Source-Reproduktionsprojekt von DeepSeek-R1
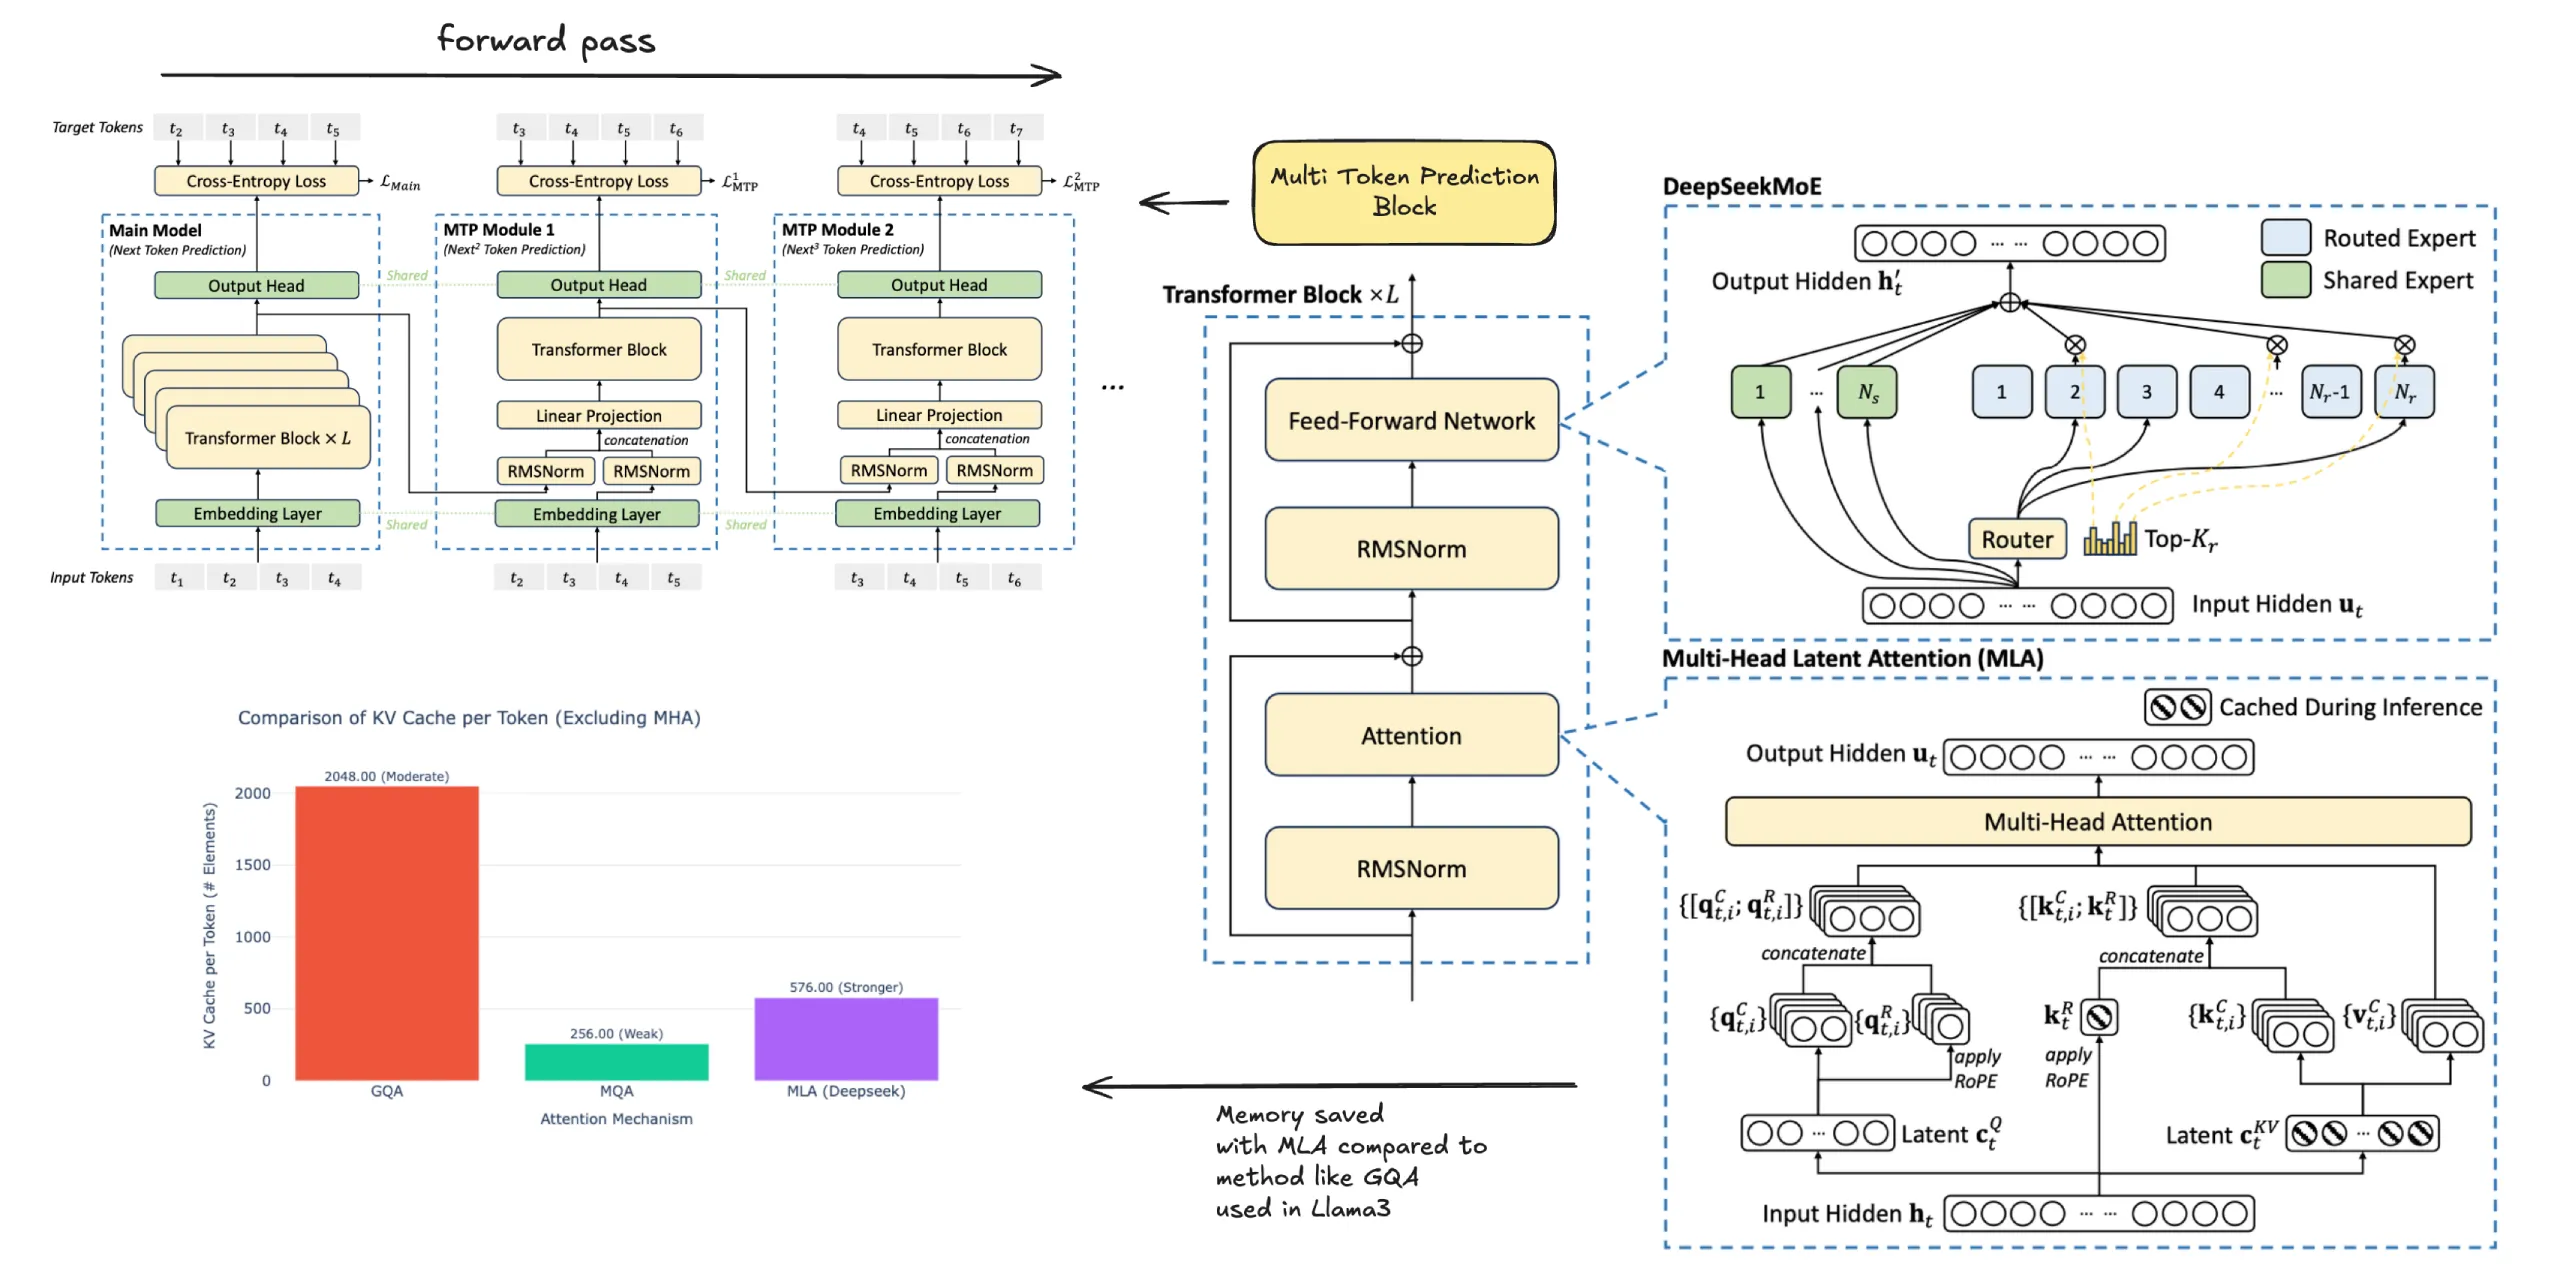
Open R1 ist ein von Hugging Face initiiertes vollständig quelloffenes Reproduktionsprojekt von DeepSeek-R1, mit dem Ziel, den Trainingsprozess des DeepSeek R1-Modells vollständig nachzubilden. Das Ziel des Projekts ist es, die fehlenden Teile der DeepSeek-R1-Pipeline zu ergänzen und der Forschung sowie der Industrie eine vollständige Inferenz- und Optimierungstrainingspipeline bereitzustellen.
Ziele des Projekts
Reproduktion der DeepSeek-R1-Trainingspipeline: Auf quelloffene Weise wird detailliert gezeigt, wie der Trainingsprozess von DeepSeek-R1 schrittweise reproduziert werden kann – von Knowledge Distillation über Reinforcement Learning bis hin zum mehrstufigen Training.
Bereitstellung einer vollständigen Implementierung: Das Projekt umfasst eine vollständige Inferenz- und Optimierungstrainingspipeline, die sicherstellt, dass Nutzer das Modell einfach verwenden und anpassen können.
Bestandteile des Projekts
Trainingsdaten und Skripte: Bereitstellung von quelloffenen Datensätzen und Trainingsskripten, damit Nutzer Experimente durchführen und überprüfen können.
Dokumentation und Beispiele: Ausführliche Dokumentationen und Beispielcodes, die Nutzern helfen, schnell einzusteigen und die Verwendung des Modells zu verstehen.
Das Open-R1-Projekt legt besonderen Wert auf die folgenden Aspekte:
Datensammlung und Trainingscode: Obwohl die Modellgewichte von DeepSeek-R1 offen sind, wurden die für das Training verwendeten Datensätze und Codes nicht veröffentlicht. Open R1 plant, die Daten und die Trainingspipeline von DeepSeek-R1 systematisch zu rekonstruieren, um die behaupteten Effekte zu überprüfen und die Grenzen offener Inferenzmodelle zu erweitern.
Mehrstufiges Training: Das Projekt umfasst einen mehrstufigen Trainingsprozess vom Basismodell über Supervised Fine-Tuning (SFT) bis hin zu Reinforcement Learning (RL) und zeigt, wie bestehende oder neue Modelle mithilfe synthetischer Datensätze in Inferenzmodelle umgewandelt werden können.
Anwendungen über verschiedene Domänen hinweg: Neben mathematischen Datensätzen möchte Open R1 auch das Potenzial in anderen Bereichen erkunden, etwa Code und Medizin sowie andere wissenschaftliche Bereiche, in denen Inferenzmodelle einen erheblichen Einfluss haben könnten.
Wie wird das Open-R1-Projekt durchgeführt?
Schritt 1: Ein hochwertiges Korpus wird mit DeepSeek-R1 destilliert, um das R1-Distill-Modell zu reproduzieren und zu prüfen, ob die Ergebnisse tatsächlich so gut sind, wie DeepSeek behauptet.
Schritt 2: Die reine Reinforcement-Learning-Pipeline (RL), die DeepSeek zum Aufbau von R1-Zero verwendet, wird repliziert.
Schritt 3: Durch mehrstufiges Training wird vom Basismodell zur RL-Version übergegangen.
Open-R1-Projekt:https://huggingface.co/blog/open-r1
Open-R1-Code:https://github.com/huggingface/open-r1









