
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Was ist Modell-Distillation bei großen KI-Modellen und worum geht es bei den Vorwürfen der „Modell-Destillation“ gegen DeepSeek?
小编 ·

Was ist Modell-Distillation bei großen KI-Modellen und worum geht es bei den Vorwürfen der „Modell-Destillation“ gegen DeepSeek?
DeepSeek ist ein aufstrebendes KI-Unternehmen, das kürzlich aufgrund von Vorwürfen, Technologie von Openai für Modelldestillation zu verwenden, große Aufmerksamkeit erregt hat. OpenAI behauptet, DeepSeek habe möglicherweise durch Destillationstechniken das Wissen seiner Modelle extrahiert und so ein Konkurrenzprodukt entwickelt.
Was ist Destillation (Distillation) bei großen Modellen?
Die Destillation großer Modelle ist eine Modellkomprimierungstechnik, die darauf abzielt, das Wissen eines großen, komplexen Modells (als Lehrer-Modell bezeichnet) auf ein kleineres, effizienteres Modell (als Schüler-Modell bezeichnet) zu übertragen. Bei diesem Prozess wird das Schüler-Modell darauf trainiert, die Ausgaben des Lehrer-Modells nachzuahmen, um die Leistung beizubehalten und gleichzeitig den Rechenressourcenverbrauch zu reduzieren.
Dieses Konzept wurde 2015 von Hinton und anderen vorgestellt und wird häufig für Modellkomprimierung, Inferenzbeschleunigung und die Senkung von Bereitstellungskosten verwendet, wobei die Leistung des ursprünglichen Modells so weit wie möglich erhalten bleibt. Die Destillationstechnik wird im Deep Learning vielfältig eingesetzt, insbesondere in den Bereichen Verarbeitung natürlicher Sprache und Computer Vision.
Im Folgenden können Sie dies anhand einer Mindmap von „Jeff Tech Perspective" (Jeff Li) auf YouTube nachvollziehen. Lehrer Jeff Li erklärt dies in der Video-Folge „Nr. 379: Destillation (Distillation) großer Modelle und die Vorwürfe gegen DeepSeek" sehr ausführlich.
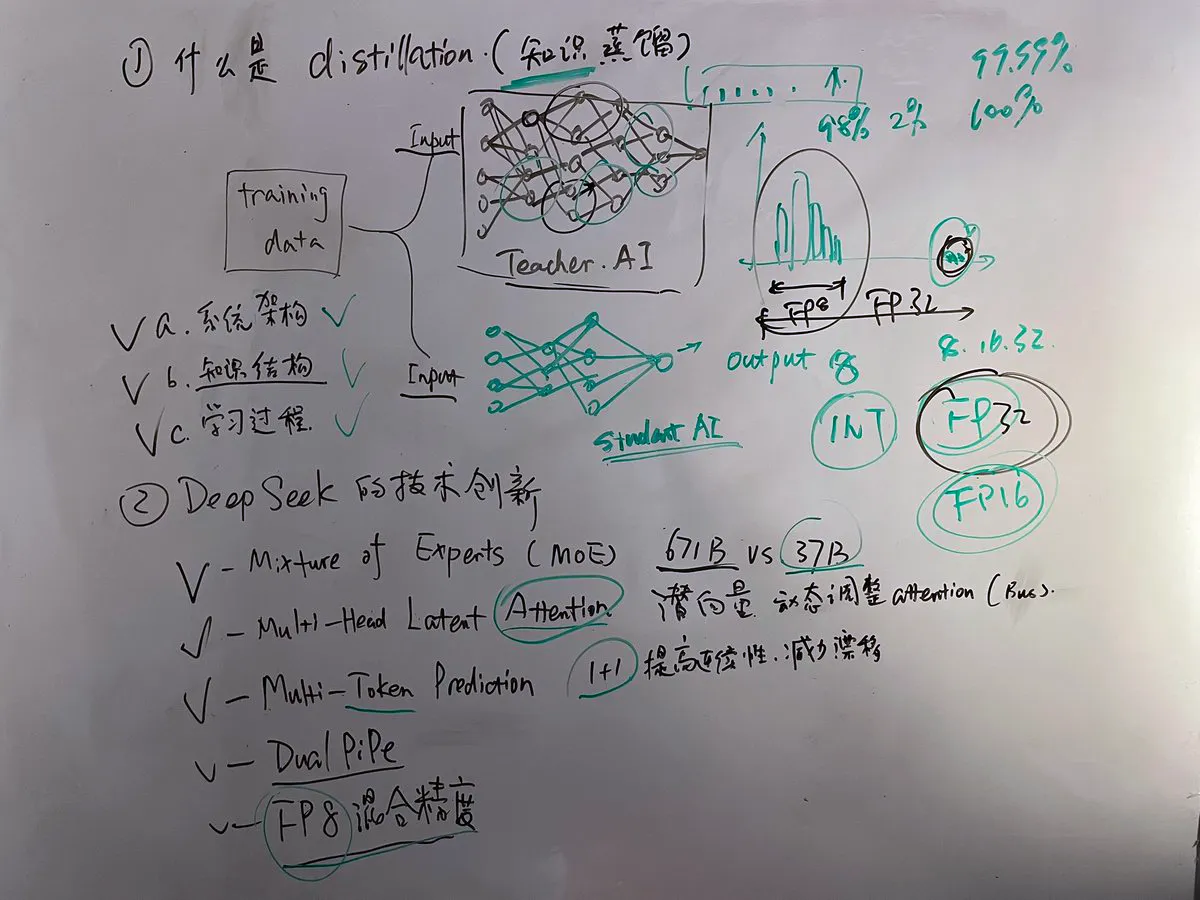
Implementierung der Destillation großer Modelle:
Soft Labels: Verwendung der vom Lehrer-Modell erzeugten Wahrscheinlichkeitsverteilungen anstelle von Hard Labels für das Training.
Hidden Activations: Teile der Ausgaben mittlerer Schichten des Lehrer-Modells werden als Hilfssignale für das Schüler-Modell verwendet.
Attention Weights: Bei Sequenzmodellen können auch Informationen zum Aufmerksamkeitsmechanismus übertragen werden
Die Vorwürfe der „Modelldestillation" gegen DeepSeek
Hintergrund:
DeepSeek ist ein Startup-Unternehmen, das eigene Produkte im Bereich großer Sprachmodelle anbietet.
Die Strategie von DeepSeek, kostengünstige Modelle zu entwickeln, Open Source einzusetzen und kostenlose Angebote bereitzustellen, könnte die Marktstellung von Unternehmen wie OpenAI und Anthropic bedrohen. Dies hat dazu geführt, dass Wettbewerber DeepSeek kritisieren und der Meinung sind, dass DeepSeek deren Technologie und Daten in unlauterer Weise verwendet.
Schlüsselpunkte:
Die Position von OpenAI
Vorwurf, dass DeepSeek unerlaubt Daten erfasst und zum Training eigener Modelle verwendet habe.
Eigene bestehende Probleme: Auch OpenAI wird vorgeworfen, unrechtmäßig Daten aus dem Internet zum Training seiner Modelle erfasst zu haben, insbesondere urheberrechtlich geschützte Artikelwerke. Zudem wurde OpenAI bereits wegen ähnlichen Verhaltens von Verlagsorganisationen wie der New York Times verklagt.
Die Sichtweise von Anthropic
Relativierung des Schweregrads: Anthropic ist der Ansicht, dass DeepSeek keine echte Bedrohung für deren Produkte darstellt, und bezeichnet das technologische Niveau als lediglich dem Niveau einiger Monate zuvor entsprechend.
Die Haltung von Microsoft
Microsoft hat das DeepSeek-Modell auf seinen Plattformen Azure AI und GitHub bereitgestellt, was eine gewisse Form der Unterstützung signalisiert. Dies hat zudem Diskussionen über Interessenkonflikte ausgelöst.
Spezifische Kontroverse um die Modelldestillation
Rechtmäßigkeit und Normen: Modelldestillation ist eine gängige technische Praxis, unterliegt jedoch bei der tatsächlichen Anwendung strengen Regelungen. Insbesondere bei den Bestimmungen zu kommerzieller Nutzung und Vereinbarungen zum Technologieaustausch legen die verschiedenen Unternehmen diese unterschiedlich aus und setzen sie mit unterschiedlicher Strenge durch.
Wie definiert man die „unautorisierte" Beschaffung von Daten?
Ist es erlaubt, Daten aus bestimmten API-Ausgaben zum Training neuer konkurrierender Modelle zu verwenden?
Beweise und unterstützende Materialien: Bislang haben beide Seiten keine detaillierten Beweise zur vollständigen Untermauerung ihrer jeweiligen Behauptungen öffentlich gemacht, was die Komplexität und Unsicherheit des Vorfalls erhöht.
Reaktion der Branche und öffentliche Meinung
Die Meinungen innerhalb und außerhalb der Community gehen auseinander. Einige betrachten dies als Teil des Wettbewerbs auf dem Markt; viele Stimmen richten ihre Aufmerksamkeit jedoch auch darauf, ob ethische und rechtliche Regelungen hinter den Kulissen hinreichend respektiert wurden.
Die Vorwürfe der „Modelldestillation" gegen DeepSeek spiegeln die aktuell intensive Wettbewerbssituation in der KI-Branche sowie die Herausforderungen wider, die sich aus rechtlichen Grauzonen in Bezug auf Datennutzungsrechte und die Grenzen technologischer Innovation ergeben.









