
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Alibaba Qwen veröffentlicht sein Vision-Language-Modell der nächsten Generation: Qwen2.5-VL
小编 ·

Alibaba Qwen veröffentlicht sein Vision-Language-Modell der nächsten Generation: Qwen2.5-VL
Alibaba Qwen2.5-VL ist ein neuartiges visuelles Verstehensmodell, das vom Qwen-Team von Alibaba (Tongyi Qianwen) veröffentlicht wurde. Dieses Modell verfügt über starke Fähigkeiten im visuellen Verstehen, als Agent sowie im langen Videoverstehen und in der Ereigniserkennung und zielt darauf ab, die Anwendung und Entwicklung von KI in vielen Bereichen voranzutreiben.
Hauptfunktionen von Qwen2.5-VL
Visuelles Verstehen: Qwen2.5-VL kann häufig vorkommende Objekte in Bildern wie Blumen, Vögel, Fische und Insekten präzise erkennen und Text, Diagramme, Symbole, Grafiken sowie Layouts in Bildern analysieren. Dadurch zeichnet es sich bei der Verarbeitung visueller Informationen aus und kann den Nutzern detaillierte Bildanalyseergebnisse liefern.
Videoverstehen: Das Modell unterstützt bahnbrechend das Verstehen von Videos mit einer Länge von über einer Stunde und kann spezifische Ereignisse im Video erkennen und analysieren. Diese Funktion verschafft Qwen2.5-VL deutliche Vorteile bei der Analyse und Verarbeitung von Videoinhalten.
Dynamische Schlussfolgerungsfähigkeit: Qwen2.5-VL verfügt über dynamische Schlussfolgerungsfähigkeiten und kann basierend auf der visuellen Umgebung und Textanweisungen komplexe Entscheidungen treffen und Aktionen ausführen. Dadurch kann es als visueller KI-Agent direkt Geräte wie Smartphones und Computer steuern.
Mehrere Modellgrößen: Qwen2.5-VL wird in drei verschiedenen Größen angeboten – 3B, 7B und 72B. Nutzer können je nach Bedarf die passende Version wählen, um unterschiedliche Anforderungen an Rechenressourcen und Anwendungsszenarien zu erfüllen.
Hauptmerkmale
Mehrere Modellgrößen
Es werden drei Versionen mit unterschiedlicher Parameteranzahl – 3B, 7B und 72B – angeboten, die jeweils für unterschiedliche Anwendungsszenarien und Hardwarekonfigurationen geeignet sind.
3B-Version: Geeignet für mobile Endgeräte und andere ressourcenbeschränkte Umgebungen.
7B-Version: Bietet ein ausgewogenes Verhältnis zwischen Leistung und Ressourcenverbrauch und ist für die meisten Anwendungsszenarien geeignet.
72B-Version: Version mit höchster Leistung, geeignet für Anwendungen, die hohe Präzision und starke Funktionen erfordern.
Fortschrittliche Funktionen
Visuelle Lokalisierungsfähigkeit: Kann Objekte in Bildern präzise identifizieren und deren Positionsinformationen in Form von Koordinaten zurückgeben.
Allgemeine Bilderkennung: Erkennt nicht nur häufige Objekte (wie Blumen, Vögel, Fische), sondern analysiert auch Elemente wie Text, Diagramme und Symbole in Bildern.
Dokumentanalyse: Deutlich verbessertes Verstehen von Dokumenten und Tabellen, insbesondere bei der Beantwortung akademischer Fragen, mathematischer Fähigkeiten und Dokumentverifikation.
Videoverstehen: Unterstützt das Verstehen von langen Videos (bis zu Stundenlänge) mit ereignisgenauer Lokalisierung im Sekundenbereich und kann Videopunkte zusammenfassen sowie Schlüsselinformationen extrahieren.
Visueller Agent: Kann ohne aufgabenspezifisches Feintuning Computer und Smartphones bedienen und komplexe Schlussfolgerungs- und Entscheidungsaufgaben ausführen.
Texterkennung und -verstehen: Verbesserte OCR-Fähigkeiten, unterstützt Texterkennung und Informationsextraktion in mehreren Szenarien, Sprachen und Richtungen.
Verbesserungen
Raum-Zeit-Wahrnehmung: Verbessert die Wahrnehmung zeitlicher und räumlicher Skalen, sodass das Modell verschiedene Datentypen besser verstehen und verarbeiten kann.
Vereinfachte Netzwerkstruktur: Einführung eines Fenster-Attention-Mechanismus zur Reduzierung des Rechenaufwands und Steigerung der Modelleffizienz.
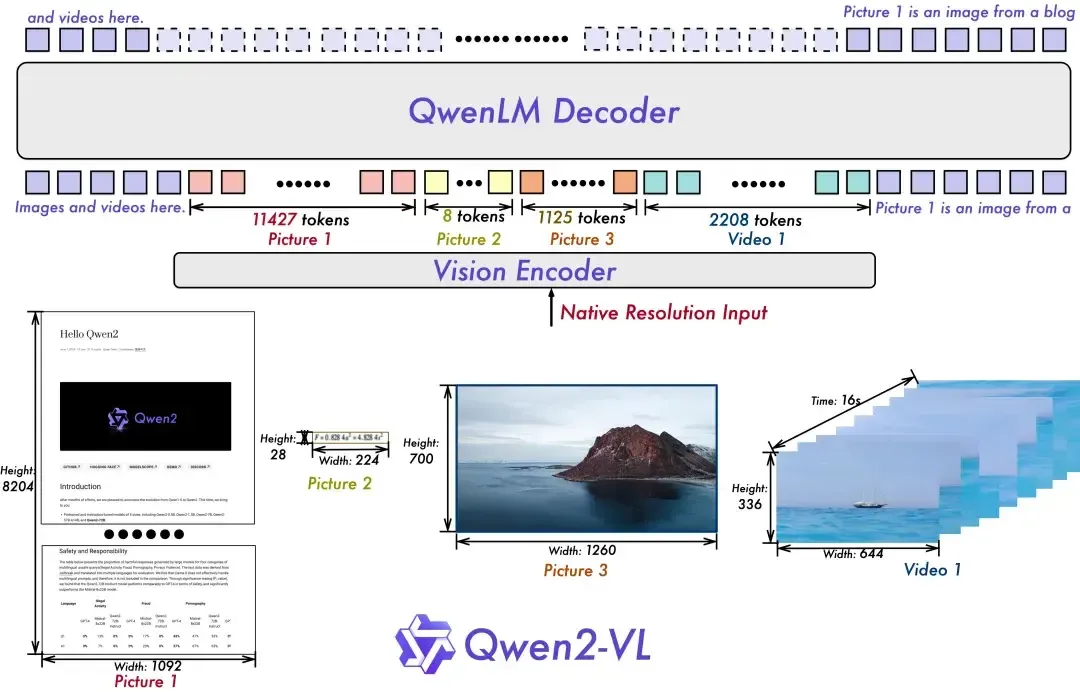
Dynamische Auflösung: Verwendung eines ViT mit nativer dynamischer Auflösung, das die native Auflösung beibehält und gleichzeitig den Rechenaufwand reduziert.
Leistung
Führend in mehreren Benchmark-Tests: Zeigt in zahlreichen Benchmarks verschiedener Bereiche hervorragende Leistungen und übertrifft insbesondere bei Aufgaben wie Dokumentverstehen, visueller Fragebeantwortung, Videoverstehen und als visueller Agent konkurrierende Modelle.
Konkrete Anwendungsbeispiele:
Dokumentverstehen: Hervorragende Leistung bei Aufgaben wie DocVQA.
Videoverstehen: Kann stundenlange Videoinhalte präzise verstehen und wichtige Ereignisse schnell lokalisieren sowie zusammenfassen.
Visueller Agent: Führt ohne zusätzliche Anpassung komplexe Automatisierungsaufgaben aus, etwa die Steuerung von Geräten und Softwareoberflächen.
Anwendungsszenarien für Qwen2.5-VL
Intelligenter Kundenservice: Qwen2.5-VL kann in Video-Customer-Service-Szenarien eingesetzt werden, um vom Nutzer gezeigte Produktbilder oder Barcodes in Echtzeit zu analysieren und relevante Produktinformationen bereitzustellen.
Finanz- und Geschäftsbereich: Das Modell unterstützt strukturierte Ausgaben und eignet sich für die Datenverarbeitung wie Rechnungen und Formulare, insbesondere für Anwendungen im Finanz- und Geschäftsbereich.
Bildung und Training: Im Bildungsbereich kann Qwen2.5-VL zur Analyse von Lehrvideos eingesetzt werden und Schülern helfen, komplexe Konzepte und Inhalte zu verstehen.
Analyse medizinischer Bilder: Die visuellen Verstehensfähigkeiten des Modells können auch für die Analyse medizinischer Bildgebung genutzt werden, um Ärzten eine bessere Interpretation bildgebender Daten zu ermöglichen.
Das Modell Qwen2.5-VL setzt die Struktur der vorherigen Generation Qwen-VL fort und verwendet eine Tandemstruktur aus ViT (Vision Transformer) und Qwen2, die eine einheitliche Eingabe von Bildern und Videos unterstützt. Dieses Design ermöglicht es dem Modell, visuelle und sprachliche Informationen besser zu verschmelzen und das Verstehen multimodaler Daten zu verbessern. Darüber hinaus führt Qwen2.5-VL eine multimodale rotierende Positionskodierung (M-ROPE) ein, die die Positionskodierung in zeitliche und räumliche (Höhe und Breite) Komponenten zerlegt und so die multimodalen Verarbeitungs- und Schlussfolgerungsfähigkeiten des Modells stärkt. Das Modell verfügt zudem über die Fähigkeit zur Erkennung von Bildern beliebiger Auflösung und kann Bilder mit unterschiedlichen Auflösungen und Seitenverhältnissen verarbeiten, um die Konsistenz von Eingabe und Bildinformationen sicherzustellen.
Bezugsmöglichkeiten für Qwen2.5-VL:
Open-Source-Adresse: Hugging Face
GitHub: Qwen2.5-VL
Online testen: Qwen Chat









