
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
DeepSeek R1: Open-Source-Reasoning-Modell von DeepSeek, vergleichbar mit OpenAI o1
小编 ·

DeepSeek R1: Open-Source-Reasoning-Modell von DeepSeek, vergleichbar mit OpenAI o1
Was ist DeepSeek R1?
DeepSeek R1 ist ein Open-Source-Reasoning-Großmodell des chinesischen KI-Unternehmens DeepSeek. Durch einen durch Reinforcement Learning getriebenen technischen Ansatz erreicht es bei komplexen Aufgaben wie Mathematik, Programmierung und natürlicher Sprachargumentation eine Leistung, die mit der offiziellen Version von OpenAIs o1 vergleichbar ist. Besonders bei Reasoning-Aufgaben ist es herausragend. Es nutzt Reinforcement-Learning-Techniken, die die Reasoning-Fähigkeiten des Modells deutlich verbessern, und ermöglicht ein effizientes Training mit nur sehr wenigen annotierten Daten. Dieser Ansatz verschafft DeepSeek-R1 auch Kostenvorteile – die Betriebskosten sollen nur 3 % derjenigen von OpenAI betragen.
Kerntechnologien von DeepSeek R1:
Erstens: Durch Reinforcement Learning getriebene Reasoning-Fähigkeiten
Reines Reinforcement Learning (RL)-Training: DeepSeek R1-Zero wendet direkt auf dem Basismodell umfangreiches Reinforcement Learning an, ohne überwachtes Fine-Tuning (SFT), und validiert erstmals, dass reines RL die Reasoning-Fähigkeiten von LLMs anregen kann. Das Modell nutzt den GRPO-Algorithmus (Group Relative Policy Optimization) zur Senkung der Trainingskosten und verwendet ein regelbasiertes Belohnungssystem (Genauigkeits- und Format-Belohnungen), um das Modell zur Erzeugung strukturierter Chain-of-Thought (CoT) zu führen.
Optimierung durch Cold-Start-Daten: Um die Lesbarkeits- und Sprachmischungsprobleme von R1-Zero zu lösen, führt DeepSeek R1 eine kleine Menge Cold-Start-Daten (lange CoT-Beispiele) ein und verbessert durch mehrstufiges Training (Cold-Start-Fine-Tuning → Reasoning-orientiertes RL → Ganzheitliches RL) die Lesbarkeit und Allgemeingültigkeit der Ausgaben.
Long-Chain-Reasoning und Modell-Destillation
Unterstützung ultralanger Chain-of-Thought: Unterstützt ein Kontextfenster von 128K und kann komplexe Probleme in mehrstufige Reasoning-Schritte zerlegen, z. B. bei mathematischen Problemen detaillierte Herleitungen von Zehntausenden von Zeichen erzeugen.
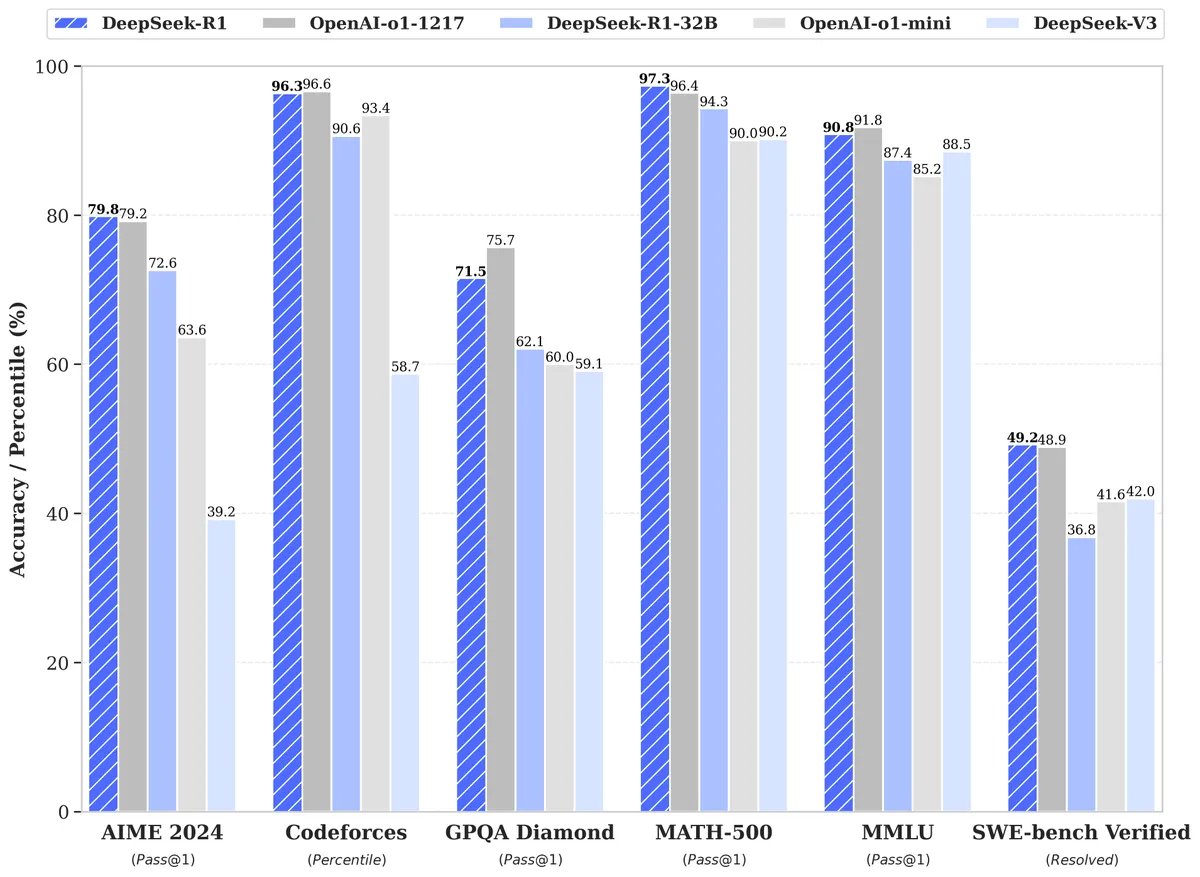
Effiziente Destillationstechnik: Durch 800k Samples werden die Reasoning-Fähigkeiten von R1 auf kleinere Modelle der Qwen- und Llama-Serien (wie 7B, 32B, 70B) destilliert. Die destillierte Qwen-32B-Version erreicht im AIME-2024-Test eine pass@1-Genauigkeit von 72,6 % und kommt damit nahe an o1-mini heran.
Zweitens: Leistung und Benchmarks
Mathematik- und Programmierfähigkeiten
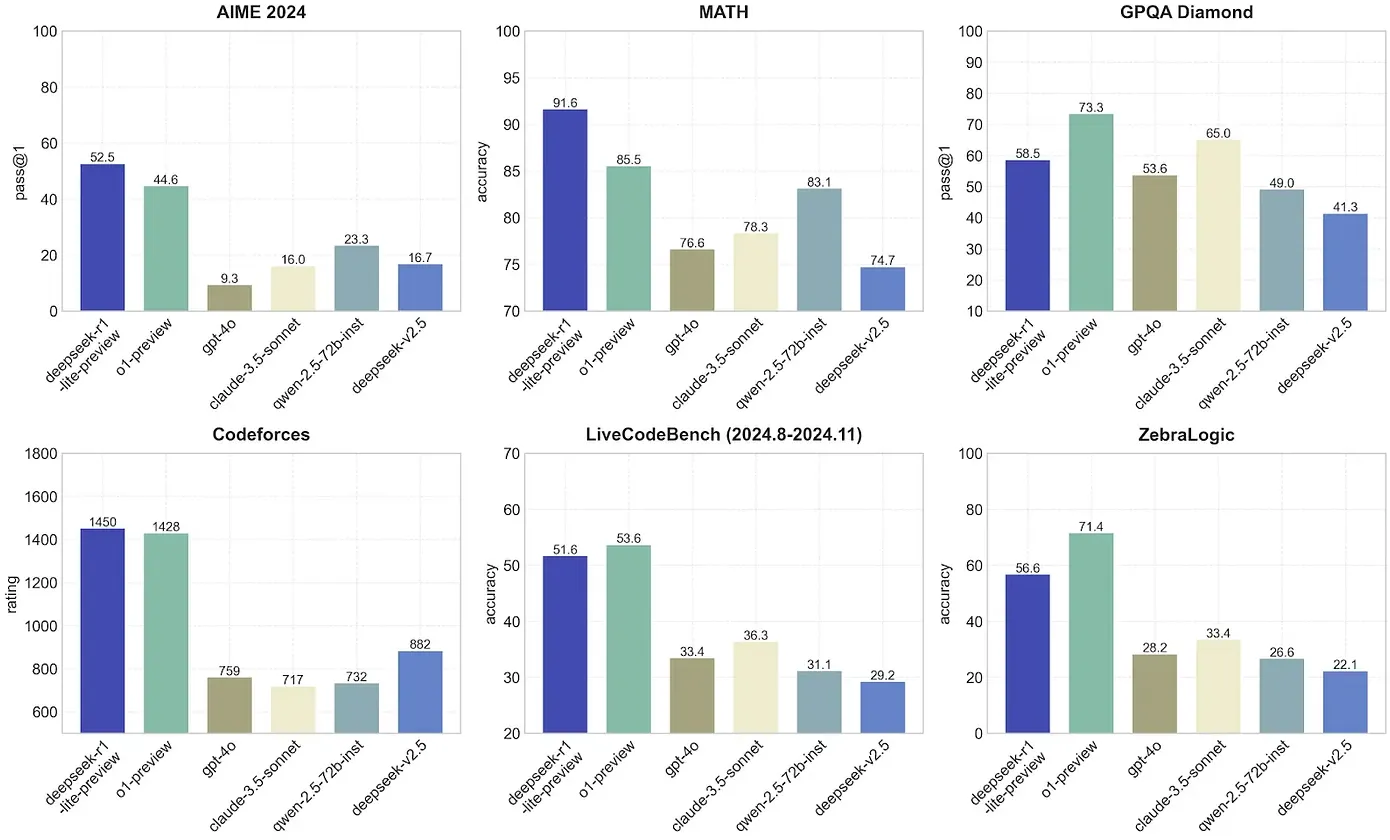
Leistung auf Wettbewerbsniveau in Mathematik: Bei AIME 2024 (der US-Mathematik-Olympiade) erreicht R1 eine pass@1-Genauigkeit von 79,8 %, im MATH-500-Benchmark sogar 97,3 % und übertrifft damit OpenAI-o1-1217. Bei den abschließenden Mathematikaufgaben der Gaokao-Prüfung benötigt R1 nur 83 Sekunden zur Lösung, weist jedoch Mängel bei der Normgerechtigkeit der Lösungsschritte auf.
Expertenniveau bei Codegenerierung: Im Codeforces-Wettbewerb erreicht es eine Elo-Bewertung von 2029 (über 96,3 % der menschlichen Teilnehmer), im LiveCodeBench-Test eine pass@1 von 65,9 %. Nutzertests zeigen, dass R1 in nur 9 Minuten Visualisierungscode für Quantenmechanik generiert, der direkt ausführbar ist.
Allgemeine Sprach- und Wissensaufgaben
Umfassende Fähigkeiten in mehreren Bereichen: Im MMLU-Test (Multitask Language Understanding) erreicht es 90,8 %, MMLU-Pro 84 %, GPQA Diamond 71,5 % – deutlich besser als DeepSeek-V3 und nahe an OpenAI-o1.
Reasoning in Geisteswissenschaften und Geschichte: Bei chinesischen Rätseln erreicht es eine korrekte Rate von 100 %, und auch bei komplexen historischen Fragen zu altägyptischer Geschichte und indigenen Völkern Afrikas liefert es logisch klare, informationsreiche Antworten, die informationsreicher sind als bei Nicht-Reasoning-Modellen.
Drittens: Open-Source-Ökosystem und Kostenvorteile
Open-Source-Strategie und Geschäftsfreundlichkeit
Open Source unter MIT-Lizenz: Das vollständige Modell (671B Parameter) sowie 6 destillierte Modelle (1,5B–70B) sind open source und unterstützen kostenlose kommerzielle Nutzung, Modifikation und Weiterentwicklung. So läuft beispielsweise die destillierte Qwen-14B-Version bereits auf Desktop-Hardware und erreicht im LiveCodeBench 53,1 %.
API-Preisinnovation: Die Kosten für Input-Tokens liegen bei nur 1 Yuan/Million (bei Cache-Treffern), für Output-Tokens bei nur 16 Yuan/Million – etwa 3,7 % des Preises von OpenAI-o1. Nutzertests zufolge kann ein einzelner API-Aufruf bereits ab 0,06 US-Dollar kosten.
Entwickler-Tools und Integrationsunterstützung
Multi-Plattform-Bereitstellung: Unterstützt Hugging Face, das vLLM-Framework und die Spring-AI-Integration; Entwickler können das Modell durch einfache Konfiguration aufrufen. So müssen Spring-AI-Nutzer beispielsweise nur Abhängigkeiten hinzufügen und den API-Schlüssel konfigurieren, um es anzubinden.
Reasoning-Stabilitätsoptimierung: Die API deaktiviert standardmäßig den Temperature-Parameter, um stabile Ausgaben sicherzustellen, und gibt Chain-of-Thought und endgültige Antwort über die Felder reasoning_content bzw. content separat zurück.
Viertens: Anwendungsszenarien
Forschung und Bildung: Unterstützt mathematische Modellierung, Codegenerierung und historische Analysen, liefert detaillierte Reasoning-Prozesse und unterstützt die akademische Forschung. Beispiele sind die Generierung von Code für Quantenmechanik-Animationen oder die Analyse komplexer mathematischer Probleme.
Unternehmensintelligenz: Integration in Kundenservice-Systeme, Datenanalyse-Tools oder automatisierte Entscheidungsplattformen zur Senkung der KI-Bereitstellungskosten.
Mit seiner Open-Source-Strategie und extrem niedrigen Kosten (Trainingskosten 5,576 Mio. US-Dollar, etwa 1/10 der Kosten von GPT-4) treibt R1 einen Preiswettkampf in der Branche voran; Meta und andere Unternehmen haben bereits spezielle Teams eingerichtet, um dessen technischen Ansatz zu untersuchen.
Experten wie Yann LeCun sind der Ansicht, dass der Erfolg von R1 einen Wendepunkt markiert, an dem Open-Source-Modelle vom „Verfolger" zum „Vorreiter" werden, und die globale Zusammenarbeit von Entwicklern sowie technologische Innovationen fördert.
DeepSeek R1 ist mit seinen durch Reinforcement Learning getriebenen Reasoning-Fähigkeiten und seiner Open-Source-Strategie zu niedrigen Kosten ein bedeutender Durchbruch im KI-Bereich. Es brilliert nicht nur in professionellen Aufgaben wie Mathematik und Programmierung, sondern fördert durch sein Open-Source-Ökosystem auch globale technologische Innovationen und bietet ein neues Paradigma für die Entwicklung von AGI.









