
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
FunAudioLLM: Alibabas Durchbruch in der Sprach-KI
小编 ·

FunAudioLLM: Alibabas Durchbruch in der Sprach-KI
FunAudioLLM ist ein von Alibaba entwickeltes Sprachverarbeitungsmodell, das die Sprachinteraktion zwischen Menschen und großen Sprachmodellen verbessern soll. Es besteht aus zwei Hauptmodellen: SenseVoice und CosyVoice.
SenseVoice: Ein Spracherkennungsmodell, das Sprache in mehreren Sprachen erkennen kann, die Emotionen des Sprechers erkennt und spezielle Ereignisse im Audio (z. B. Musik, Lachen usw.) erkennt. Es kann gesprochene Inhalte schnell und genau transkribieren.
CosyVoice: Ein Sprachgenerierungsmodell, das hauptsächlich natürliche und emotional ausdrucksstarke Sprache erzeugt. Es kann verschiedene Sprecher imitieren und sogar die Stimme einer Person anhand einiger Sekunden Audiomaterial klonen.
Durch die Kombination von SenseVoice und CosyVoice bietet FunAudioLLM umfassende Fähigkeiten zur Sprachverstehung und -erzeugung und ermöglicht so eine natürlichere und vielfältigere Sprachinteraktion zwischen Mensch und großem Sprachmodell.
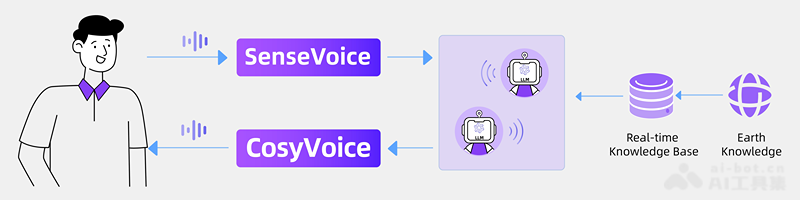
Hauptfunktionen von SenseVoice und CosyVoice:
SenseVoice konzentriert sich auf mehrsprachige Spracherkennung, Emotionserkennung und Audioereigniserkennung und bietet hochpräzise Sprachverarbeitung mit geringer Latenz. CosyVoice konzentriert sich auf die natürliche Spracherzeugung und -steuerung, unterstützt die Erzeugung mehrerer Sprachen, Stimmfarben und Sprechstile und ermöglicht Zero-Shot-Lernen sowie feinkörnige Sprachsteuerung. Die Kombination beider ermöglicht es FunAudioLLM, in einer Vielzahl von Anwendungsszenarien ein hervorragendes Sprachinteraktionserlebnis zu bieten.
Hauptfunktionen von SenseVoice
1. Mehrsprachige Spracherkennung
SenseVoice-Small: Unterstützt fünf Sprachen: Chinesisch, Englisch, Kantonesisch, Japanisch und Koreanisch. Es verwendet eine nicht-autoregressive End-to-End-Architektur mit extrem geringer Erkennungslatenz. Es ist 5-mal schneller als Whisper-small und 15-mal schneller als Whisper-large.
SenseVoice-Large: Hochpräzise Spracherkennung, unterstützt über 50 Sprachen.
2. Emotionserkennung
Erkennt Emotionen in der Sprache wie Freude, Trauer, Wut usw. durch die Erkennung von Tonhöhe, Rhythmus und Tonfallveränderungen der Sprache.
3. Audioereigniserkennung
Erkennt spezielle Ereignisse in der Sprache wie Musik, Lachen, Applaus usw. und sagt den Beginn und das Ende der Ereignisse voraus.
SenseVoice-Small kann verschiedene Ereignisse der Mensch-Computer-Interaktion erkennen, wie Hintergrundmusik, Applaus, Lachen, Weinen, Husten, Niesen usw.
4. Spracherkennung
Kann die vom Sprecher verwendete Sprache erkennen, um die Genauigkeit der Spracherkennung und des Kontextverständnisses sicherzustellen.
5. Inverse Textnormalisierung (ITN)
Bietet Transkriptionsergebnisse mit Interpunktion und Formatierung, um die Lesbarkeit und Genauigkeit des transkribierten Textes zu verbessern.
Hauptmerkmale von FunAudioLLM:
Mehrsprachige Spracherkennung: Über 400.000 Stunden Trainingsdaten, die Erkennungsleistung übertrifft das Whisper-Modell.
Effiziente Inferenz: Das SenseVoice-Small-Modell verwendet ein nicht-autoregressives End-to-End-Framework mit extrem geringer Inferenzlatenz. Die Verarbeitung von 10 Sekunden Audio dauert nur 70 Millisekunden, 15-mal schneller als Whisper-Large.
Emotionserkennung: Erreicht auf mehreren Testdatensätzen Ergebnisse, die die derzeit besten Modelle zur Emotionserkennung übertreffen.
Ereigniserkennung: Unterstützt die Erkennung einer Vielzahl gängiger Audioereignisse.
Bequemes Fine-Tuning: Bietet bequeme Fine-Tuning-Skripte und -Strategien, mit denen Benutzer Long-Tail-Sampling-Probleme in Geschäftsszenarien einfach lösen können.
Service-Bereitstellung: Bietet Service-Bereitstellungs-Pipelines, die mehrere gleichzeitige Anfragen unterstützen. Client-Sprachen umfassen Python, C++, HTML, Java, C# usw.
Hauptmerkmale von CosyVoice:
1. Spracherzeugung
Unterstützt mehrsprachige Spracherzeugung, einschließlich Chinesisch, Englisch, Kantonesisch, Japanisch und Koreanisch.
Kann natürliche und emotional ausdrucksstarke Sprache erzeugen und unterstützt verschiedene Sprechstile und emotionale Ausdrucksformen.
2. Vielfältige Sprachsteuerung
Stimmfarbensteuerung: Kann die Stimmfarbe der erzeugten Sprache präzise steuern, sodass sie mit der Stimme eines bestimmten Sprechers übereinstimmt.
Sprechstilsteuerung: Steuert den Sprechstil der Stimme über Textbefehle, wie Emotion, Sprechgeschwindigkeit, Tonlage usw.
3. Zero-Shot-Lernen
Es genügen einige Sekunden Audiomaterial, um eine Stimme zu klonen – ohne zusätzliche Trainingsdaten.
Unterstützt sprachübergreifendes Stimmklonen, sodass Sie mit einer Sprache und der Stimme einer anderen Sprache sprechen können.
4. Feinkörnige Steuerung paralinguistischer Merkmale
Unterstützt das Einfügen feiner Sprachmerkmale wie Lachen, Atmen, Füllwörter usw., um die erzeugte Sprache natürlicher und lebendiger zu machen.
Textbefehlssteuerung: Über Textbefehle können Identität, Emotion und Sprechstil des Sprechers präzise gesteuert werden.
5. Mehrcharakterdialog
Kann Konversationsstimmen mit mehreren Charakteren erzeugen, geeignet für interaktive Podcasts, emotionale Chats und andere Szenarien.
Projekt-Adresse:https://github.com/FunAudioLLM









