
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Seed-ASR: ByteDances automatische Spracherkennung

Seed-ASR: ByteDances automatische Spracherkennung
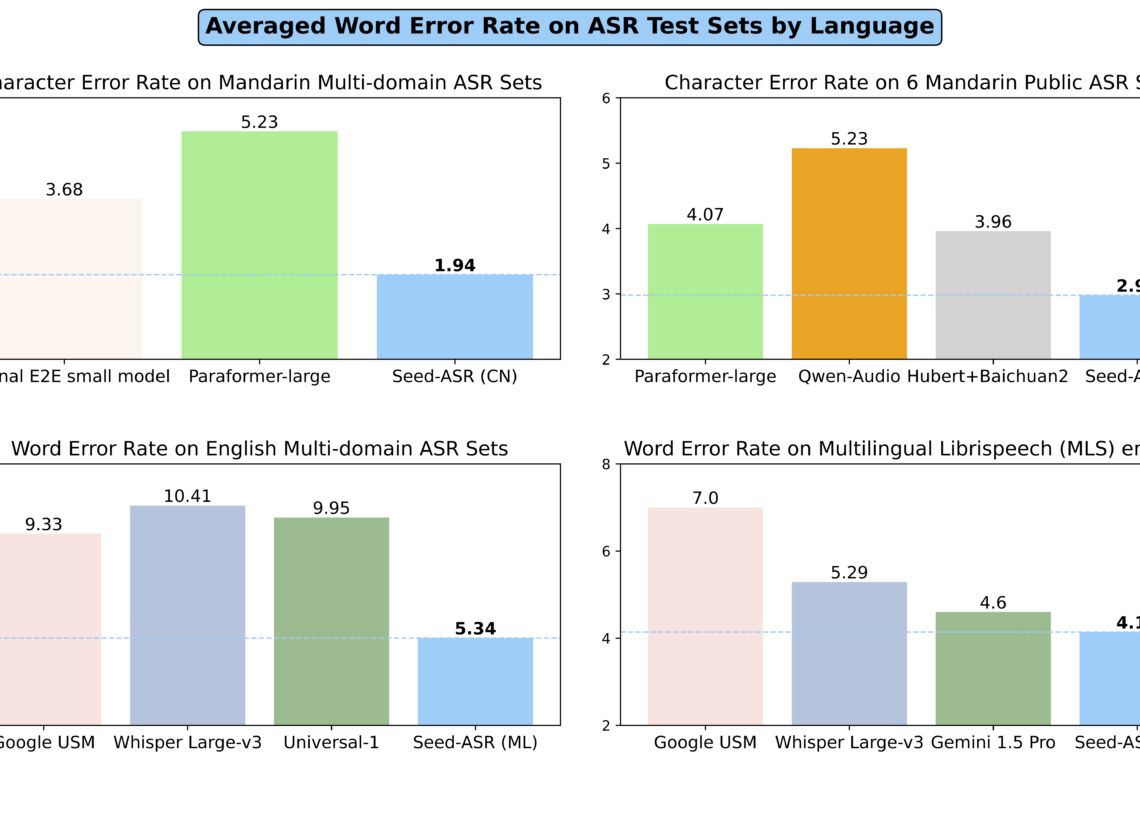
Seed-ASR, ein ByteDance automatischer Spracherkennungsmodell, kann verschiedene Sprache in Textinformationen umwandeln. Anders als herkömmliches TTS, das auf eine einzelne Aufgabe ausgerichtet ist, kann Seed-TTS verschiedene Klänge modellieren und ermöglicht die gleichzeitige Steuerung über zahlreiche Dimensionen. Es kann verschiedene Sprachen, Dialekte, Akzente und sogar Sprachmängel wie verschluckte Silben erkennen.Seed-ASR wurde mit über 20 Millionen Stunden Sprachdaten und fast 900.000 Stunden gepaarten ASR-Daten trainiert.Es unterstützt nicht nur Mandarin, sondern erkennt auch 13 chinesische Dialekte, 7 Fremdsprachen sowie Englisch mit verschiedenen Akzenten.
Seed-ASR verfügt über eine leistungsstarke Kontextwahrnehmung und kann Sprachinhalte in einem bestimmten Kontext erkennen. Beispielsweise kann das Modell historische Dialoge oder Besprechungsaufzeichnungen nutzen, um Personennamen, Ortsnamen oder andere kontextbezogene Schlüsselwörter in der aktuellen Sprache genauer zu identifizieren.
Seed-ASR ist hochgradig skalierbar. Das bedeutet, dass es sich nicht nur um ein festes System handelt, sondern um eine Plattform, die je nach Bedarf angepasst werden kann. Wenn Sie beispielsweise möchten, dass es speziell medizinische Fachbegriffe erkennt oder einen bestimmten Akzent versteht, kann dies durch Feintuning erreicht werden.
Die zentrale Technologie von Seed-ASR ist die Integration großer Sprachmodelle in die Spracherkennung, was Seed-ASR Kontextverständnis verleiht. Dabei werden nicht einfach zwei Systeme zusammengefügt, sondern die Art der Sprachverarbeitung grundlegend verändert. Es ist, als würde man dem Spracherkennungssystem ein Superhirn einsetzen, das nicht nur hört, sondern auch denkt.
Technische Highlights von Seed-ASR:
Hohe Erkennungsgenauigkeit: Verarbeitung komplexer Spracheingaben durch ein Modell mit Milliarden von Parametern zur Erzielung hoher Erkennungsgenauigkeit.
Großes Modell: Durch den Einsatz großer Sprachmodelle werden die Genauigkeit der Spracherkennung und das Kontextverständnis verbessert – vergleichbar mit einem „Supercomputer", der Ihnen beim Diktieren von Notizen hilft. Stellen Sie sich vor, wie cool das ist.
Unterstützung mehrerer Sprachen: Einschließlich Mandarin, 13 chinesischen Dialekten sowie mehreren Fremdsprachen, mit Plänen zur Erweiterung auf über 40 Sprachen.
Kontextwahrnehmung: Kann Kontextinformationen einbeziehen, um die Erkennungsgenauigkeit zu verbessern – ähnlich wie bei einem Gespräch mit Freunden, bei dem das System versteht, was zuvor gesagt wurde, und diese Informationen nutzt, um das aktuell Gesagte genauer zu verstehen.
Mehrstufige Trainingsmethoden: Umfassen selbstüberwachtes Lernen, überwachtes Feintuning, kontextbezogenes Feintuning und Verstärkungslernen, um die Modellfähigkeiten schrittweise zu verbessern.
Anwendungsszenarien von Seed-ASR:
Mensch-Maschine-Interaktion: Bietet einen Spracheingabekanal, indem Sprache in Echtzeit in Text umgewandelt wird, um eine schnelle und bequeme Interaktion mit Geräten/Hardware/Anwendungen zu ermöglichen.
Inhaltsüberprüfung: Erkennt Aufnahmen als Text, analysiert den Text anhand von Qualitätsprüfungsregeln, erkennt Verstöße rechtzeitig und greift ein.
Transkription von Besprechungen und Interviews: Wandelt Audio von Besprechungen und Interviews in Echtzeit oder asynchron in Text um, segmentiert automatisch die Sprachabschnitte und wird erkannt, um Kosten zu senken und die Effizienz zu steigern.
Untertitel für Audio- und Videoinhalte: Unterstützt die automatische Erkennung und Umwandlung von Sprache und Liedtexten in Audio- und Videoinhalten in Text und ermöglicht die Erstellung passender Untertitel mit einem Klick.
Seed-ASR wird bereits in der Doubao-App eingesetzt und von Nutzern in verschiedenen Szenarien wie englischen Gesprächen, virtuellen Chatpartnern und dem Klonen von Stimmen von Angehörigen verwendet. Für weitere Unternehmenskunden basiert Seed-ASR auf Volcano Engine und wird auch in Szenarien wie Sprachinteraktion, Inhaltsüberprüfung, Transkription von Besprechungen und Interviews sowie Audio- und Video-Untertiteln eingesetzt.
Bis dato hat das Doubao-Modellteam im Bereich Sprache bereits mehrere technische Errungenschaften veröffentlicht, darunter Seed-TTS und Seed-ASR.
Offizielle Website von Seed-ASR: https://bytedancespeech.github.io/seedasr_tech_report/









