
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Hallo: hierarchische audiostreamgesteuerte visuelle Synthese für Porträtbild-Animation
小编 ·

Hallo: hierarchische audiostreamgesteuerte visuelle Synthese für Porträtbild-Animation
Hallo kannaus einem einzelnen Bild und Audioeingaben singende und sprechende Videos erzeugen und dabei Mimik sowie Körperhaltung der Figur steuern. Im Vergleich zuEMOverwendetHallo ein Diffusionsmodell, um eine hierarchische audio-gesteuerte visuelle Synthese zu realisieren.Es kann durch Spracheingabe Animationen mit synchroner Lippenbewegung, Mimikveränderungen und Körperhaltungsänderungen der Figur erzeugen. Dadurch wird die Ausrichtungsgenauigkeit zwischen Sprache und erzeugter Animation verbessert, sodass Lippen, Mimik und Körperhaltung der Animation exakt mit der Sprachesynchronisiertsind.
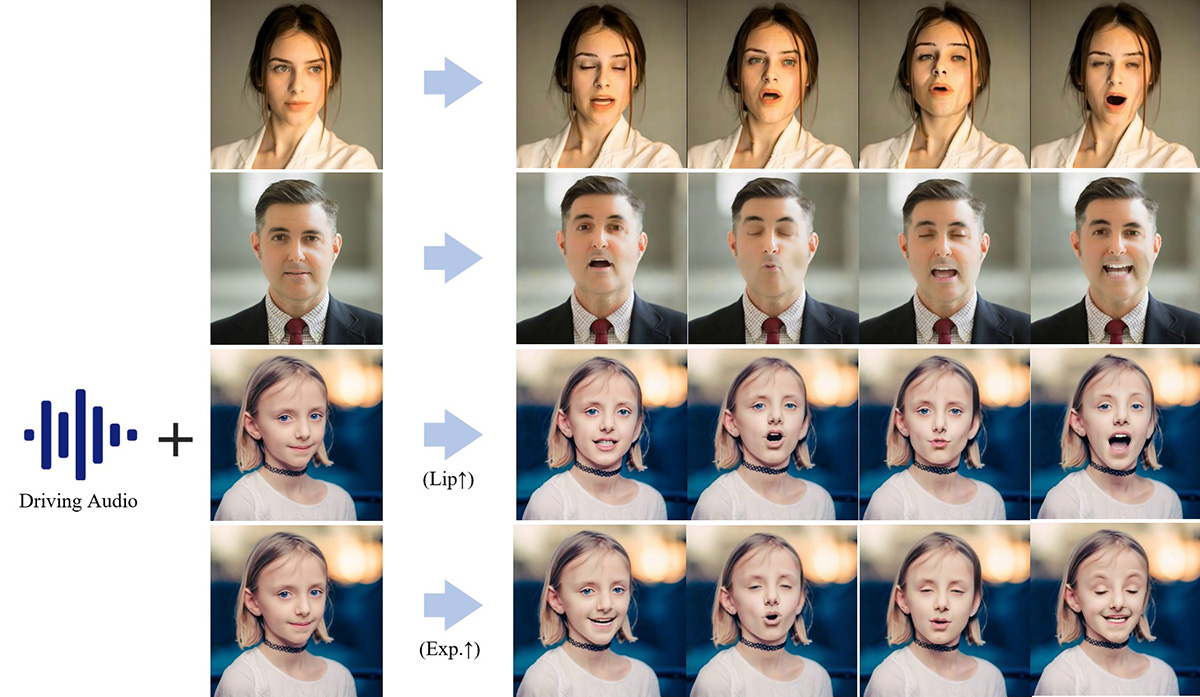
Funktionsmerkmale von Hallo:
Erzeugung von Animationen virtueller Charaktere: Erzeugt realistische, dynamische Animationen virtueller Charaktere aus Sprachaudioeingaben und ermöglicht eine präzise Synchronisation von Mundbewegungen, Mimik und Körperhaltung.
Erzeugung von Animationen realer Charaktere: Wendet die Technologie auf die sprachgesteuerte Animationserzeugung realer Personen an; die erzeugten Animationen spiegeln Mimik und Bewegungsänderungen der realen Personen präzise wider.
Vielseitige Bewegungssteuerung: Bietet eine präzise Steuerung von Mimik, Körperhaltung und Lippenbewegungen der Figur, unterstützt eine adaptive Steuerung verschiedener Mimiken und Körperhaltungen und erhöht so Vielfalt und Realismus der Animation.
Anwendung über verschiedene Darsteller hinweg: Unterstützt die personalisierte Animationserzeugung für unterschiedliche Identitäten; aus Audioeingaben werden Animationen erzeugt, die an verschiedene Rollenidentitäten angepasst sind.
Erzeugung von Gesangsanimationen: Erzeugt aus Sprach- und Gesangsaudioeingaben synchronisierte Gesangsanimationen, die Mundbewegungen und Mimik beim Singen exakt wiedergeben.
Weitere Merkmale von Hallo:
Echtzeitfähigkeit: Durch den Einsatz einer Diffusionsmodell-Architektur wird die Echtzeitfähigkeit der Animationserzeugung verbessert, sodass die erzeugten Animationen realistischer und natürlicher wirken.
Personalisierung: Ermöglicht individuell angepasste Animationseffekte für verschiedene Darsteller oder Figuren.
Vielfalt: Bietet vielfältige Bewegungssteuerungen, einschließlich Mimik, Körperhaltung und Lippenbewegungen, und macht die Animationen abwechslungsreicher und realistischer.
Hallo Projektseite:https://fudan-generative-vision.github.io/hallo
Hallo Github:https://github.com/fudan-generative-vision/hallo
Hallo Paper:https://arxiv.org/abs/2406.08801
HuggingFace:https://huggingface.co/fudan-generative-ai/hallo









