
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Seed-TTS: ein hochwertiges Text-to-Speech-Modell von ByteDance
小编 ·

Seed-TTS: ein hochwertiges Text-to-Speech-Modell von ByteDance
In letzter Zeit hat der TTS-Bereich einen regelrechten Boom erlebt. Kurz nachdem ChatTTS als Open-Source veröffentlicht wurde, hat Byte seed-tts vorgestellt – mit hervorragenden Ergebnissen.
Seed-TTS ist ein hochwertiges Text-to-Speech-Modell (TTS), das von ByteDance entwickelt wurde. Das Seed-TTS-Modell kann Sprache erzeugen, die kaum von menschlicher Sprache zu unterscheiden ist.
Als Grundlagenmodell für die Spracherzeugung zeigt Seed-TTS hervorragende Leistungen beim In-Context-Lernen von Sprache und erreicht sowohl bei der Sprecherähnlichkeit als auch bei der Natürlichkeit in objektiven und subjektiven Bewertungen Werte, die mit echter menschlicher Sprache vergleichbar sind.
Seed-TTS kann ohne zusätzliches Training mit nur einem kurzen Sprachfragment Stimmen klonen und dabei äußerst natürliche sowie ausdrucksstarke Sprache erzeugen. Es eignet sich für Aufgaben wie das Vorlesen von Romanen oder Synchronisationen.
Seed-TTS bietet zudem eine fortschrittliche Steuerung verschiedener Sprachattribute, einschließlich – aber nicht beschränkt auf – Emotionen, Intonation und Sprechstil. Darüber hinaus kann die erzeugte Sprache durch Bearbeiten des Textes editiert werden.
Mit Seed-TTS lässt sich der Inhalt einer Audiodatei verändern, während Timbre, Tonhöhe und Emotion beibehalten werden.
Seed-TTS ermöglicht die Anpassung der Sprechgeschwindigkeit und die freie Steuerung der Audiogeschwindigkeit.
Seed-TTS bietet eine hervorragende Kontrollierbarkeit verschiedener Sprachattribute (z. B. Emotionen) und kann für beliebige Sprecher aus der Praxis hochgradig ausdrucksstarke und vielfältige Sprache erzeugen.
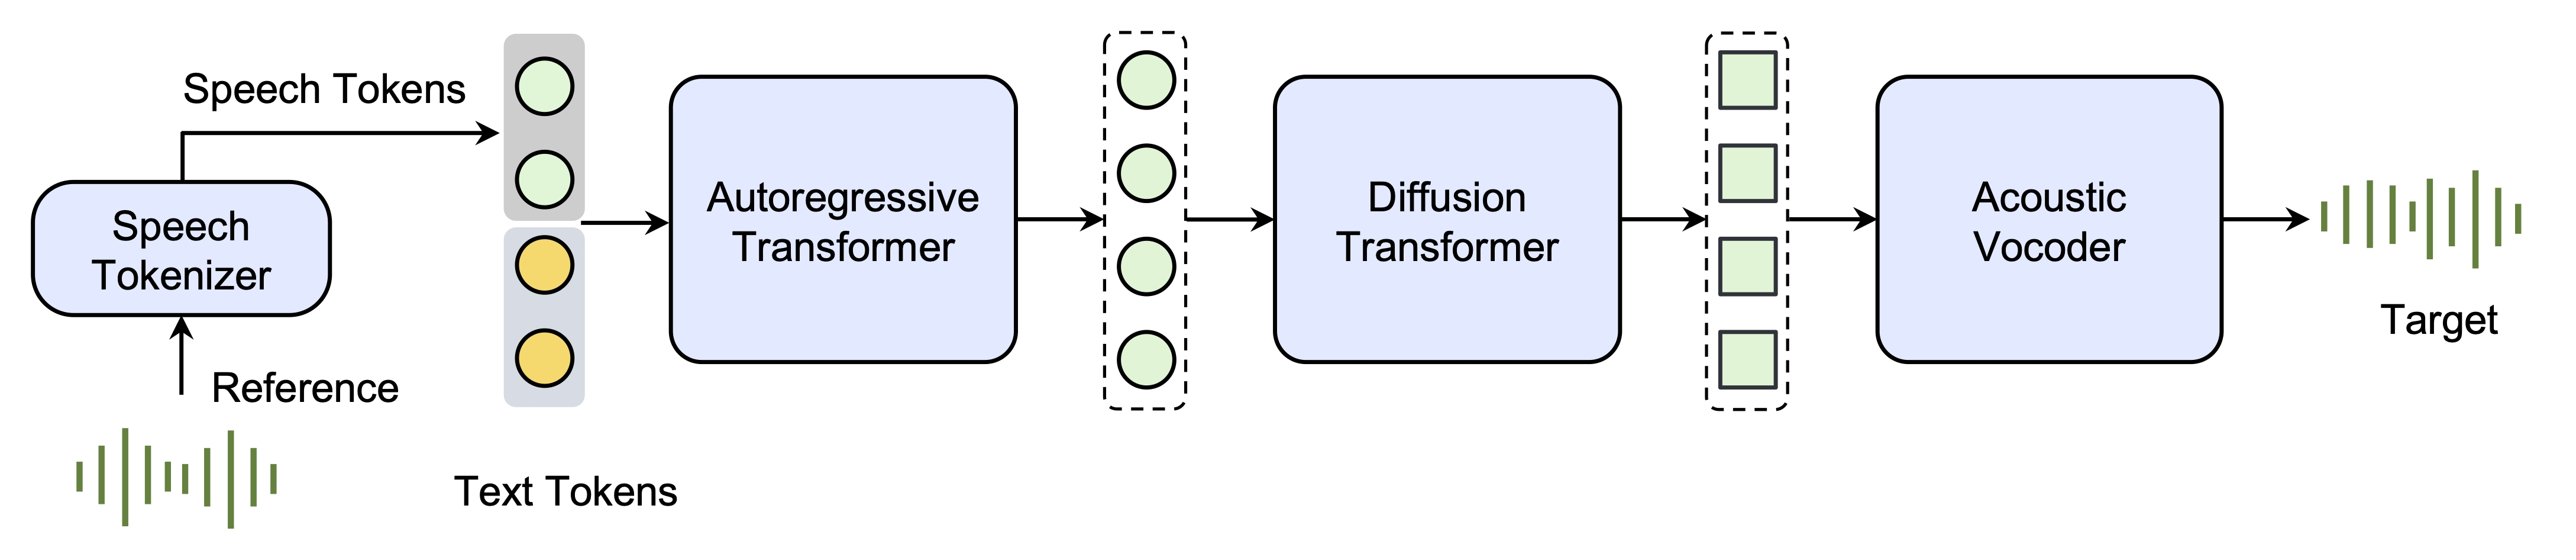
Darüber hinaus stellen wir eine Self-Distillation-Methode zur Sprachzerlegung sowie ein Reinforcement-Learning-Verfahren vor, um die Robustheit des Modells, die Sprecherähnlichkeit und die Kontrollierbarkeit zu verbessern. Außerdem präsentieren wir eine nicht-autoregressive (NAR) Variante des Seed-TTS-Modells mit dem Namen Seed-TTS DiT, die eine vollständig diffusionsbasierte Architektur verwendet. Im Gegensatz zu früheren NAR-basierten TTS-Systemen ist Seed-TTS DiT nicht auf zuvor geschätzte Phonemdauern angewiesen und führt die Spracherzeugung End-to-End durch. Wir zeigen, dass diese Variante in objektiven und subjektiven Bewertungen eine mit der sprachmodellbasierten Variante vergleichbare Leistung erreicht, und demonstrieren ihre Wirksamkeit bei der Sprachbearbeitung.
Paper: https://arxiv.org/abs/2406.02430









