
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
SignLLM: Das erste mehrsprachige Gebärdensprache-Generierungsmodell
小编 ·

SignLLM: Das erste mehrsprachige Gebärdensprache-Generierungsmodell
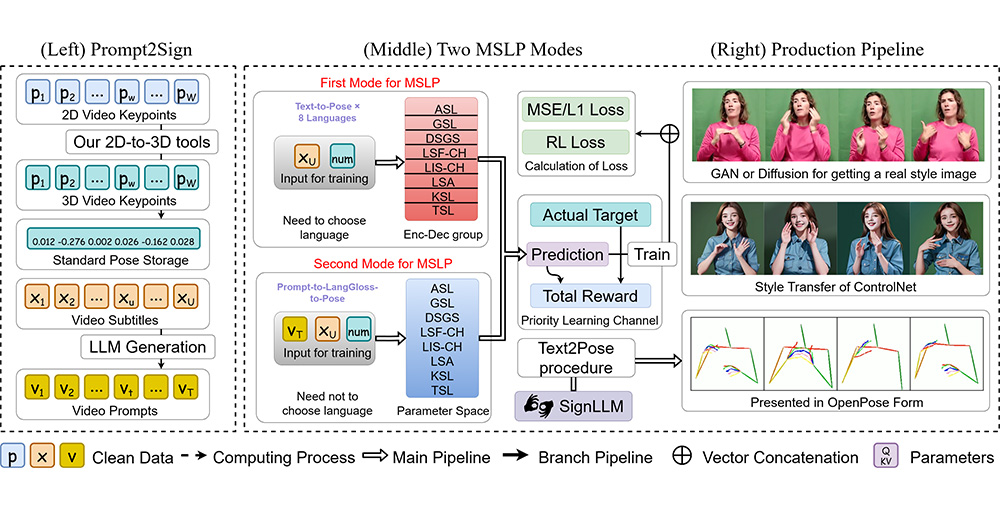
SignLLM, das erste mehrsprachige Gebärdensprache-Generierungsmodell, kann eingegebenen Text oder Eingabeaufforderungen in entsprechende Gebärdensprache-Gesten umwandeln Video. SignLLM nutzt fortschrittliche ai-Technologie, um mehrere Gebärdensprachen zu generieren und zu übersetzen. SignLLM führt den ersten mehrsprachigen Gebärdensprache-Datensatz namens Prompt2Sign ein und entwickelt auf Grundlage dieses Datensatzes mehrere Modelle zur Generierung von Gebärdensprache. Dieser Datensatz wandelt eine große Anzahl von Videos in ein Format um, das für das Training von Modellen geeignet ist, und optimiert das Training von Übersetzungsmodellen wie seq2seq und text2text. Basierend auf diesen Datensatz zeigen wir Benchmark-Ergebnisse von SignLLM, die belegen, dass unser Modell bei der Gebärdensprache-Generierung in acht Gebärdensprachen eine state-of-the-art Leistung erreicht.
Inspiriert von der starken Übersetzungsfähigkeit großer Sprachmodelle (LLMs), die auf umfangreichen mehrsprachigen Textkorpora trainiert wurden, ist es unser Ziel, diese fertigen LLMs für SLT zu nutzen. In diesem Artikel normalisieren wir Gebärdensprache-Videos, um die sprachlichen Merkmale gesprochener Sprache abzubilden, und schlagen ein neuartiges SignLLM-Framework vor, das Gebärdensprache-Videos in sprachähnliche Repräsentationen umwandelt, um die Lesbarkeit für fertige LLMs zu verbessern.
SignLLM enthält zwei Schlüsselmodule:
1. Ein Modul zur visuellen Vektorquantisierung von Symbolen, das symbolische Videos in eine Sequenz diskreter, zeichenebener Symbol-Token umwandelt.
2. Ein Codebuch-Rekonstruktions- und Ausrichtungsmodul, das diese zeichenebenen Token mithilfe einer Optimal-Transport-Formulierung in wortebene Symbolrepräsentationen umwandelt. Ein Verlust für die Symbol-Text-Ausrichtung überbrückt zusätzlich die Lücke zwischen Symbol- und Text-Token und verbessert die semantische Kompatibilität. Wir erzielen state-of-the-art Ergebnisse bei zwei weit verbreiteten SLT-Benchmarks.
SignLLM GITHUB-Adresse: https://signllm.github.io/









