
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Stable Diffusion 3: Welche Verbesserungen und Neuerungen gibt es?
小编 ·

Stable Diffusion 3: Welche Verbesserungen und Neuerungen gibt es?
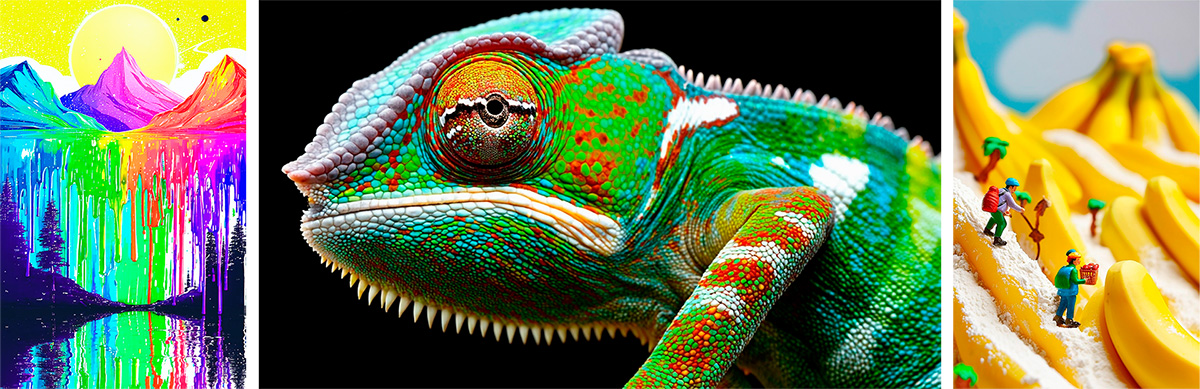
Am Donnerstag kündigte Stability AI die Einführung von Stable Diffusion 3 an, der neuesten und leistungsstärksten Version des Bildgenerierungs-AI-Modells des Unternehmens. Das Modell verwendet eine Diffusions-Transformer-Architektur, die die Leistung bei mehrteiligen Prompts, Bildqualität und Rechtschreibfähigkeit deutlich verbessert.
Stable Diffusion 3 verwendet einen aktualisierten „Diffusion Transformer", eine Technik, die ursprünglich 2022 entwickelt und 2023 überarbeitet wurde und nun Skalierbarkeit ermöglicht. Der beeindruckende Video-Generator Sora von OpenAI folgt offenbar einem ähnlichen Prinzip (Will Peebles, Mitautor der Arbeit, leitet gemeinsam das Sora-Projekt). Die Modellreihe Stable Diffusion 3 (die Textbeschreibungen, sogenannte „Prompts", entgegennimmt und in passende Bilder umwandelt) reicht von 800 Millionen bis 8 Milliarden Parametern. Die Größenpalette ermöglicht es, dass verschiedene Versionen des Modells lokal auf unterschiedlichen Geräten laufen können – vom Smartphone bis zum Server.
Leistungssteigerungen und Verbesserungen von Stable Diffusion 3:
1. Verbesserte Verarbeitung mehrerer Themen: Das neue Modell verbessert deutlich das Verständnis und die Verarbeitung von Prompts, die mehrere Themen oder Elemente enthalten. Dies ermöglicht es den Nutzern, komplexere Szenen in einem einzigen Prompt zu beschreiben, und das Modell kann auf Basis dieser Beschreibungen genauere Bilder erzeugen.
2. Verbesserte Bildqualität: Stable Diffusion 3 erzielt deutliche Verbesserungen bei der Qualität der erzeugten Bilder, einschließlich feinerer Details, genauerer Farbabstimmung und natürlicheren Licht- und Schatteneffekten. Diese Fortschritte lassen die erzeugten Bilder realistischer wirken und die kreativen Absichten der Nutzer besser einfangen.
3. Verbesserte Rechtschreibung und Textverarbeitung: Diese Version zeigt eine bessere Rechtschreib- und Textverständnisfähigkeit bei der Verarbeitung von Bildern mit Textelementen (z. B. Slogans, Beschriftungen). Das bedeutet, dass das Modell Text in Prompts genauer erkennen und wiedergeben kann, auch in komplexen visuellen Kontexten.
4. Einsatz einer neuartigen Diffusion-Transformer-Technik: Stable Diffusion 3 führt eine neuartige Diffusion-Transformer-Technik ein, ähnlich wie Sora, die dem Modell eine leistungsstärkere Bildgenerierungsfähigkeit verleiht. Der Transformer ist ein Deep-Learning-Modell, das speziell dafür entwickelt wurde, Bilddetails schrittweise aufzubauen und so hochwertige visuelle Inhalte zu erzeugen.
5. Flow Matching und weitere technische Verbesserungen: Das Modell integriert Flow Matching und weitere technische Verbesserungen, um die Qualität und Vielfalt der erzeugten Bilder weiter zu steigern. Flow Matching hilft dem Modell, dynamische Elemente und Strukturen in Bildern besser zu verstehen und zu simulieren, sodass die erzeugten Bilder visuell kohärenter und natürlicher wirken.
6. Nutzung der Fortschritte der Transformer-Technologie: Stable Diffusion 3 nutzt die neuesten Fortschritte der Transformer-Technologie voll aus, erweitert nicht nur die Fähigkeiten des Modells, sondern ermöglicht ihm auch die Verarbeitung multimodaler Eingaben. Das bedeutet, dass das Modell komplexere und vielfältigere Datentypen verarbeiten kann, wie z. B. kombinierte Text- und Bildeingaben, und so mehr Flexibilität und Genauigkeit beim Verstehen und Erzeugen von Bildinhalten bietet.
Obwohl bereits einige wichtige technische Innovationen erwähnt wurden, plant Stability AI, in Kürze weitere technische Details zu veröffentlichen. Diese Details werden der Technik-Community und interessierten Nutzern einen tieferen Einblick in die technische Grundlage und die Innovationspunkte von Stable Diffusion 3 bieten.
Obwohl Stable Diffusion 3 noch nicht weit verbreitet ist, gibt Stability an, dass die Nutzer nach Abschluss der Tests die Gewichte kostenlos herunterladen und lokal ausführen können. Stability erklärte: „Wie schon in der Vorschauphase früherer Modelle ist diese Phase äußerst wichtig, um vor der offiziellen Veröffentlichung Feedback zu sammeln, die Leistung zu optimieren und die Sicherheit zu verbessern."
In letzter Zeit hat Stability verschiedene Bildsynthesetechniken erforscht. Neben SDXL und SDXL Turbo hat das Unternehmen letzte Woche Stable Cascade vorgestellt, eine Synthesetechnik, die in einem dreistufigen Prozess Text in Bilder umwandelt. Darüber hinaus wurde auch das weitere Produkt von Stability AI für Text-zu-Video und Bild-zu-Video, Stable Video, in dieser öffentlichen Beta vorgestellt und bietet den Nutzern so mehr Auswahlmöglichkeiten.









