
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
X-UniMotion: Ein Videomodell, das detaillierte Handbewegungen reproduziert
小编 ·

X-UniMotion: Ein Videomodell, das detaillierte Handbewegungen reproduziert
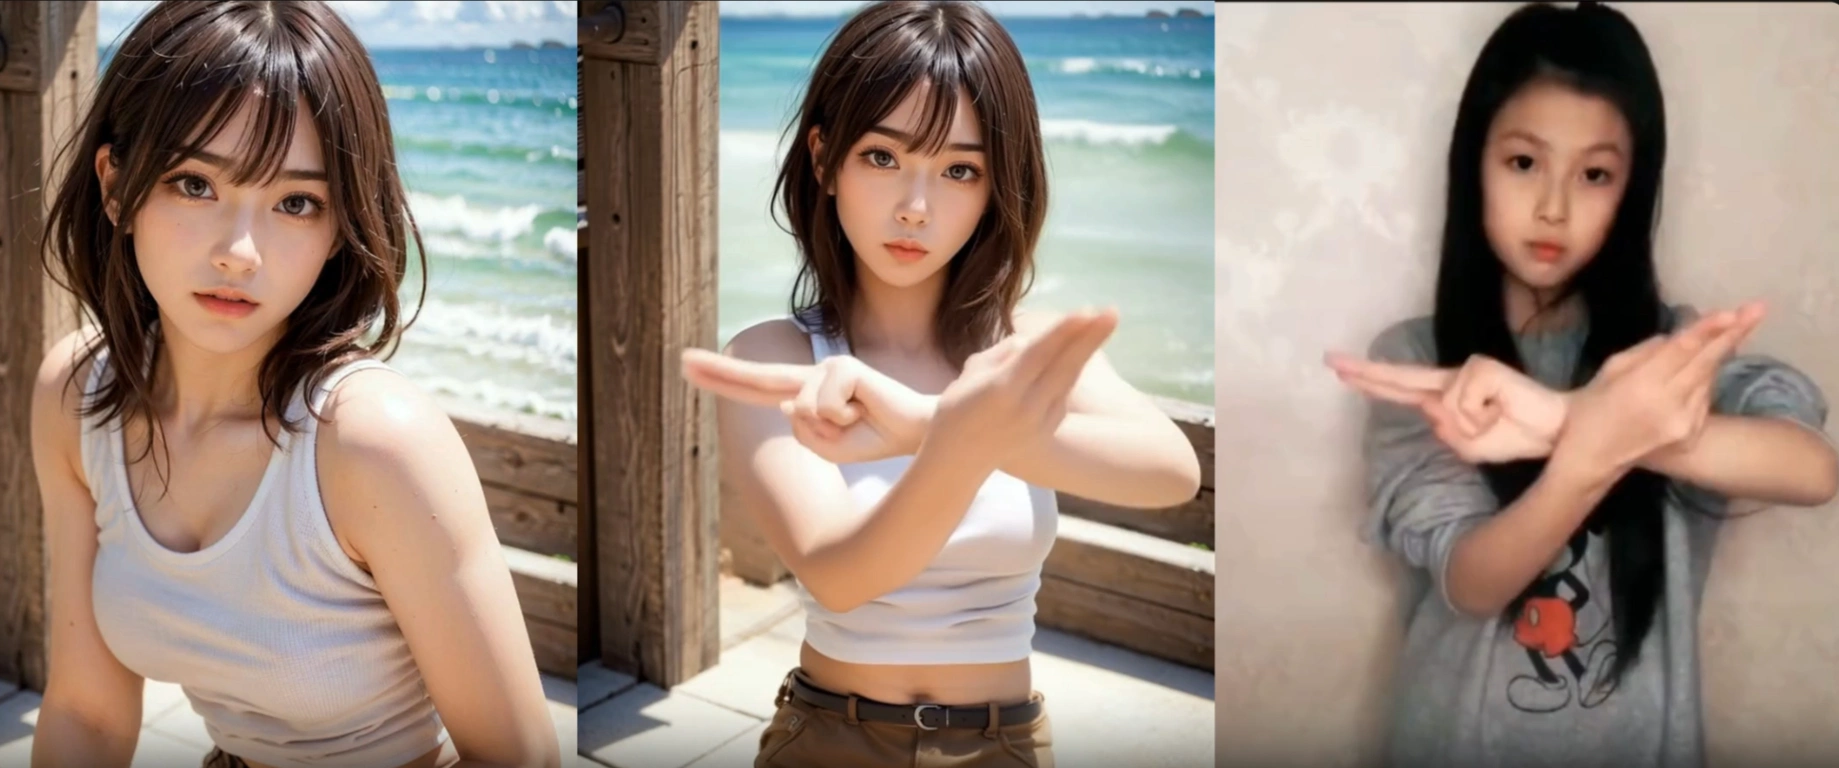
X-UniMotion ist ein Video-Modell, das Handbewegungen reproduzieren kann. Nach Eingabe einer Referenzperson und eines Bewegungsvideos kann es die Referenzperson die gleichen Bewegungen präzise ausführen lassen und eignet sich so für komplexe Handmanipulationen. Sein technischer Vorteil liegt in der hochgradigen Wiedergabe von Handdetails, wobei die Bewegungen präzise und flüssig sind.
Funktionsmerkmale
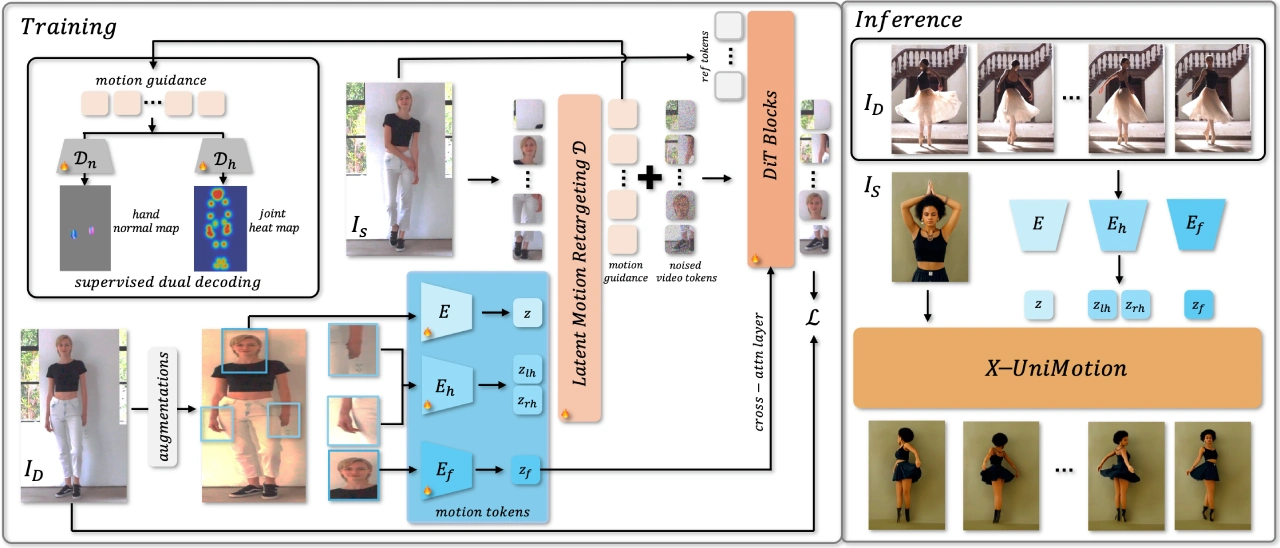
End-to-End-Training: X-UniMotion wird End-to-End trainiert, lernt latente Darstellungen von Ganzkörperbewegungen und erzeugt mithilfe des DiT-Netzwerks realistische Videos.
Feine Bewegungserfassung: Erfasst präzise lokale Detailbewegungen wie Hände und Gesicht.
Identitätsunabhängige Darstellung: Durch räumliche und farbliche Erweiterungen werden Identitätshinweise von Bewegungs-Latent-Variablen getrennt, um eine identitätsunabhängige Bewegungsdarstellung zu erreichen.
Hochwertige Animationserzeugung: Die erzeugten Animationen sind realistisch und bewegungskonsistent und ähneln dem Referenzbild in hohem Maße.
X-UniMotion-Technologie
Bild-Encoder: Extrahiert aus dem Referenzbild latente Bewegungsdeskriptoren für Ganzkörpergelenke sowie lokale Deskriptoren für Hände und Gesicht.
ViT-Decoder: Verortet die Bewegungsdeskriptoren neu auf der Körperstruktur des Referenzsubjekts und gibt räumliche Bewegungsanleitungen aus.
DiT-Netzwerk: Kombiniert räumliche Bewegungsanleitungen, verrauschte Video-Latent-Variablen und Referenzbild-Latent-Variablen, um die finale Animation zu erzeugen.
Cross-Attention-Schichten: Injizieren latente Gesichtsbewegungen in das DiT-Netzwerk, um die Ausdruckssteuerung zu ermöglichen.
Anwendungsszenarien
Film- und Fernsehproduktion: Wird zur Erzeugung von Charakteranimationsbewegungen verwendet, spart Kosten und verbessert die Qualität visueller Effekte.
Animationsproduktion: Erzeugt schnell hochwertige Animationsclips und steigert die Produktionseffizienz.
Spieleentwicklung: Lässt Spielfigurenbewegungen natürlicher und realistischer wirken und verstärkt das Eintauchen.
Online-Bildung: Erzeugt detaillierte Bewegungsdemonstrationsvideos und unterstützt den Unterricht in Handwerk, Instrumentenspiel usw.
Virtuelles Labor: Simuliert experimentelle Abläufe und unterstützt Schüler beim Lernen.
Sprachenlernen: Erzeugt Lehrvideos zu Sprachgesten wie Gebärdensprache und hilft Schülern beim Lernen.
Rehabilitationstraining: Erzeugt Rehabilitationsbewegungsvideos und unterstützt Patienten beim Hand- und Gesichtsrehabilitationstraining.
Operationssimulation: Erzeugt detaillierte Videos zu Operationsabläufen und hilft Ärzten, chirurgische Techniken zu erlernen.
Psychotherapie: Erzeugt Videos zu Ausdrucksbewegungen und hilft Patienten, Emotionen zu erlernen und auszudrücken.
Virtuelle Assistenten: Erzeugt Animationsbewegungen für virtuelle Assistenten und verbessert die Natürlichkeit der Interaktion.
VR/AR: Erzeugt Animationsbewegungen virtueller Charaktere und verbessert das Interaktionserlebnis in virtuellen Umgebungen.
Gestenerkennung: Erzeugt detaillierte Handbewegungsbeispiele zum Trainieren von Gestenerkennungsmodellen.
Verwendung
Eingabedaten: Es werden ein Referenzbild und ein Bewegungsvideo benötigt.
Extraktion der Bewegungsdeskriptoren: Aus dem Referenzbild werden latente Bewegungsdeskriptoren für Ganzkörpergelenke sowie lokale Deskriptoren für Hände und Gesicht extrahiert.
Bewegungsverortung: Die Bewegungsdeskriptoren werden auf die Körperstruktur des Referenzsubjekts neu verortet.
Animationserzeugung: Bewegungsanleitungen, verrauschte Video-Latent-Variablen und Referenzbild-Latent-Variablen werden kombiniert und in das DiT-Modell zur Animationserzeugung eingespeist.
Ausdruckssteuerung: Latente Gesichtsbewegungen werden in das DiT-Netzwerk injiziert, um die Ausdruckssteuerung zu realisieren.









