
 Asistente de guiones▸
 Apps AI
 Noticias AI
Xiaomi MiMo: el primer LLM de razonamiento de código abierto de Xiaomi
小编 ·

Xiaomi MiMo: el primer LLM de razonamiento de código abierto de Xiaomi
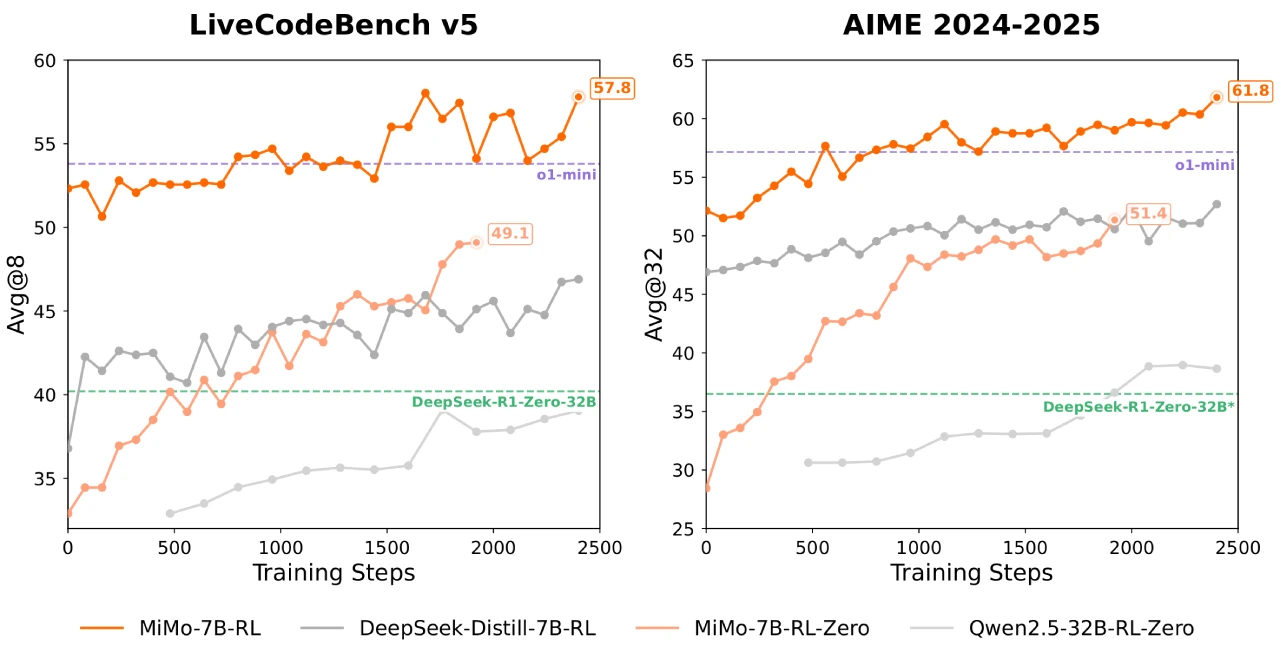
Xiaomi MiMo es el primer modelo grande de IA diseñado para razonamiento, anunciado como código abierto por Xiaomi el 30 de abril de 2025. La serie de modelos MiMo - 7B explora a fondo el potencial de razonamiento de los modelos de lenguaje, prestando atención no solo al post-entrenamiento, sino también a las estrategias de pre-entrenamiento orientadas al razonamiento. Esta serie de modelos, con un tamaño relativamente reducido de 7B, demuestra capacidades de razonamiento que superan a muchos modelos de 32B, y el MiMo - 7B - RL alcanza un rendimiento comparable al de OpenAI o1 - mini en tareas de razonamiento matemático y de código.
Características principales de MiMo
Pre-entrenamiento
Optimización del preprocesamiento de datos: mejora del paquete de herramientas de extracción de texto, adopción de filtrado de datos multidimensional y aumento de la densidad de patrones de razonamiento en los datos de pre-entrenamiento.
Generación de datos sintéticos: se utilizan múltiples estrategias para generar una gran cantidad de datos sintéticos de razonamiento diversificados.
Mezcla de datos en tres fases: el pre-entrenamiento adopta una estrategia de mezcla de datos en tres fases; MiMo - 7B - Base se pre-entrena con aproximadamente 25 billones de tokens.
Predicción de múltiples tokens: se introduce la predicción de múltiples tokens como objetivo de entrenamiento adicional, mejorando el rendimiento del modelo y acelerando la inferencia.
Post-entrenamiento
Datos de entrenamiento de alta calidad: se seleccionan cuidadosamente 130K problemas de matemáticas y código como datos de entrenamiento RL; cada problema se somete a una limpieza minuciosa y a una evaluación de dificultad, y se utilizan verificadores basados en reglas para garantizar la calidad de los datos.
Mecanismo de recompensa por código: para problemas de código desafiantes, se introduce una recompensa por código driven by test difficulty, que asigna puntuaciones detalladas a casos de prueba de distinta dificultad, optimizando la estrategia.
Re-muestreo de datos: se aplica una estrategia de re-muestreo para problemas sencillos, mejorando la eficiencia del muestreo continuo y estabilizando las actualizaciones de la estrategia.
Infraestructura RL
Motor de rollout sin interrupciones: se ha desarrollado un motor de rollout sin interrupciones que integra rollout continuo, cálculo asíncrono de recompensas y finalización anticipada, reduciendo el tiempo de inactividad de la GPU y logrando una aceleración de 2,29 veces en el entrenamiento y de 1,96 veces en la validación.
Soporte de MTP: se ofrece soporte para MTP en vLLM y se mejora la robustez del motor de inferencia en el sistema RL.
Versiones del modelo MiMo
MiMo - 7B - Base: modelo base con un potencial de razonamiento excepcional.
MiMo - 7B - RL - Zero: modelo RL entrenado a partir del modelo base.
MiMo - 7B - SFT: modelo SFT entrenado a partir del modelo base.
MiMo - 7B - RL: modelo RL entrenado a partir del modelo SFT, con un rendimiento comparable al de OpenAI o1 - mini.
Detalles técnicos e innovaciones
Optimización de los datos de pre-entrenamiento: mediante el filtrado multidimensional de datos y la generación de datos sintéticos de razonamiento, se mejora la calidad de los datos de pre-entrenamiento y la densidad de patrones de razonamiento.
Módulo MTP: se introduce el módulo MTP en el pre-entrenamiento, lo que mejora significativamente el rendimiento y la velocidad de inferencia en tareas de razonamiento.
Infraestructura RL: se ha desarrollado el Seamless Rollout Engine, que acelera los procesos de entrenamiento y validación RL, logrando mejoras de velocidad de 2,29 y 1,96 veces, respectivamente.
Mecanismo de recompensa basado en la dificultad de las pruebas: para abordar el problema de las recompensas dispersas en problemas de código, se propone un mecanismo de recompensa basado en la dificultad de las pruebas, mejorando la eficiencia de aprendizaje del modelo en problemas difíciles.
Experimentos y resultados
Rendimiento del modelo de pre-entrenamiento
MiMo-7B-Base: supera a otros modelos de código abierto con 7B parámetros en múltiples pruebas de referencia, como BBH, SuperGPQA, entre otras.
Evaluación del potencial de razonamiento: se utiliza la métrica pass@k para evaluar el potencial de razonamiento del modelo; MiMo-7B-Base muestra puntuaciones pass@k más altas en todas las pruebas de referencia.
Rendimiento del modelo de post-entrenamiento
MiMo-7B-RL-Zero: entrenado con RL directamente a partir de MiMo-7B-Base, demuestra potentes capacidades de razonamiento.
MiMo-7B-RL: entrenado con RL a partir del modelo SFT, finalmente supera al modelo o1-mini de OpenAI en tareas de matemáticas y código.
Rendimiento específico:
En AIME 2025, MiMo-7B-RL obtiene 55,4 puntos, superando a o1-mini en 4,7 puntos.
En LiveCodeBench v5 y v6, MiMo-7B-RL supera significativamente a o1-mini.
Enlaces relacionados
Plataforma Hugging Face:https://huggingface.co/XiaomiMiMo
Repositorio de GitHub:https://github.com/XiaomiMiMo/MiMo
Informe técnico:https://github.com/XiaomiMiMo/MiMo/blob/main/MiMo-7B-Technical-Report.pdf









