
 脚本プランナー▸
 AIアプリ
 AIニュース
Versatile-OCR-Program:試験問題などの複雑な資料から構造化データを抽出するOCR
小编 ·

Versatile-OCR-Program:試験問題などの複雑な資料から構造化データを抽出するOCR
Versatile-OCR-Programとは?
Versatile-OCR-Programは、機械学習の学習最適化に特化したOCRシステムであり、複雑な教育資料(試験問題など)から構造化データを抽出し、JSONまたはMarkdown形式で出力することができます。日本語、韓国語、英語に対応し、その他の言語、数学の公式、表、グラフ、図表にも拡張可能です。また、意味的な注釈をつけて自然言語の説明を生成することもできます。
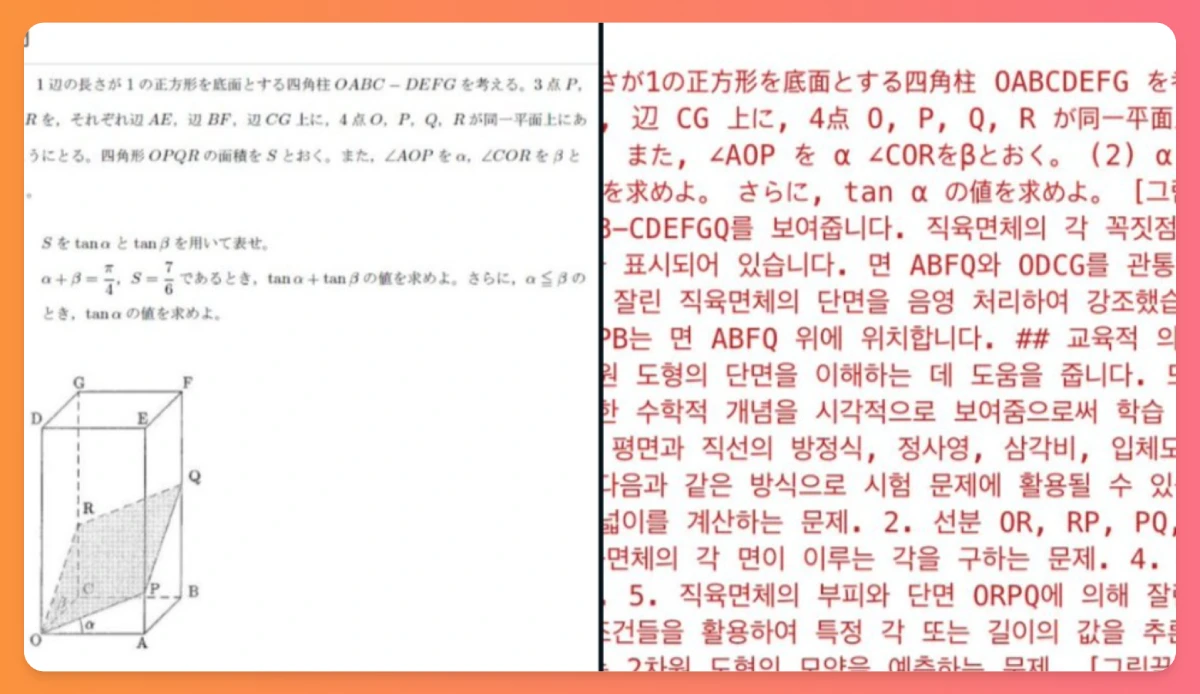
Versatile-OCR-Programの主な特徴
機械学習の学習最適化:抽出された要素(グラフ、表、図形など)はセマンティックアノテーションが行われ、視覚コンテンツの自然言語による説明が自動生成され、下流のモデル学習を強化します。
多言語サポート:日本語、韓国語、英語に対応しており、その他の言語にも容易にカスタマイズ可能です。
構造化された出力:数学式の人間が読める説明、表の要約、グラフのタイトルを含め、AIレディな出力をJSONまたはMarkdown形式で生成します。
高精度:EJU生物や東京大学数学などの実世界の学術データセットにおいて、90%~95%の精度を達成します。
複雑なレイアウトのサポート:密集した科学的な内容、式が密集した段落、豊富な視覚要素を含む試験形式のPDFを正確に処理できます。
技術実装:DocLayout-YOLO、Google Vision API、Gemini Pro Vision、MathPix OCR、OpenAI API、OpenCVなどの技術を使用しています。
出力サンプル
実際の出力サンプルが提供されており、数学や生物の問題の入力画像と変換後の出力画像、および英語翻訳による意味的な文脈と抽出されたデータが含まれています。
数学問題のサンプル:幾何学图形と角度を含む画像から情報を抽出し、関連する説明と問題を生成する方法を紹介します。
生物問題のサンプル:玉ねぎの根尖細胞の有糸分裂の過程を示す画像から情報を抽出し、関連する説明と問題を生成する方法を紹介します。
Versatile-OCR-Programの使用手順
ステップ1:初期OCR抽出:ocr_stage1.pyスクリプトを実行し、入力PDFから生の要素(テキスト、表、図形など)を抽出し、レイアウト検出を実行して中間結果を保存します。
ステップ2:意味的解釈と最終出力:ocr_stage2.pyスクリプトを実行し、中間データを処理して構造化された人間が読める出力に変換します。これには自然言語による説明や要約の生成、コンテンツをAIレディ形式(JSON/Markdown)に整理することが含まれます。
技術実装
テーブル処理の最適化:DocLayout-YOLOを使用してテーブル領域を検出し、Google Vision OCRを使用してテーブル処理を行います(日本語のテキストに対してより効果的です)。さらに、テーブル構造を構造化されたJSON形式で保持します。
画像および特殊領域の処理:Google Vision APIの画像分析機能を使用して画像領域を処理し、Google Cloud Vision APIを使用して画像の説明を生成し、Google Cloud Vision APIのドキュメント分析機能を使用してグラフ/図表を処理し、処理結果を構造化されたJSON形式で保存します。
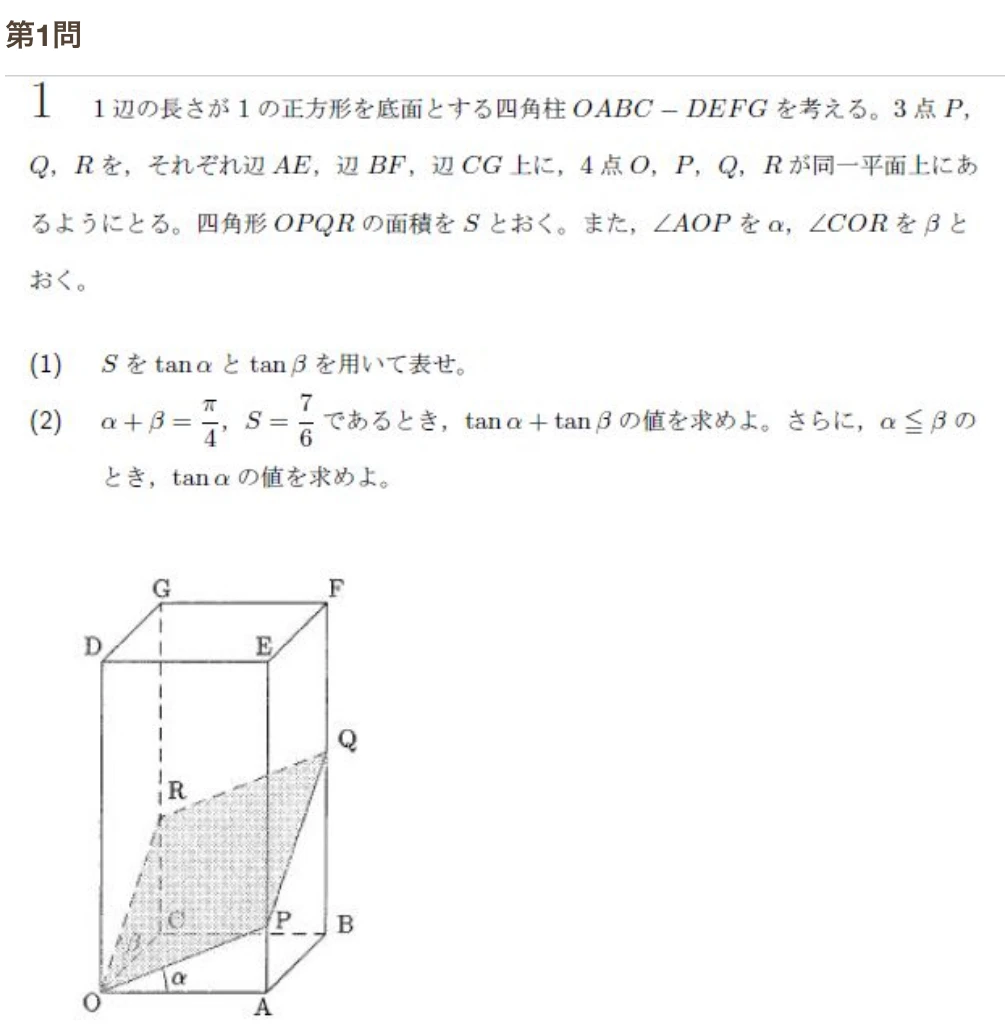
入力効果
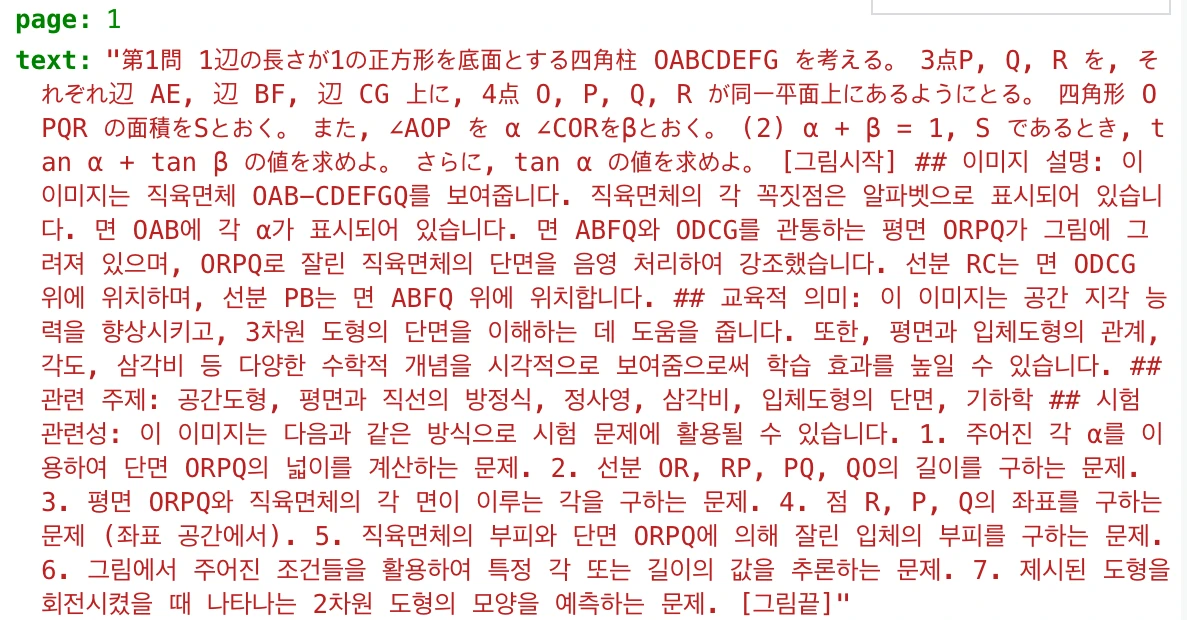
出力効果
Versatile-OCR-Programの応用
教育分野:試験問題や学術論文などの教育資料からデータを抽出・整理し、教育研究や学習を支援するために使用されます。
機械学習の学習:特に教育分野への応用において、質の高い学習データセットを生成し、機械学習モデルの学習に使用されます。
多言語ドキュメント処理:国際的な学術交流や多言語教育資料のデジタル化など、複数言語のドキュメント処理が必要なシナリオに適しています。
githubプロジェクト:https://github.com/ses4255/Versatile-OCR-Program









